OpenClaw Fenêtre de contexte et diagnostic de la limitation de débit
Distinguer la limitation de débit 429, le dépassement de contexte et les erreurs de métadonnées de modèle local, puis ajuster en toute sécurité contextWindow, contextTokens et maxTokens.
D'abord, identifier le type d'erreur
API rate limit reached correspond généralement à une limite 429 renvoyée par la passerelle amont, à une limitation de concurrence ou à un quota épuisé ; on ne peut pas juger à partir de cette seule phrase qu'il s'agit d'un problème de configuration de contexte 16k. Vérifiez d'abord le code d'état et l'erreur brute, puis décidez si la configuration doit être modifiée.
| Phénomène | Cause la plus probable | Que faire en premier |
|---|---|---|
429、rate_limit、quota、too many requests | Limitation de débit amont, concurrence ou quota insuffisant | Réduire la concurrence et réessayer plus tard, vérifier le quota et l'état de la passerelle amont |
context_length_exceeded, requête trop volumineuse, dépassement de l'entrée | L'entrée ajoutée à la sortie réservée dépasse la limite du modèle ou de la passerelle | Raccourcir la conversation, activer la compression, puis revérifier la configuration du contexte |
| OpenClaw fenêtre locale d'invite trop petite | Métadonnées du modèle personnalisé manquantes ou ancienne configuration résiduelle | Vérifier contextWindow、contextTokens、maxTokens |
| Un seul modèle échoue | Problème de routage du modèle ou de paramètres de ce modèle | Avec la même clé et le même Base URL, essayer une requête minimale avec un autre modèle |
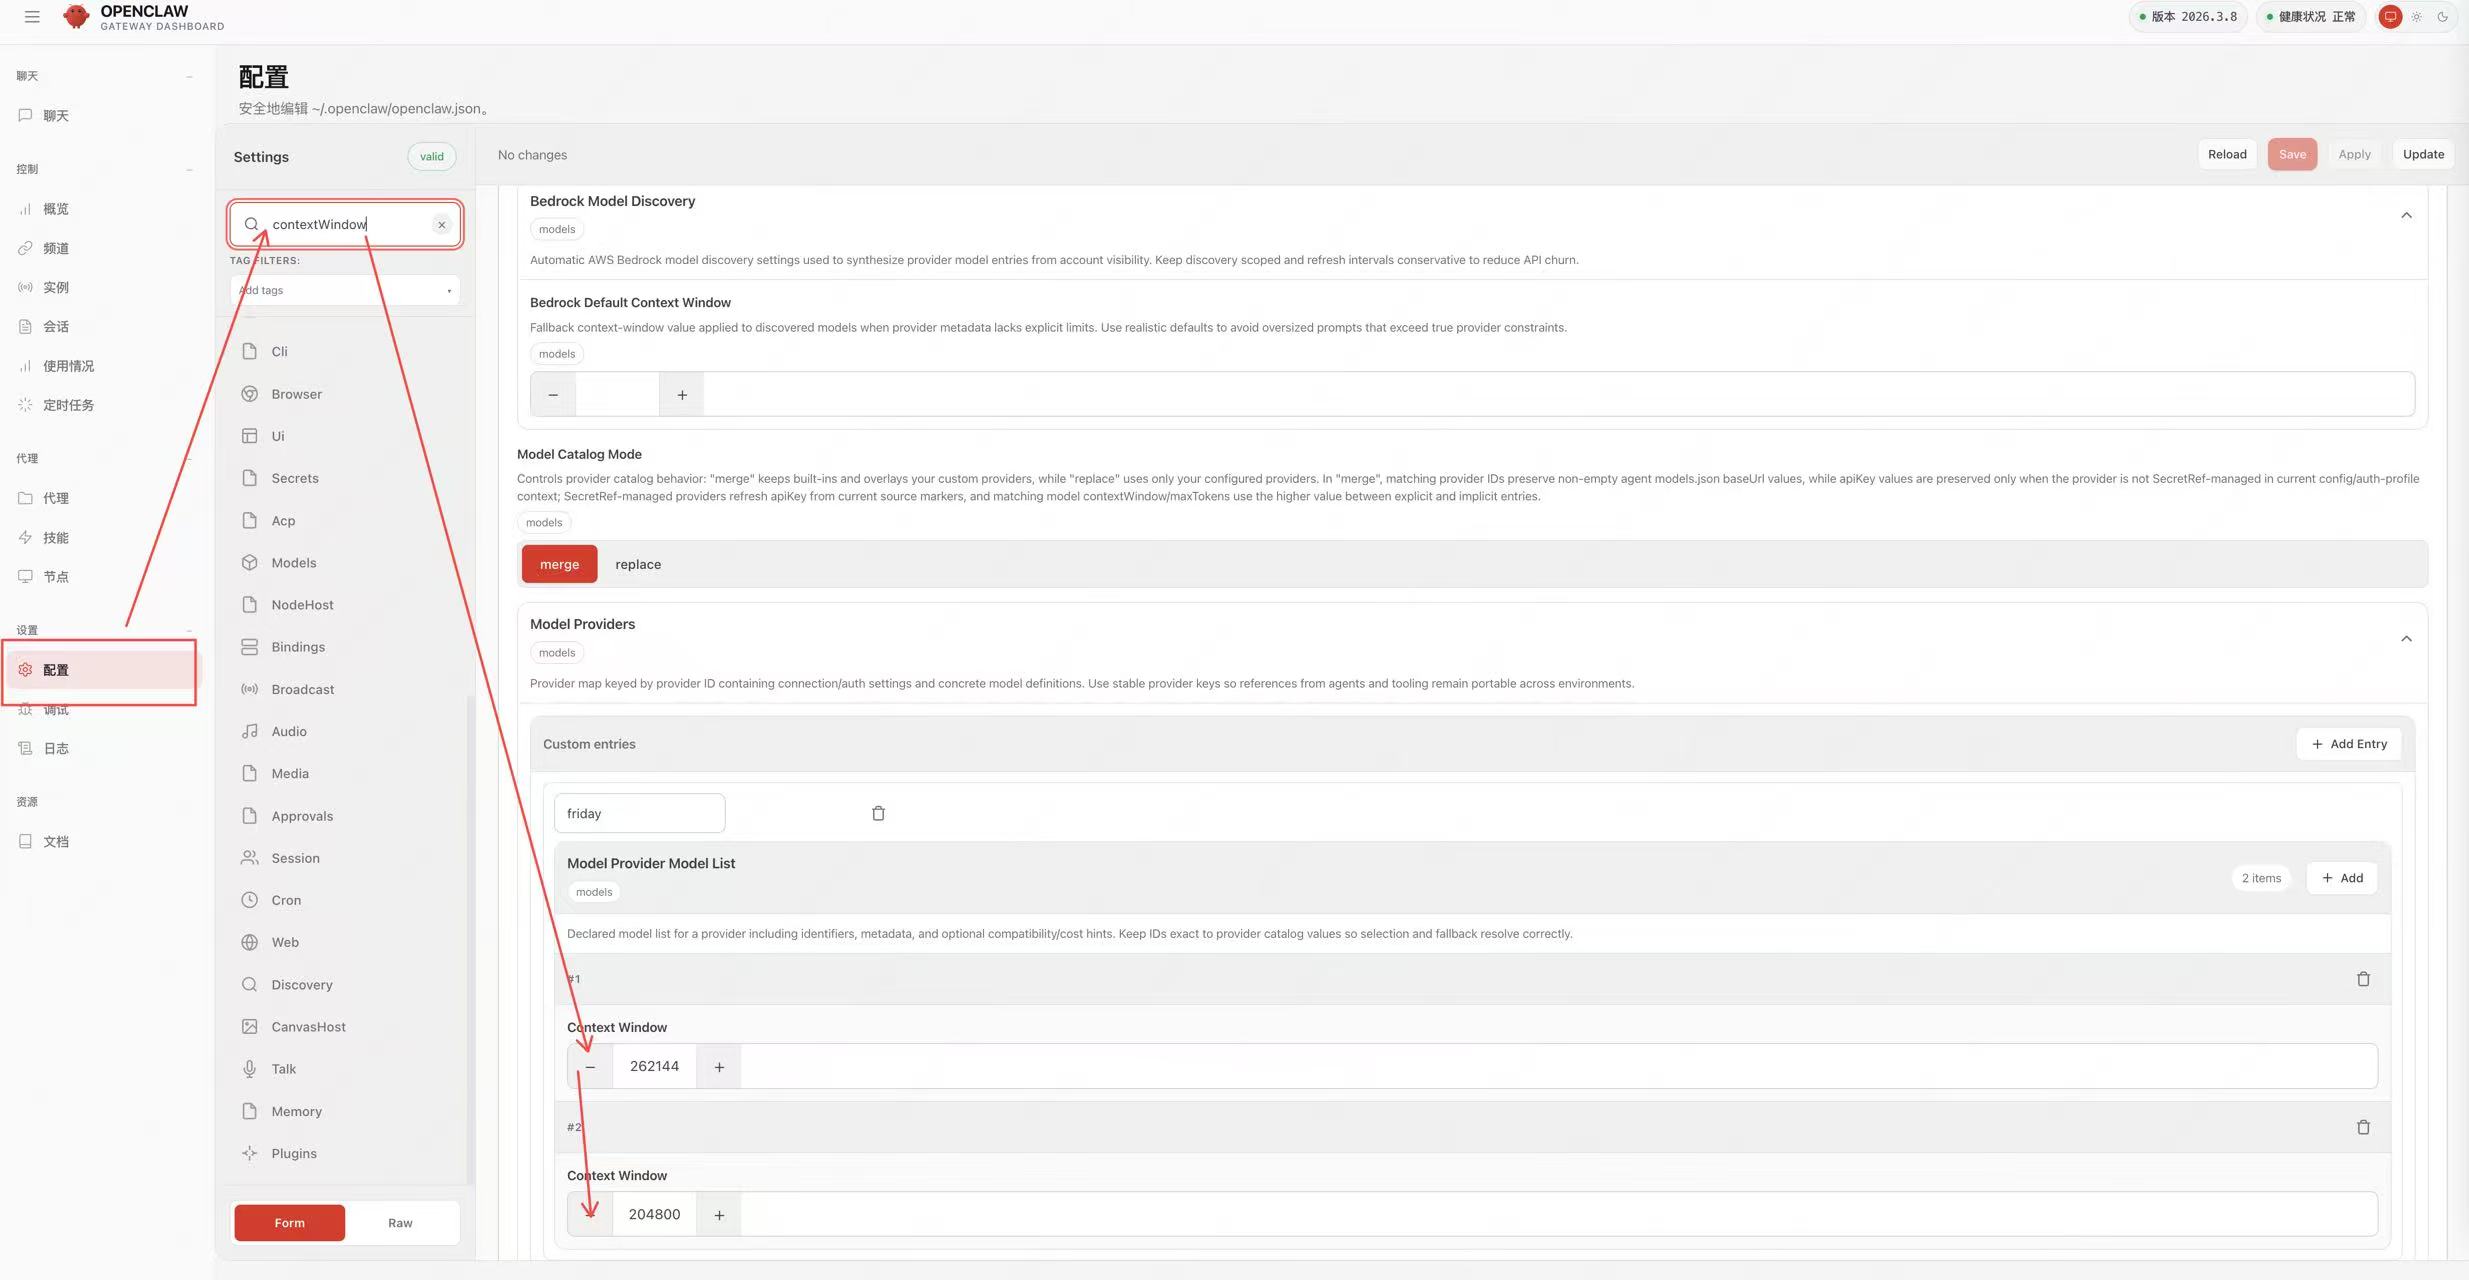 OpenClaw Emplacement de Model Window dans la page de paramètres. Les nom…
Que représentent les trois champs
contextWindow: métadonnées de la fenêtre de contexte native du modèle.contextTokens: limite en entrée OpenClaw réellement autorisée, qui peut être inférieure à la fenêtre native.maxTokens: limite maximale de tokens de sortie pour une réponse unique, pas la taille totale du contexte.
N'inscrivez pas arbitrairement 1M pour « obtenir un contexte plus large ». Les valeurs saisies doivent correspondre simultanément aux capacités du modèle, aux limites de routage actuelles de LLM API Gateway et à la version du client.
Emplacement de la configuration
La configuration principale se trouve généralement dans :
~/.openclaw/openclaw.jsonLors d'une configuration par Agent distinct, elle se trouve généralement dans :
~/.openclaw/agents/<agentId>/agent/models.jsonSi OPENCLAW_AGENT_DIRest défini, recherchez la configuration de l'Agent correspondant dans ce répertoire.
Exemple de modification sûre
Les valeurs ci-dessous illustrent uniquement la relation entre les champs, pas les limites réelles de tous les modèles. Vérifiez d'abord les valeurs dans la liste des modèles de ce site et dans la documentation de routage actuelle :
{
  models: {
    mode: "merge",
    providers: {
      guishu: {
        baseUrl: "https://api.llm-token.cn/v1",
        apiKey: "YOUR_API_KEY",
        api: "openai-completions",
        models: [
          {
            id: "YOUR_MODEL_ID",
            name: "YOUR_MODEL_ID",
            contextWindow: 128000,
            contextTokens: 96000,
            maxTokens: 8192,
            input: ["text"]
          }
        ]
      }
    }
  }
}
Réservez une partie de la fenêtre pour l'invite système, les résultats d'outils et la sortie du modèle. Si la passerelle amont n'autorise qu'une entrée ou sortie plus petite, réduisez encore ; ne vous contentez pas d'inscrire les valeurs annoncées par le fabricant du modèle.
Ordre de modification et de vérification
- Sauvegardez le fichier de configuration actuel ; n'écrasez pas directement la seule copie.
- Modifiez uniquement l'entrée du provider et du modèle en cours ; conservez le reste de la configuration.
- Exécutez
openclaw models listet confirmez que le modèle est reconnu. - Exécutez
openclaw models set guishu/YOUR_MODEL_IDet confirmez que le provider/model sélectionné est correct. - Redémarrez la passerelle :
openclaw gateway restart. - Envoyez d'abord une requête de test très courte, puis augmentez progressivement le contexte.
Si une requête courte renvoie également 429, agrandir davantage la fenêtre de contexte n'aidera pas ; orientez-vous vers la concurrence, le quota du compte et l'état de la passerelle amont. Si seules les requêtes longues échouent, vérifiez alors la longueur de l'entrée, la stratégie de compression et les trois champs de contexte.
Les captures de configuration et les journaux peuvent contenir des clés API. Avant de soumettre au support, masquez les clés complètes et conservez uniquement l'heure de l'erreur, le code d'état, l'ID du modèle et l'ID de la requête.