OpenClaw Diagnóstico de janela de contexto e rate limiting
Distinguir rate limiting, estouro de contexto e erros de metadados de modelo local do 429 antes de ajustar contextWindow, contextTokens e maxTokens com segurança.
Identifique o tipo de erro primeiro
API rate limit reached geralmente indica que o upstream retornou 429, limite de concorrência ou limite de cota; essa mensagem por si só não permite concluir que o problema é a configuração de contexto do 16k. Verifique o código de status e o erro original antes de decidir se vai alterar a configuração.
| Sintoma | Causa mais provável | O que fazer primeiro |
|---|---|---|
429, rate_limit, quota, too many requests | Rate limiting, concorrência ou cota insuficiente no upstream | Reduza a concorrência e tente novamente mais tarde; verifique a cota e o status do upstream |
context_length_exceeded, requisição grande demais, entrada excede o limite | Entrada mais saída reservada ultrapassa o limite do modelo ou do gateway | Encurte a conversa, ative a compactação e revise a configuração de contexto |
| Janela de prompt local pequena demais no OpenClaw | Metadados do modelo personalizado ausentes ou configuração antiga residual | Verifique contextWindow, contextTokens, maxTokens |
| Apenas um modelo falha | Roteamento do modelo ou problema de parâmetros desse modelo | Use a mesma Key e Base URL com outro modelo para uma requisição mínima |
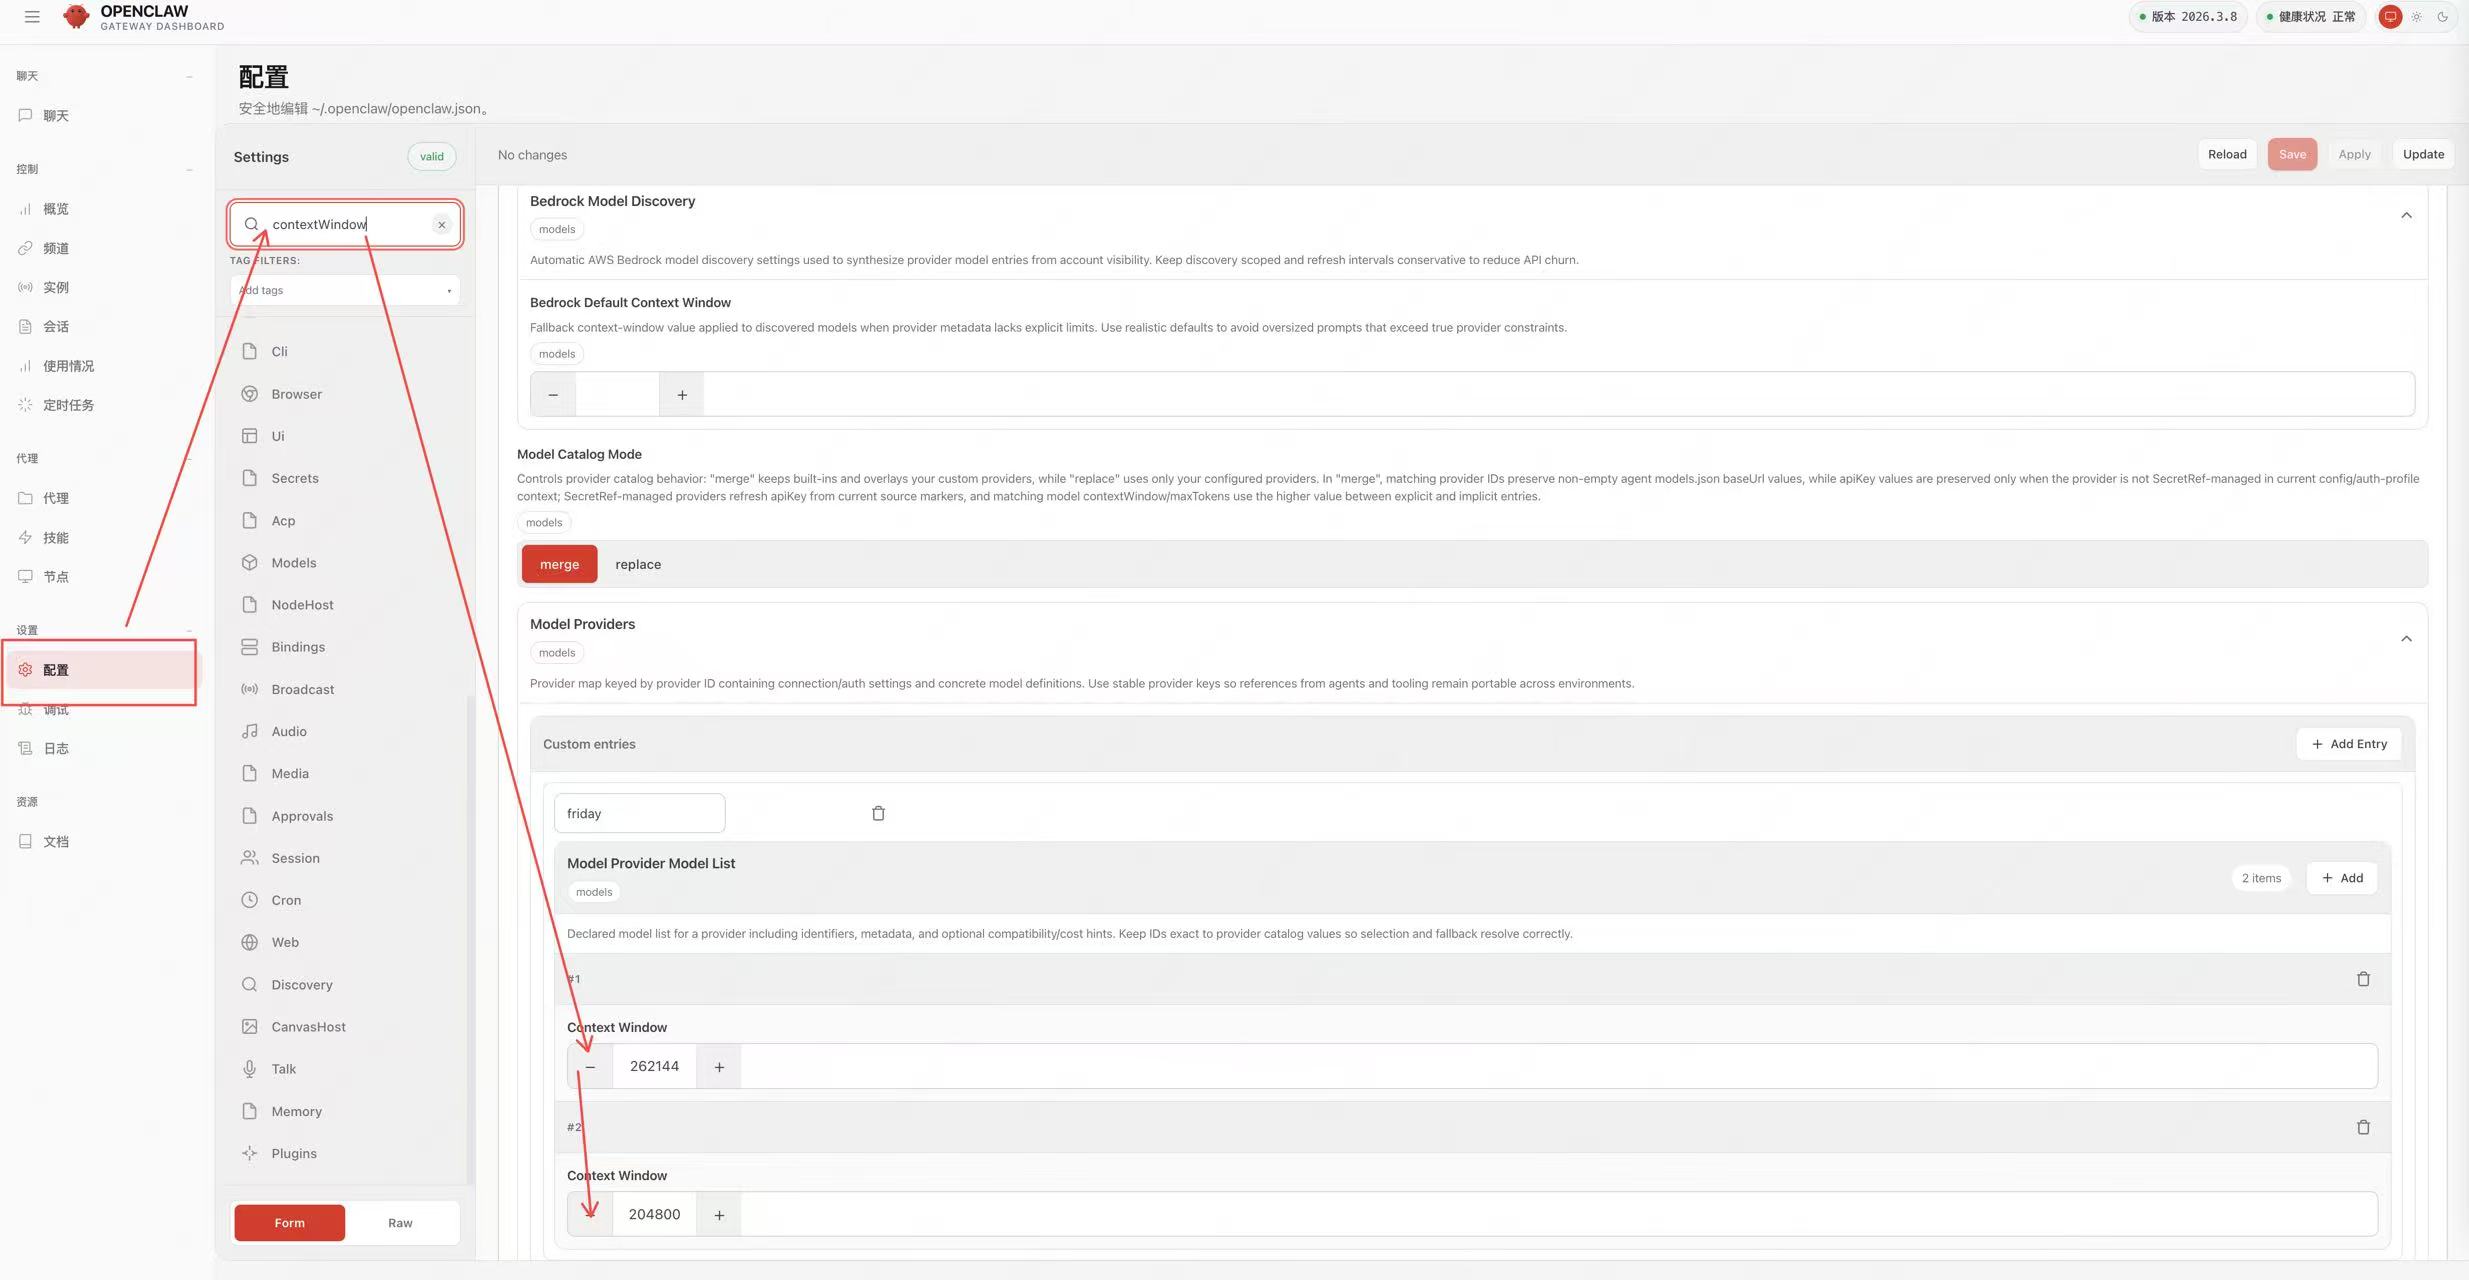 Posição do Model Window na página OpenClaw de configurações. Os nomes ex…
O que cada um dos três campos representa
contextWindow: metadados da janela de contexto nativa do modelo.contextTokens: limite superior que o OpenClaw permite efetivamente para entrada; pode ser menor que a janela nativa.maxTokens: limite máximo de tokens de saída por resposta; não é o tamanho total do contexto.
Não preencha 1M arbitrariamente para "obter mais contexto". Os valores devem respeitar, ao mesmo tempo, a capacidade do modelo, os limites atuais de roteamento do LLM API Gateway e a versão do cliente.
Localização da configuração
O arquivo de configuração principal costuma ficar em:
~/.openclaw/openclaw.jsonPara configurar por Agent separadamente, costuma ficar em:
~/.openclaw/agents/<agentId>/agent/models.jsonSe OPENCLAW_AGENT_DIR estiver definida, procure a configuração do Agent nesse diretório.
Exemplo de alteração segura
Os valores abaixo apenas ilustram a relação entre os campos e não representam o limite real de todos os modelos. Confirme os valores na lista de modelos do site e na descrição de roteamento atual antes de prosseguir:
{
  models: {
    mode: "merge",
    providers: {
      guishu: {
        baseUrl: "https://api.llm-token.cn/v1",
        apiKey: "YOUR_API_KEY",
        api: "openai-completions",
        models: [
          {
            id: "YOUR_MODEL_ID",
            name: "YOUR_MODEL_ID",
            contextWindow: 128000,
            contextTokens: 96000,
            maxTokens: 8192,
            input: ["text"]
          }
        ]
      }
    }
  }
}
Reserve parte da janela para o prompt do sistema, resultados de ferramentas e saída do modelo. Se o upstream permitir apenas entradas ou saídas menores, reduza ainda mais; não preencha apenas com base nos valores divulgados pelo fabricante do modelo.
Ordem de alteração e verificação
- Faça backup do arquivo de configuração atual; não sobrescreva a única cópia.
- Altere apenas as entradas do provider e do modelo atuais; preserve as demais configurações.
- Execute
openclaw models liste confirme que o modelo foi reconhecido. - Execute
openclaw models set guishu/YOUR_MODEL_IDe confirme que o provider/model selecionado está correto. - Reinicie o gateway:
openclaw gateway restart. - Envie primeiro uma requisição de teste bem curta e, em seguida, aumente o contexto gradualmente.
Se mesmo requisições curtas retornarem 429, aumentar a janela de contexto não ajuda; passe a verificar concorrência, cota da conta e status do upstream. Se apenas requisições longas falharem, revise o tamanho da entrada, a estratégia de compactação e os três campos de contexto.
Capturas de tela de configuração e logs podem conter a Key API. Antes de enviar ao suporte, oculte a Key completa e mantenha apenas o horário do erro, o código de status, o ID do modelo e o ID da requisição.
Tutorial de configuração da versão web para geração de imagens
Ideal para iniciantes que não querem lidar com parâmetros de API e preferem configurar tudo diretamente na versão web.
Perguntas frequentes
Reúne as dúvidas de uso mais frequentes, informações sobre protocolos e explicações sobre o modelo padrão.