Qwen3.8-Omni-Flash veröffentlicht: Fähigkeiten, API und Leitfaden für Audio-Video-Agenten
Das multimodale Modell Qwen3.8-Omni-Flash ist offiziell verfügbar. Es führt Text, Bilder, Audio und Video in einem gemeinsamen Agent-Workflow zusammen. Das Ziel ist nicht nur, Inhalte zu „verstehen“, sondern von der Analyse der Ressourcen über Planung und Tool-Aufrufe bis zur Auslieferung eines Ergebnisses zu gelangen. Für Entwickler, die lange Videos, Meeting-Aufnahmen, Musikvideos oder Film- und Serienmaterial verarbeiten, liegt der Schwerpunkt dieser Veröffentlichung auf Audio-Video-Agenten und nicht auf einem weiteren rein dialogorientierten multimodalen Modell.
Dieser Beitrag fasst die Veröffentlichung aus dem offiziellen Qwen-WeChat-Konto zusammen. Die Abbildungen entsprechen den Launch- und Demo-Bildern des Originalbeitrags; die Evaluationszahlen stammen vom Anbieter und sind keine unabhängige Nachmessung dieser Website. Ob das Modell bereits im Katalog verfügbar ist, welcher Multiplikator gilt und was tatsächlich abgerechnet wird, zeigt die Live-Preisseite zusammen mit dem echten Kontobeleg.
Welche Eingaben unterstützt Qwen3.8-Omni-Flash?
| Punkt | Angaben aus der Veröffentlichung |
|---|---|
| Modellname | Qwen3.8-Omni-Flash |
| Eingabemodalitäten | Text, Bild, Audio und Video |
| Kontext | Bis zu 1M Tokens |
| Schwerpunkte | Audio-Video-Agenten, Programmierung, Wissensarbeit und GUI-Bedienung |
| Lange Aufgaben | Verständnis langer Audio- und Videodateien, Meeting-Protokolle und To-dos, Videorechercheberichte, Content-Erstellung |
| Zugehörige Werkzeuge | Qwen-MM-Plugins, Qwen-Live Harness |
Die tatsächliche API-Modell-ID, das Protokoll, die Kontextgrenze und die regionale Verfügbarkeit richten sich nach der aktuellen Dokumentation des Anbieters. Gehen Sie nicht davon aus, dass jede OpenAI-kompatible Gateway-Schnittstelle Audio, Video und Tool-Rückgaben unterstützt, nur weil die Veröffentlichung von „vollständiger Multimodalität“ spricht. Prüfen Sie Text, Bilder, Audio, Video und Tool-Aufrufe jeweils separat.
Offizielle Benchmarks: deutliche Fortschritte bei Audio-Video-Agenten und langen Aufgaben
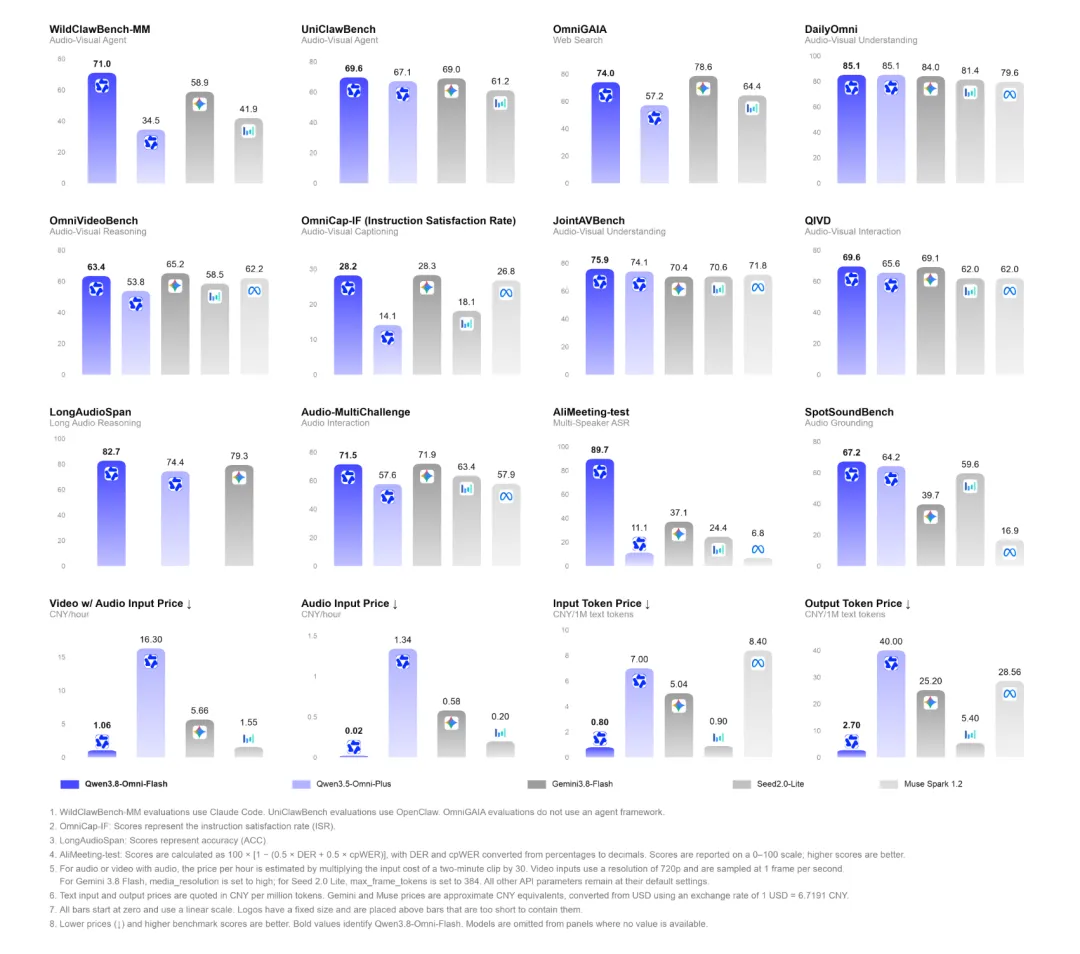
Laut Veröffentlichung verbessert sich Qwen3.8-Omni-Flash im Durchschnitt um mehr als 26 % über insgesamt 30 Benchmarks gegenüber Qwen3.5-Omni-Plus. Einige leichter einzuordnende Werte:
- WildClawBench-MM steigt um 36,5 Punkte und betrachtet Audio-Video-Agenten, Programmierung und lange Aufgaben;
- AgenticVBench steigt um 22,3 Punkte;
- UniClawBench erreicht 69,6;
- LongAudioSpan steigt um 8,3 Punkte, OmniVideoBench um 9,6 Punkte;
- CSR / ISR bei OmniCap-IF steigen um 8,5 bzw. 14,1 Punkte;
- bei AliMeeting sinken DER / cpWER von 88,11 / 89,61 auf 3,35 / 17,18.
Diese Zahlen sollten zusammen mit Testset, Prompts, Tool-Umgebung und Bewertungsmetrik gelesen werden. DER und cpWER sind fehlerbezogene Kennzahlen für die Meeting-Erkennung; ein Rückgang ist normalerweise besser. Ein höherer Agent-Benchmark-Wert lässt sich jedoch nicht direkt in eine Erfolgsquote für alle Produktionsaufgaben übersetzen.
Langer Kontext bedeutet nicht nur „mehr Video hineinzupacken“
Qwen3.8-Omni-Flash unterstützt Sequenzen bis 1M, aber der Nutzen des langen Kontextes besteht nicht allein darin, größere Dateien hochzuladen. Praktischer ist, dass das Modell abhängig von der Frage entscheiden kann, was es ansehen oder anhören muss, und anschließend relevante Ausschnitte in mehreren Runden vom Groben zum Detail prüft.
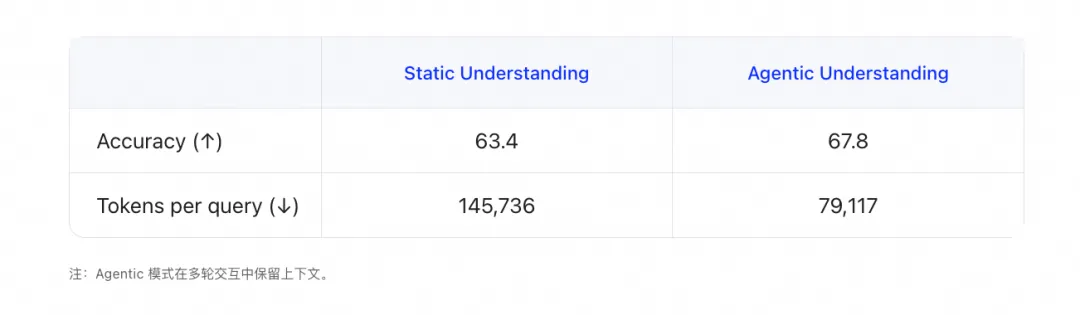
Im offiziellen Material wird für OmniVideoBench berichtet, dass Agentic Understanding die Genauigkeit von 63,4 auf 67,8 steigert, während der Tokenverbrauch von 145.736 auf 79.117 sinkt, also um etwa 45,7 %. Aktive Beweiserhebung kann damit die wiederholte Verarbeitung irrelevanter Ausschnitte reduzieren. Die tatsächlichen Kosten hängen dennoch von Dateilänge, Audio- und Video-Encoding, Tool-Schleifen, Ausgabelänge und der Abrechnung des Anbieters ab.
Lange Meetings: von der Mitschrift zur Ausführung
In einem Meeting kommen Bild, Sprache, Sprechertrennung, Verweise und Projektkontext zusammen. Laut Veröffentlichung verarbeitet Qwen3.8-Omni-Flash bis zu eine Stunde Audio-Video-Eingabe, versteht sichtbare Personen und gesprochene Inhalte gemeinsam, trennt Sprecher, erstellt Transkripte und ordnet Identitäten zu. Anschließend kann es Protokolle, To-dos und Risikoanalysen erzeugen.
Mit Tools kann der Workflow weitergehen, etwa mit dem Versand einer E-Mail, der Organisation von Aufgaben oder dem Start von Code entsprechend den Meeting-Anforderungen. Trennen Sie dabei Modellvorschläge von der tatsächlichen Ausführung externer Aktionen: In Produktionsumgebungen sollten E-Mail-Versand, Dateischreiben, Aufgabenerstellung und Codeausführung explizite Berechtigungen besitzen.
Tiefenrecherche mit Video als Ausgangspunkt
Wenn ein Nutzer eine konkrete Frage zu einem Video stellt, muss die Antwort häufig zusätzlich Webseiten, Bilder, Dokumente und weitere Videos berücksichtigen. Qwen3.8-Omni-Flash kann zunächst die zentralen Fragen aus dem Video ableiten, dann multimodale Quellen zusammenführen und einen bebilderten Recherchebericht erstellen. Für Tutorials, Kurse, Produktdemos und audiovisuelle Inhalte ist das näher am tatsächlichen Workflow als eine reine Zusammenfassung.
Steuerbare Videobeschreibung: ein Inhalt, unterschiedliche Geschäftsausgaben
Videobeschreibungen sollten nicht nur eine feste Form haben. Bei der Content-Erstellung zählt die Erzählung, bei der Materialsuche zählen Zeitsegmente, und bei der Asset-Verwaltung zählen Personen, Einstellungen, Audioereignisse und strukturierte Felder.
Qwen3.8-Omni-Flash soll es dem Aufrufer ermöglichen, Beschreibungselemente, Zeitbereich, Detailgrad und Ausgabeformat zu steuern. Derselbe Inhalt kann beispielsweise Folgendes liefern:
- eine dreiteilige Handlungsskizze für die Redaktion;
- Zeitstempel, Personen und wichtige Aktionen für die Suche;
- JSON-Metadaten für eine Asset-Bibliothek;
- eine Liste von Sprechern, Sprachen und Audioereignissen für ein Untertitelteam.
Diese Fähigkeit sollte zusammen mit strukturierter Ausgabe, Dateitools und einem Suchsystem entworfen werden, statt nur eine natürliche Sprachbeschreibung im Chatfenster anzuzeigen.
Audio-Video-Produktion und Schnitt: Modell, Tools und Laufzeit müssen gemeinsam weiterentwickelt werden
Ein Audio-Video-Agent für lange Inhalte ist nicht nur eine Modellfrage. Ebenso wichtig sind Dateispeicher, Netzwerkübertragung, mehrstufige Inferenz, Zeitleistenbearbeitung und Ergebnisübergabe. Die Veröffentlichung stellt zwei zugehörige Open-Source-Projekte vor:
- Qwen-MM-Plugins: bedarfsgesteuerte Wahrnehmung, Tool-Aufrufe und Workflow-Ausführung für lange Audio- und Videoinhalte;
- Qwen-Live Harness: Laufzeitumgebung für kontinuierliche Echtzeit-Interaktion mit vollständiger Multimodalität.
Die beiden Projekte haben unterschiedliche Schwerpunkte: Das eine ist stärker auf lange Aufgaben und die Verarbeitung von Ressourcen ausgerichtet, das andere auf Echtzeitinteraktion. Prüfen Sie beim Deployment Abhängigkeiten, GPU-Speicher, Dateiberechtigungen, externes Netzwerk und Plugin-Versionen separat. „Open-Source-Repository“ bedeutet nicht „mit einem Klick produktionsbereit“.
Wie lässt sich die Qwen3.8-Omni-Flash-API integrieren?
Wenn der Anbieter die entsprechende Route geöffnet hat, beginnen Sie mit kleinen, nicht sensiblen Dateien: einem Bild, einigen Dutzend Sekunden Audio und einem kurzen Video. Prüfen Sie Eingabe, Ausgabe, Token-Verbrauch und Fehlermeldungen jeweils separat.
Eine typische OpenAI-kompatible Anfrage sieht so aus. Ersetzen Sie model durch die exakt bestätigte Modell-ID aus dem Live-Katalog des Anbieters und raten Sie die Modellbezeichnung nicht:
curl "$BASE_URL/chat/completions" \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-omni-flash",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "Fasse Thema, Sprecher und drei wichtige Zeitpunkte dieses Inhalts zusammen."},
        {"type": "input_video", "video_url": {"url": "https://example.com/demo.mp4"}}
      ]
    }],
    "stream": false
  }'
input_video zeigt hier nur, dass multimodale Anfragen das Format jedes Inhaltsblocks separat prüfen müssen. Nicht jede kompatible Schnittstelle akzeptiert dieses Feld. Lesen Sie vor der echten Integration die Anbieterdokumentation und halten Sie separat fest:
- ob Video-URLs, Base64 oder eine Datei-ID unterstützt werden;
- die Grenzen für Dateigröße, Dauer, Format und Download-Timeout;
- wie Audio- und Video-Tokens berechnet und bepreist werden;
- ob Tool-Aufrufe, strukturierte Ausgabe und Streaming unterstützt werden;
- ob ein Retry nach einem Fehler zu einer doppelten Abrechnung führen kann.
Wenn Sie das Gateway dieser Website verwenden, öffnen Sie zuerst die Live-Preisseite, bestätigen Sie Modell-ID, Multiplikator und Fähigkeiten und prüfen Sie die echte Abrechnung mit einem kleinen Guthaben. Der Beitrag übernimmt weder den offiziellen Veröffentlichungspreis noch den Preis anderer Plattformen als Preis dieses Gateways.
Für welche Szenarien eignet sich das Modell?
1. Videoschnitt und Materialsuche
Lassen Sie das Modell zunächst Einstellungen, Personen, Aktionen und Audioereignisse lokalisieren und übergeben Sie das Ergebnis anschließend an ein Schnittwerkzeug für Rohschnitt, Untertitel und Kapitel. Bei der Abnahme sollten Zeitstempelgenauigkeit und Auslassungsrate verglichen werden, nicht nur die Lesbarkeit der Zusammenfassung.
2. Musikvideos und Filmerzählungen
Das Modell kann Bild, Dialog, Musik und Erzählstruktur gemeinsam verstehen und daraus Skripte, Einstellungsbeschreibungen oder einen Kommentarentwurf erstellen. Der fertige Film braucht weiterhin eine menschliche Prüfung von Rechten, Fakten und sprachlicher Qualität.
3. Meetings und Wissensarbeit
Meeting-Videos können eine Pipeline aus Transkription, Sprechererkennung, Protokoll, Risikoanalyse und Aufgabenerstellung durchlaufen. Bei Kunden-, Mitarbeiter- oder Geschäftsgeheimnissen müssen Speicher- und Übertragungsgrenzen zuerst geklärt werden.
4. Multimodale Tiefenrecherche
Nutzen Sie das Video als Rechercheeinstieg und ergänzen Sie Webseiten, Bilder, Dokumente und weitere Videos. Das eignet sich für Kursauswertung, Produktrecherche und die Analyse technischer Tutorials.
Auswahl- und Integrationscheckliste
- Bestätigen Sie zuerst, dass der Anbieter
Qwen3.8-Omni-Flashtatsächlich freigeschaltet hat; verlassen Sie sich nicht nur auf eine Nachrichtenüberschrift. - Testen Sie Text, Bild, Audio und Video jeweils mit kleinen, nicht sensiblen Dateien.
- Protokollieren Sie Dateigröße und Dauer, Input- und Output-Tokens, Latenz, Cache und den tatsächlich berechneten Betrag.
- Erstellen Sie getrennte Abnahmetests für OCR, Sprechererkennung, Zeitstempel, Video-Fragen und Tool-Ausführung.
- Trennen Sie die Berechtigungen für Videoverständnis, Dateilesen, Aufgabenerstellung, E-Mail-Versand und Codeausführung.
- Legen Sie für lange Aufgaben Budget, Timeout, Retry-Regeln und Bedingungen für eine menschliche Übernahme fest.
- Schreiben Sie Modellversion, Anfragezeitpunkt, Anbieter, Protokoll und Antwortstruktur in nachvollziehbare Logs.
Häufige Fragen
Ist Qwen3.8-Omni-Flash ein gewöhnliches Vision-Modell?
Nein. Die Veröffentlichung positioniert es als natives multimodales Modell mit Text-, Bild-, Audio- und Videoeingaben, das Audio-Video-Verständnis mit Agent-Tool-Ausführung verbindet.
Wie lang darf ein Video sein?
Die Veröffentlichung nennt bis zu eine Stunde Audio-Video-Eingabe und einen Kontext von 1M. Die konkrete Grenze kann durch API, Dateigröße, Encoding, Region und Anbieterimplementierung beeinflusst werden. Maßgeblich sind die aktuelle Dokumentation und ein echter Request.
Bedeutet 1M Kontext automatisch geringere Kosten?
Nein. Ein langer Kontext erweitert den verarbeitbaren Bereich, aber Upload, Audio- und Video-Tokens, Tool-Schleifen und Ausgabe verursachen weiterhin Kosten. Aktive Beweiserhebung kann irrelevante Verarbeitung reduzieren, muss aber mit realem Verbrauch geprüft werden.
Was ist der Unterschied zwischen Qwen-Live Harness und Qwen-MM-Plugins?
Qwen-Live Harness ist auf eine kontinuierliche Echtzeitumgebung für vollständige multimodale Interaktion ausgerichtet. Qwen-MM-Plugins konzentriert sich auf bedarfsgesteuerte Wahrnehmung, Tool-Aufrufe und Workflow-Ausführung bei langen Audio- und Videoinhalten. Beide sind zugehörige Projekte und nicht dieselbe Modell-API.
Unterstützt diese Website Qwen3.8-Omni-Flash bereits?
Dieser Beitrag ersetzt nicht den Live-Katalog. Prüfen Sie auf der Modell- und Preisseite Modell-ID, Multiplikator, Modalitäten und echte Abrechnung, bevor Sie das Modell produktiv einsetzen.
Fazit
Der Schwerpunkt des multimodalen Modells Qwen3.8-Omni-Flash liegt darin, Audio und Video von bloßen Eingaben zu Arbeitsressourcen zu machen, die ein Agent fortlaufend untersuchen, planen, mit Tools verarbeiten und in Ergebnisse umwandeln kann. Validieren Sie zunächst kleine reale Aufgaben wie Fragen zu langen Videos, Meeting-Protokolle und Materialsuche. Danach können Schnitt, Recherche und Aufgabenausführung schrittweise hinzukommen.
Quelle: die vom Nutzer bereitgestellte Offline-WeChat-Seite „全模态模型 Qwen3.8-Omni-Flash 发布“. Die Bilder stammen aus dem Originalbeitrag und wurden in die statischen Ressourcen dieser Website kopiert. Seitenskripte und Anweisungen Dritter wurden nicht als redaktioneller Inhalt behandelt.