Выпуск полномодальной модели Qwen3.8-Omni-Flash: возможности, API и руководство по аудио-видео Agent
Полномодальная модель Qwen3.8-Omni-Flash официально запущена. Она объединяет текст, изображения, аудио и видео в одном рабочем процессе Agent. Цель — не просто «понять контент», а пройти весь путь от понимания материалов и планирования задачи до вызова инструментов и выдачи результата. Для разработчиков, которым нужно обрабатывать длинные видео, записи встреч, музыкальные клипы и киноматериалы, главный акцент этого релиза — аудио-видео Agent, а не очередная мультимодальная модель, умеющая только вести диалог.
Эта статья подготовлена на основе материалов, опубликованных в официальном аккаунте Qwen 大模型; иллюстрации сохранены из оригинальных изображений релиза и демонстраций. Числа бенчмарков в статье — это официально раскрытые результаты, а не независимое повторное тестирование нашего сайта. Появилась ли модель в каталоге нашего сайта, а также фактические коэффициенты и списания следует проверять по актуальным ценам моделей и реальным счетам.
Какие типы ввода поддерживает Qwen3.8-Omni-Flash?
| Параметр | Информация из материалов релиза |
|---|---|
| Название модели | Qwen3.8-Omni-Flash |
| Модальности ввода | Текст, изображения, аудио, видео |
| Контекст | До 1M Tokens |
| Основные направления | Аудио-видео Agent, программирование, работа с текстовыми знаниями, GUI-операции |
| Длинные задачи | Понимание длинных аудио и видео, протоколы встреч и задачи, исследовательские отчеты по видео, создание контента |
| Сопутствующие инструменты | Qwen-MM-Plugins, Qwen-Live Harness |
Фактический API model ID, протокол, ограничения контекста и доступность по регионам нужно уточнять в актуальной документации поставщика сервиса. Не следует предполагать, что из-за формулировки «полномодальная» в релизе все совместимые шлюзы уже поддерживают аудио, видео и возврат результатов инструментов. При интеграции нужно отдельно проверять текст, изображения, аудио, видео и вызовы инструментов.
Официальные бенчмарки: заметный рост в аудио-видео Agent и длинных задачах
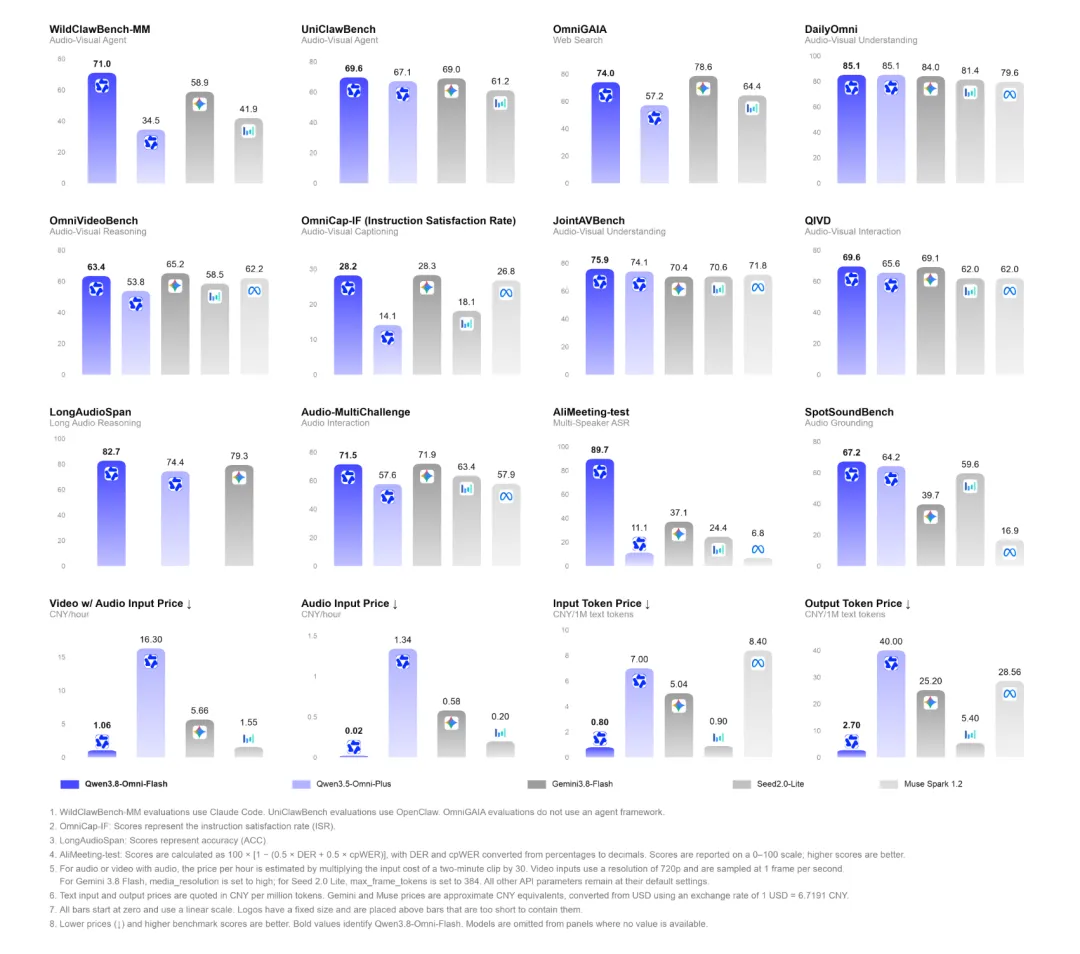
Согласно материалам релиза, Qwen3.8-Omni-Flash в совокупности по 30 бенчмаркам показала средний прирост более 26% по сравнению с предыдущим поколением Qwen3.5-Omni-Plus. Несколько наиболее понятных изменений:
- WildClawBench-MM вырос на 36.5 балла; фокус — аудио-видео Agent, программирование и длинные задачи;
- AgenticVBench вырос на 22.3 балла;
- UniClawBench получил 69.6 балла;
- LongAudioSpan вырос на 8.3 балла, OmniVideoBench — на 9.6 балла;
- в OmniCap-IF показатели CSR / ISR выросли на 8.5 / 14.1 балла соответственно;
- в AliMeeting показатели DER / cpWER снизились с 88.11 / 89.61 до 3.35 / 17.18.
Эти числа следует интерпретировать с учетом тестовых наборов, промптов, окружения инструментов и метрик оценки. Например, DER и cpWER — это метрики ошибок, связанные с распознаванием встреч; их снижение обычно означает улучшение. А рост баллов в Agent benchmark нельзя напрямую переводить в вероятность успеха для всех production-задач.
Длинный контекст — это не только возможность «поместить больше видео»
Qwen3.8-Omni-Flash поддерживает длинные последовательности 1M, но ценность длинного контекста не сводится к загрузке файлов большего размера. Более практичное изменение в том, что модель может сначала решить, «что смотреть и что слушать» исходя из вопроса, а затем провести многошаговую проверку релевантных фрагментов от общего к частному.
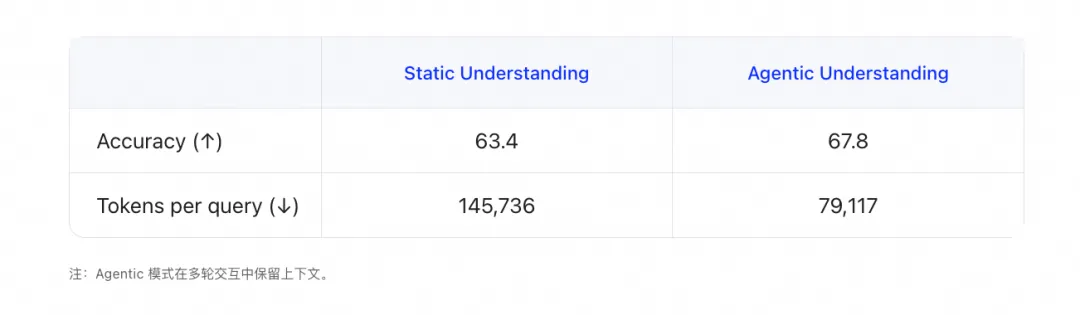
В эксперименте OmniVideoBench, приведенном в официальных материалах, Agentic Understanding повысил точность с 63.4 до 67.8, при этом расход Token снизился с 145,736 до 79,117, то есть примерно на 45.7%. Это показывает, что активный сбор доказательств может сокращать повторную обработку нерелевантных фрагментов, но фактическая стоимость по-прежнему зависит от длительности файла, кодирования аудио и видео, циклов инструментов, длины вывода и способа тарификации у поставщика сервиса.
Длинные встречи: от записи к исполнению
Многосторонняя встреча одновременно содержит изображение, звук, разделение говорящих, референциальные связи и контекст проекта. В материалах релиза говорится, что Qwen3.8-Omni-Flash поддерживает аудио-видео ввод длительностью до одного часа, может совместно понимать изображение участников и речевой контент, выполнять разделение говорящих, транскрибацию и сопоставление личностей, а затем генерировать протокол встречи, задачи и анализ рисков.
После подключения инструментов рабочий процесс может продолжаться за пределами модели: например, отправлять письма, структурировать задачи или начинать писать код в соответствии с требованиями встречи. Здесь важно отдельно принимать «рекомендации, выданные моделью» и «реальное выполнение внешних действий»: в production-среде нужно явно настроить права инструментов для отправки писем, записи файлов, создания задач и запуска кода.
Глубокие исследования с видео в центре
Когда пользователь задает конкретный вопрос по видео, ответ часто требует учитывать не только само видео, но и внешние веб-страницы, изображения, документы и другие видеоматериалы. Qwen3.8-Omni-Flash может сначала извлечь ключевые вопросы из видео, а затем организовать мультимодальные материалы в иллюстрированный исследовательский отчет. Для учебных материалов, курсов, продуктовых демонстраций и киноматериалов это ближе к реальному рабочему процессу, чем простая генерация краткого резюме.
Управляемое описание видео: один и тот же материал — разные результаты для разных задач
У описания видео не должно быть только одного фиксированного ответа. Создателям контента важен нарратив, поиску материалов — временные фрагменты, управлению медиаресурсами — персонажи, кадры, звук и структурированные поля.
Позиционирование Qwen3.8-Omni-Flash заключается в том, чтобы вызывающая сторона могла управлять объектом описания, временным диапазоном, уровнем детализации и форматом вывода. Например, один и тот же материал можно вывести в нескольких вариантах:
- трехчастный сюжетный синопсис для редактора;
- временные метки, персонажи и ключевые действия для поиска;
- JSON-метаданные для медиатеки;
- список говорящих, языков и аудиособытий для команды субтитров.
Такие возможности лучше проектировать вместе со структурированным выводом, файловыми инструментами и поисковыми системами, а не просто просматривать в чат-окне как фрагмент естественного языка.
Производство и редактирование аудио-видео: обновлять нужно модель, инструменты и среду выполнения
Перед длинными аудио-видео Agent стоят не только вопросы возможностей модели, но и задачи хранения файлов, передачи по сети, многошагового рассуждения, редактирования таймлайна и доставки результата. Для этого в материалах релиза представлены два сопутствующих open-source проекта:
- Qwen-MM-Plugins: восприятие по требованию, вызов инструментов и выполнение рабочих процессов для длинных аудио-видео;
- Qwen-Live Harness: среда для real-time и непрерывного полномодального взаимодействия.
Их можно понимать как решения с разными акцентами на стороне выполнения: одно больше ориентировано на длинные задачи и обработку материалов, другое — на взаимодействие в реальном времени. При развертывании нужно отдельно проверять зависимости, видеопамять, права доступа к файлам, внешний сетевой доступ и версии плагинов; не стоит превращать формулировку «репозиторий открыт» в обещание «локально запускается в production одним кликом».
Как подключиться к Qwen3.8-Omni-Flash API?
Если поставщик сервиса уже открыл соответствующий маршрут, сначала рекомендуется провести Smoke Test на небольшом материале без чувствительных данных: одно изображение, аудиофрагмент на несколько десятков секунд и короткое видео. Отдельно протестируйте ввод, вывод, расход Token и сообщения об ошибках.
Типичная форма запроса к совместимому Chat Completions API выглядит так. Значение model замените на точный ID, подтвержденный в актуальном каталоге моделей поставщика; не угадывайте имя модели напрямую:
curl "$BASE_URL/chat/completions" \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-omni-flash",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "Суммируй тему этого материала, говорящих и три ключевые временные точки."},
        {"type": "input_video", "video_url": {"url": "https://example.com/demo.mp4"}}
      ]
    }],
    "stream": false
  }'
Поле input_video выше используется только для иллюстрации того, что в мультимодальных запросах нужно отдельно проверять формат content-блоков; это не означает, что все совместимые интерфейсы принимают это поле. Перед реальной интеграцией следует изучить документацию поставщика сервиса и отдельно зафиксировать:
- поддерживает ли интерфейс video URL, Base64 или file ID;
- ограничения на размер одного файла, длительность, формат и таймаут скачивания;
- способ расчета и цену аудио/видео Token;
- поддерживаются ли вызовы инструментов, структурированный вывод и потоковый возврат;
- приведут ли повторные попытки после сбоя к повторному списанию средств.
Если вы вызываете модель через шлюз нашего сайта, сначала откройте актуальные цены моделей, подтвердите model ID, коэффициент и текущие возможности, а затем проверьте реальный счет на небольшом балансе. Статьи нашего сайта не приравнивают официальные цены релиза или цены других платформ к ценам на этом сайте.
Для каких сценариев подходит?
1. Видеомонтаж и поиск материалов
Пусть модель сначала определит кадры, персонажей, действия и аудиособытия, а затем передаст результат монтажному инструменту для чернового монтажа, субтитров и разметки глав. При приемке следует сравнивать точность временных меток и долю пропущенных событий, а не только то, насколько плавно читается резюме.
2. Музыкальные клипы и кинопересказ
Модель может одновременно понимать изображение, диалоги, музыку и нарративную структуру, а затем генерировать сценарий, описание кадров или черновик озвучки. Финальный ролик все равно требует ручной проверки авторских прав, фактов и качества языка.
3. Встречи и работа со знаниями
Видео встреч можно включить в конвейер транскрибации, распознавания говорящих, протоколирования, анализа рисков и создания задач. Если затрагиваются клиенты, сотрудники или коммерческая тайна, сначала необходимо подтвердить границы хранения данных и внешней передачи.
4. Мультимодальные глубокие исследования
Используйте видео как входную точку исследования и дополняйте контекст веб-страницами, изображениями, документами и другими видео. Это подходит для разбора курсов, продуктовых исследований и анализа технических туториалов.
Чек-лист выбора и интеграции
- Сначала убедитесь, что поставщик сервиса действительно открыл
Qwen3.8-Omni-Flash, а не ориентируйтесь только на заголовок новости. - Протестируйте текст, изображения, аудио и видео отдельно на небольших файлах без чувствительных данных.
- Зафиксируйте размер файла, длительность, входные/выходные Tokens, задержку, кэширование и фактическое списание.
- Создайте отдельные приемочные образцы для OCR, распознавания говорящих, временных меток, видео-QA и выполнения инструментов.
- Разнесите понимание видео, чтение файлов, создание задач, отправку писем и выполнение кода по разным границам прав доступа.
- Для длинных задач настройте бюджет, таймауты, повторы и условия передачи человеку.
- Записывайте версию модели, дату запроса, поставщика сервиса, протокол и структуру ответа в трассируемые логи.
Частые вопросы
Qwen3.8-Omni-Flash — это обычная визуальная модель?
Нет. В релизе она позиционируется как нативная полномодальная модель: ввод охватывает текст, изображения, аудио и видео, а понимание аудио-видео объединяется с выполнением инструментов Agent.
Видео какой длины она поддерживает?
В материалах релиза упоминается аудио-видео ввод длительностью до одного часа, а также длинный контекст 1M. Конкретные лимиты все равно могут зависеть от API, размера файла, кодирования, региона и реализации поставщика сервиса; ориентироваться следует на текущую документацию интерфейса и реальные запросы.
Означает ли контекст 1M, что стоимость обязательно будет ниже?
Нет. Длинный контекст расширяет обрабатываемый диапазон, но загрузка файлов, аудио/видео Token, циклы инструментов и вывод тоже создают затраты. Agentic-сбор доказательств может уменьшить нерелевантную обработку, но это нужно подтверждать по фактическому использованию.
Чем отличаются Qwen-Live Harness и Qwen-MM-Plugins?
Первый проект ориентирован на среду выполнения для real-time и непрерывного полномодального взаимодействия; второй — на восприятие по требованию, вызов инструментов и выполнение рабочих процессов для длинных аудио-видео. Оба являются сопутствующими проектами и не равны одной и той же API-модели.
Наш сайт уже поддерживает Qwen3.8-Omni-Flash?
Статья не заменяет актуальный каталог. Проверьте страницу цен моделей, подтвердите model ID, коэффициент, модальные возможности и фактический счет, прежде чем использовать модель в production.
Заключение
Главный смысл полномодальной модели Qwen3.8-Omni-Flash — превратить аудио-видео из «входа, который модель понимает» в рабочий носитель, с которым Agent может непрерывно собирать доказательства, планировать, вызывать инструменты и доставлять результат. Ее стоит проверять на небольших реальных задачах: сначала протестировать вопросы-ответы по длинным видео, протоколы встреч и поиск материалов, а затем постепенно добавлять монтаж, исследования и выполнение задач.
Источник релиза: предоставленная пользователем офлайн-страница публикации «全模态模型 Qwen3.8-Omni-Flash 发布» из официального аккаунта; изображения являются оригинальными иллюстрациями с этой страницы, скопированными в каталог статических ресурсов нашего сайта. Скрипты страницы и сторонние инструкции не использовались как содержимое статьи.