Qwen3.8-Omni-Flash全モーダルモデル発表:APIと音声・動画Agentガイド
Qwen3.8-Omni-Flashが全モーダルモデルとして正式にリリースされました。 テキスト、画像、音声、動画を1つのAgentワークフローにまとめ、素材の理解、タスクの計画、ツールの呼び出し、結果の納品までを一続きの流れにすることを目指しています。長尺動画、会議録音、ミュージックビデオ、映像素材を扱う開発者にとって、今回の重点は音声・動画Agentであり、会話だけを行う新しいマルチモーダルモデルという話ではありません。
本記事は、Qwen大規模モデル公式WeChatアカウントが公開した発表資料をもとに整理しています。画像は原文の発表図とデモ図を使用し、評価数値は公式発表の結果であって、当サイトによる独立検証ではありません。当サイトのカタログにモデルが掲載されているか、実際の倍率や課金額はいずれも、リアルタイムのモデル価格と実際の請求記録を基準にしてください。
Qwen3.8-Omni-Flashが対応する入力
| 項目 | 発表資料に記載された情報 |
|---|---|
| モデル名 | Qwen3.8-Omni-Flash |
| 入力モダリティ | テキスト、画像、音声、動画 |
| コンテキスト | 最大1Mトークン |
| 主な方向性 | 音声・動画Agent、コーディング、テキスト知識ワーク、GUI操作 |
| 長時間タスク | 長尺音声・動画の理解、会議議事録とアクションアイテム、動画リサーチレポート、コンテンツ制作 |
| 付属ツール | Qwen-MM-Plugins、Qwen-Live Harness |
実際のAPIモデルID、プロトコル、コンテキスト上限、地域ごとの利用可否は、サービス提供者の最新ドキュメントで確認する必要があります。発表資料が「全モーダル」と説明しているからといって、すべてのOpenAI互換ゲートウェイが音声、動画、ツールの結果返却に対応しているとは限りません。導入時は、テキスト、画像、音声、動画、ツール呼び出しを個別に検証してください。
公式評価:音声・動画Agentと長時間タスクで大きく向上
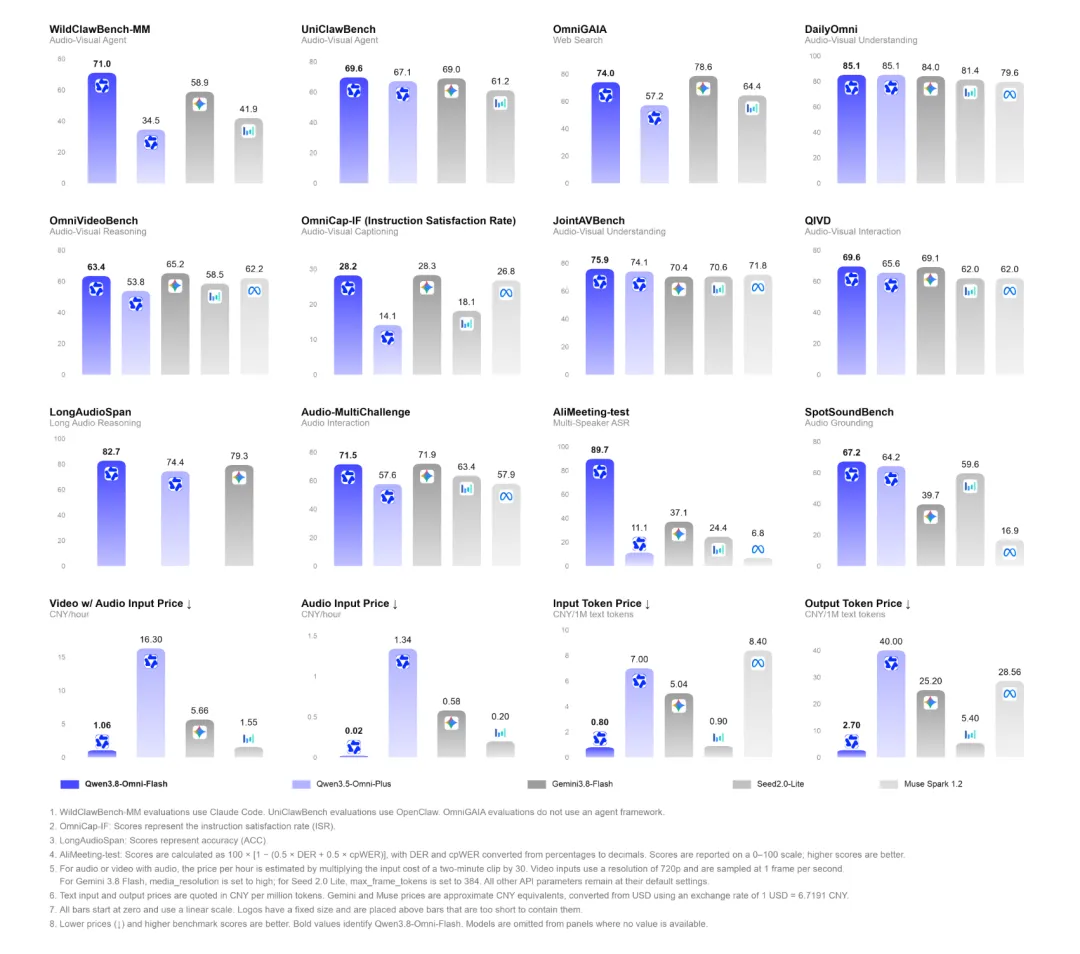
発表資料によると、Qwen3.8-Omni-Flashは、前世代のQwen3.5-Omni-Plusと比べ、合計30項目の評価で平均26%以上向上しました。理解しやすい変化を挙げると、次のとおりです。
- WildClawBench-MMは36.5ポイント向上。音声・動画Agent、コーディング、長時間タスクを評価;
- AgenticVBenchは22.3ポイント向上;
- UniClawBenchは69.6;
- LongAudioSpanは8.3ポイント、OmniVideoBenchは9.6ポイント向上;
- OmniCap-IFのCSR / ISRはそれぞれ8.5 / 14.1ポイント向上;
- AliMeetingのDER / cpWERは88.11 / 89.61から3.35 / 17.18へ低下。
これらの数値は、テストセット、プロンプト、ツール環境、評価指標と合わせて解釈する必要があります。たとえばDERとcpWERは会議認識に関する誤り指標で、通常は低いほど良い指標です。一方、Agentベンチマークのスコア上昇を、そのまますべての本番タスクの成功率に置き換えることはできません。
長いコンテキストは「より多くの動画を詰め込める」だけではない
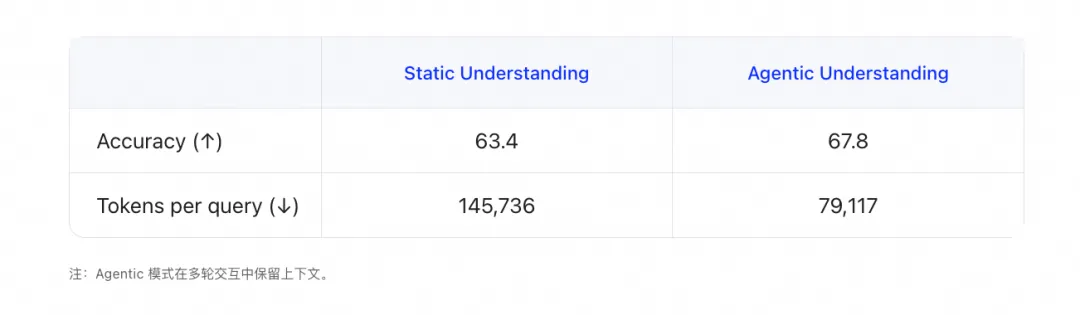
Qwen3.8-Omni-Flashは最大1Mトークンのシーケンスに対応しますが、長いコンテキストの価値は大きなファイルをアップロードできることだけではありません。より実用的な変化は、質問に応じて何を見るか、何を聞くかをモデルが判断し、関連する区間を粗い確認から細かな確認へ複数回に分けて調査できる点です。
公式資料が引用するOmniVideoBenchの実験では、Agentic Understandingの正解率が63.4から67.8へ上昇し、トークン消費は145,736から79,117へ、約**45.7%**減少しました。能動的な情報収集によって無関係な区間の繰り返し処理を減らせる可能性がありますが、実際のコストはファイルの長さ、音声・動画のエンコード、ツールループ、出力長、サービス提供者の課金方式によって変わります。
長時間の会議:記録から実行へ
複数人の会議には、映像、音声、話者分離、指示語や参照関係、プロジェクトの文脈が同時に含まれます。発表資料によると、Qwen3.8-Omni-Flashは最大1時間の音声・動画入力に対応し、画面上の人物と音声を組み合わせて理解できます。話者分離、文字起こし、人物との対応付けを行い、会議議事録、アクションアイテム、リスク分析まで生成します。
ツールを接続すれば、メール送信、タスク整理、会議の要件に基づくコーディング開始など、ワークフローを外部へ広げることもできます。ただし、受け入れテストでは「モデルが出した提案」と「実際に外部で実行したアクション」を分けて検証してください。本番環境では、メール送信、ファイル書き込み、タスク作成、コード実行に明確なツール権限を設定する必要があります。
動画を起点にした深いリサーチ
動画について具体的な質問に答えるには、動画以外のウェブページ、画像、文書、別の動画も組み合わせる必要があります。Qwen3.8-Omni-Flashはまず動画から重要な問いを抽出し、その後にマルチモーダルな資料を整理して、図表を含むリサーチレポートを作成できます。チュートリアル、講座、製品デモ、映像素材では、単なる短い要約よりも実際の作業に近いワークフローです。
制御可能な動画説明:同じ素材でも業務ごとに違う出力
動画説明は、1種類の固定された回答である必要はありません。コンテンツ制作では物語性、素材検索ではタイムスタンプ、アセット管理では人物、ショット、音声、構造化フィールドが重視されます。
Qwen3.8-Omni-Flashは、説明対象、時間範囲、情報の粒度、出力形式を呼び出し側で制御できるモデルとして位置付けられています。同じ素材から、たとえば次の出力を作成できます。
- 編集者向けの3部構成のあらすじ;
- 検索向けのタイムスタンプ、人物、主要アクション;
- アセット管理システム向けのJSONメタデータ;
- 字幕チーム向けの話者、言語、音声イベント一覧。
この機能は、チャット画面で自然言語の説明を見るだけでなく、構造化出力、ファイルツール、検索システムと組み合わせて設計する方が適しています。
音声・動画の制作と編集:モデル、ツール、実行環境を同時に更新する
長尺音声・動画Agentが直面するのは、モデル性能だけの問題ではありません。ファイル保存、ネットワーク転送、複数ターン推論、タイムライン編集、成果物の納品も必要です。発表資料では、関連するオープンソースプロジェクトとして次の2つが紹介されています。
- Qwen-MM-Plugins:長尺音声・動画向けのオンデマンド知覚、ツール呼び出し、ワークフロー実行;
- Qwen-Live Harness:リアルタイムで継続的な全モーダル対話の実行環境。
両者は実行側の重点が異なると考えられます。一方は長時間タスクと素材処理、もう一方はリアルタイム対話に寄っています。導入時は依存関係、GPUメモリ、ファイル権限、外部ネットワーク、プラグインのバージョンを個別に確認してください。「リポジトリがオープンソースである」ことを、「ローカルですぐ本番運用できる」と書き換えてはいけません。
Qwen3.8-Omni-Flash APIの接続方法
サービス提供者が対応するルートを公開している場合、まずは機密情報を含まない小さな素材でSmoke Testを行います。1枚の画像、数十秒の音声、短い動画を用意し、入力、出力、トークン使用量、エラーメッセージを個別にテストしてください。
典型的なOpenAI互換リクエストの形は次のとおりです。modelはサービス提供者のリアルタイムモデルカタログで確認した正確なIDに置き換えてください。モデル名を推測してはいけません。
curl "$BASE_URL/chat/completions" \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-omni-flash",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "この素材のテーマ、話者、3つの重要なタイムスタンプを要約してください。"},
        {"type": "input_video", "video_url": {"url": "https://example.com/demo.mp4"}}
      ]
    }],
    "stream": false
  }'
上のinput_videoは、マルチモーダルリクエストではコンテンツブロックの形式を個別に検証する必要があることを示す例にすぎません。すべての互換インターフェースがこのフィールドを受け付けるという意味ではありません。実際に接続する前にサービス提供者のドキュメントを確認し、次の点を記録してください。
- 動画URL、Base64、ファイルIDのどれに対応しているか;
- 1ファイルあたりのサイズ、長さ、形式、ダウンロードタイムアウトの上限;
- 音声・動画トークンの計算方法と価格;
- ツール呼び出し、構造化出力、ストリーミング返却に対応しているか;
- 失敗時のリトライで二重課金が発生しないか。
当サイトのゲートウェイ経由で呼び出す場合は、まずリアルタイムのモデル価格を開き、モデルID、倍率、現在の能力を確認してから、少額残高で実際の請求を検証してください。当サイトの記事は、公式発表価格や他サービスの価格を当サイトの料金として扱いません。
どのような用途に向いているか
1. 動画編集と素材検索
まずモデルにショット、人物、アクション、音声イベントを特定させ、その後に編集ツールへ渡してラフカット、字幕、チャプター整理を行います。受け入れ時は、要約の読みやすさだけでなく、タイムスタンプの正確さと見落とし率を比較してください。
2. ミュージックビデオと映像解説
映像、セリフ、音楽、物語構造を同時に理解し、台本、ショット説明、解説の下書きを生成できます。最終的な作品には、権利、事実、言語品質について人による確認が必要です。
3. 会議とナレッジワーク
会議動画を文字起こし、話者識別、議事録、リスク分析、タスク作成のパイプラインに入れられます。顧客、従業員、営業秘密が関係する場合は、データ保存と外部転送の境界を先に確認してください。
4. マルチモーダルな深いリサーチ
動画をリサーチの入口にして、ウェブページ、画像、文書、別の動画を組み合わせて背景を補足します。講座の振り返り、製品調査、技術チュートリアルの分析に向いています。
選定・導入チェックリスト
- サービス提供者が本当に
Qwen3.8-Omni-Flashを公開しているか確認する。ニュースの見出しだけを根拠にしない。 - 機密情報を含まない小さなファイルで、テキスト、画像、音声、動画を個別にテストする。
- ファイルサイズ、長さ、入出力トークン、レイテンシ、キャッシュ、実際の課金を記録する。
- OCR、話者識別、タイムスタンプ、動画Q&A、ツール実行について独立した受け入れサンプルを作る。
- 動画理解、ファイル読み込み、タスク作成、メール送信、コード実行を別々の権限境界に置く。
- 長時間タスクに予算、タイムアウト、リトライ、人的引き継ぎの条件を設定する。
- モデルバージョン、リクエスト日、サービス提供者、プロトコル、返却構造を追跡可能なログに残す。
よくある質問
Qwen3.8-Omni-Flashは普通のVisionモデルですか?
いいえ。テキスト、画像、音声、動画を入力できるネイティブな全モーダルモデルとして位置付けられ、音声・動画理解とAgentによるツール実行を組み合わせます。
どのくらい長い動画に対応しますか?
発表資料では、最大1時間の音声・動画入力と1Mトークンの長いコンテキストが示されています。具体的な上限はAPI、ファイルサイズ、エンコード、地域、サービス提供者の実装によって変わる可能性があるため、最新のインターフェース仕様と実際のリクエストを基準にしてください。
1Mコンテキストなら必ず安くなりますか?
いいえ。長いコンテキストは処理範囲を広げますが、ファイルアップロード、音声・動画トークン、ツールループ、出力にはそれぞれコストがかかります。Agentによる情報収集で無関係な処理を減らせる可能性はありますが、実際の使用量で検証する必要があります。
Qwen-Live HarnessとQwen-MM-Pluginsの違いは何ですか?
前者はリアルタイムで継続的な全モーダル対話の実行環境、後者は長尺音声・動画向けのオンデマンド知覚、ツール呼び出し、ワークフロー実行を担います。どちらも付属プロジェクトであり、同じAPIモデルではありません。
当サイトはすでにQwen3.8-Omni-Flashに対応していますか?
本記事はリアルタイムカタログの代わりにはなりません。モデル価格ページでモデルID、倍率、モダリティ対応、実際の請求を確認してから本番利用してください。
まとめ
Qwen3.8-Omni-Flash全モーダルモデル発表の要点は、音声と動画を「モデルが理解する入力」から、Agentが継続的に調査し、計画し、ツールを呼び出し、成果物に変換できる作業素材へ進めたことです。まずは小規模な実タスクで検証してください。長尺動画Q&A、会議議事録、素材検索を試し、その後に編集、リサーチ、タスク実行を段階的に加えます。
出典:ユーザー提供のWeChatオフラインページ『全模态模型Qwen3.8-Omni-Flash发布』。画像は原文記事のものを当サイトの静的アセットディレクトリにコピーしています。ページのスクリプトや第三者の指示は記事内容として扱っていません。