Qwen3.8-Omni-Flash 멀티모달 모델 출시: API와 오디오·비디오 Agent 가이드
Qwen3.8-Omni-Flash가 완전한 멀티모달 모델로 공식 출시되었습니다. 텍스트, 이미지, 오디오, 비디오를 하나의 Agent 워크플로에 연결하며, 단순히 콘텐츠를 이해하는 데서 끝나지 않고 자료 확인, 작업 계획, 도구 호출, 결과 전달까지 이어지는 것을 목표로 합니다. 긴 영상, 회의 녹음, 뮤직비디오, 영화·영상 자료를 다루는 개발자에게 이번 발표의 핵심은 대화만 하는 또 하나의 멀티모달 모델이 아니라 오디오·비디오 Agent라는 방향성입니다.
이 글은 Qwen 대규모 모델 공식 WeChat 계정이 공개한 발표 자료를 바탕으로 정리했습니다. 이미지는 원문에 포함된 출시 이미지와 시연 이미지를 사용했으며, 평가 수치는 공급사가 공개한 결과이지 이 사이트의 독립적인 재현 결과가 아닙니다. 모델이 이 사이트의 카탈로그에 등록되어 있는지, 실제 배율과 청구액은 실시간 모델 가격과 실제 결제 기록을 기준으로 확인해야 합니다.
Qwen3.8-Omni-Flash는 어떤 입력을 지원하나요?
| 항목 | 발표 자료에 공개된 정보 |
|---|---|
| 모델명 | Qwen3.8-Omni-Flash |
| 입력 모달리티 | 텍스트, 이미지, 오디오, 비디오 |
| 컨텍스트 | 최대 1M 토큰 |
| 주요 방향 | 오디오·비디오 Agent, 코딩, 텍스트 기반 지식 업무, GUI 조작 |
| 장시간 작업 | 장시간 오디오·비디오 이해, 회의록과 할 일, 비디오 리서치 보고서, 콘텐츠 제작 |
| 연계 도구 | Qwen-MM-Plugins, Qwen-Live Harness |
실제 API 모델 ID, 프로토콜, 컨텍스트 제한, 지역별 사용 가능 여부는 서비스 제공자의 최신 문서에서 확인해야 합니다. 발표 자료가 “완전한 멀티모달”이라고 설명한다고 해서 모든 OpenAI 호환 게이트웨이가 오디오, 비디오, 도구 결과 반환을 지원한다고 가정해서는 안 됩니다. 연동할 때 텍스트, 이미지, 오디오, 비디오, 도구 호출을 각각 검증하세요.
공식 평가: 오디오·비디오 Agent와 장시간 작업에서 뚜렷한 향상
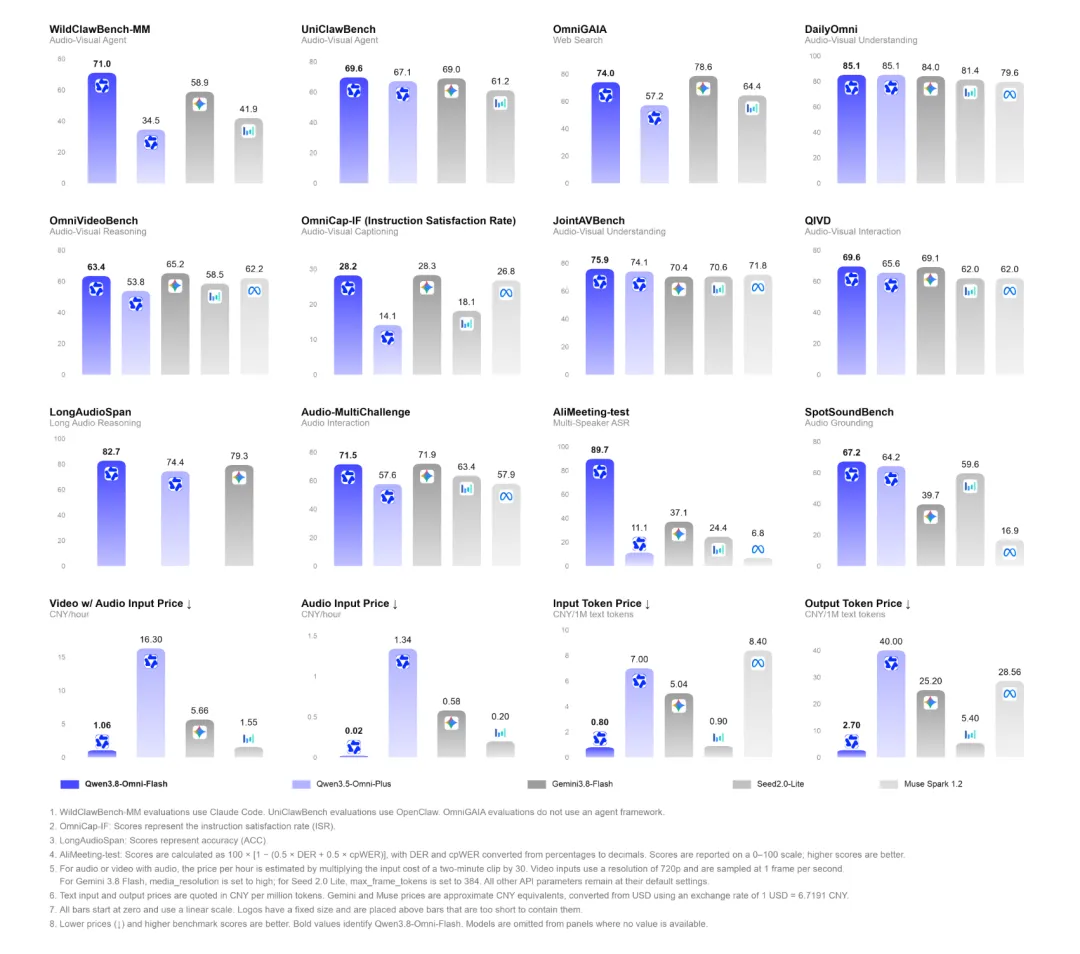
발표 자료에 따르면 Qwen3.8-Omni-Flash는 이전 세대 Qwen3.5-Omni-Plus와 비교해 총 30개 평가에서 평균 26% 이상 향상되었습니다. 이해하기 쉬운 주요 변화는 다음과 같습니다.
- WildClawBench-MM은 36.5점 향상되었으며, 오디오·비디오 Agent, 코딩, 장시간 작업을 평가합니다.
- AgenticVBench는 22.3점 향상되었습니다.
- UniClawBench 점수는 69.6입니다.
- LongAudioSpan은 8.3점, OmniVideoBench는 9.6점 향상되었습니다.
- OmniCap-IF의 CSR / ISR은 각각 8.5 / 14.1점 향상되었습니다.
- AliMeeting의 DER / cpWER은 88.11 / 89.61에서 3.35 / 17.18로 낮아졌습니다.
이 수치는 테스트 세트, 프롬프트, 도구 환경, 평가 지표와 함께 해석해야 합니다. 예를 들어 DER과 cpWER은 회의 인식 관련 오류 지표이므로 일반적으로 낮을수록 좋습니다. Agent 벤치마크 점수 향상을 모든 프로덕션 작업의 성공률로 바로 환산할 수는 없습니다.
긴 컨텍스트는 “더 많은 영상을 넣을 수 있다”는 뜻만은 아닙니다
Qwen3.8-Omni-Flash는 최대 1M 토큰 시퀀스를 지원하지만 긴 컨텍스트의 가치는 큰 파일을 업로드할 수 있다는 데만 있지 않습니다. 더 실용적인 변화는 질문에 따라 무엇을 보고 들을지 모델이 결정하고, 관련 구간을 대략적인 확인에서 세밀한 확인으로 나누어 여러 차례 증거를 수집할 수 있다는 점입니다.
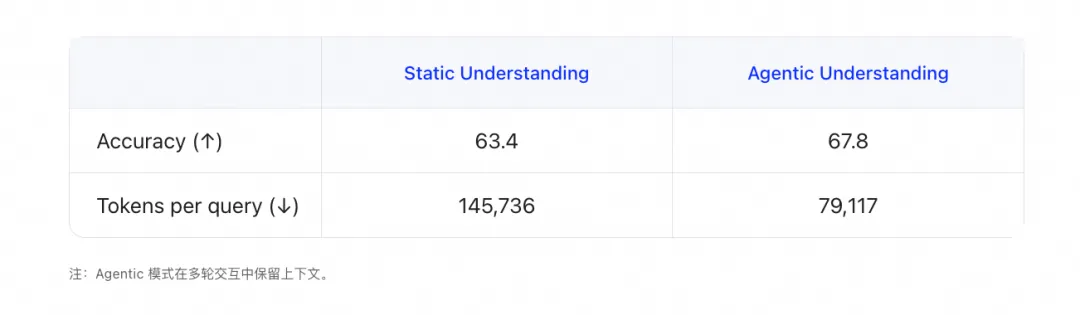
공식 자료가 인용한 OmniVideoBench 실험에서 Agentic Understanding의 정확도는 63.4에서 67.8로 상승했고, 토큰 사용량은 145,736에서 79,117로 약 45.7% 감소했습니다. 능동적인 증거 수집이 무관한 구간의 반복 처리를 줄일 가능성을 보여주지만, 실제 비용은 파일 길이, 오디오·비디오 인코딩, 도구 루프, 출력 길이, 서비스 제공자의 과금 방식에 따라 달라집니다.
긴 회의: 기록에서 실행으로
여러 사람이 참여하는 회의에는 화면, 음성, 화자 분리, 지시 대상과 참조 관계, 프로젝트 맥락이 함께 들어 있습니다. 발표 자료에 따르면 Qwen3.8-Omni-Flash는 최대 1시간의 오디오·비디오 입력을 지원하며, 화면 속 인물과 음성 내용을 함께 이해할 수 있습니다. 화자 분리, 전사, 화자와 신원 매칭을 수행한 뒤 회의록, 할 일, 위험 분석을 생성합니다.
도구를 연결하면 이메일 발송, 작업 정리, 회의 요구사항에 따른 코딩 시작 등 외부 작업으로 워크플로를 확장할 수 있습니다. 다만 검수할 때는 “모델이 제안한 내용”과 “실제로 외부에서 실행된 작업”을 구분하세요. 프로덕션 환경에서는 메일 발송, 파일 작성, 작업 생성, 코드 실행에 명확한 도구 권한을 지정해야 합니다.
비디오를 중심으로 한 심층 리서치
사용자가 영상에 대해 구체적으로 질문하면 영상 외에도 웹페이지, 이미지, 문서, 다른 영상 자료가 필요한 경우가 많습니다. Qwen3.8-Omni-Flash는 먼저 영상에서 핵심 질문을 추출한 뒤 멀티모달 자료를 구성해 텍스트와 이미지가 포함된 리서치 보고서를 만들 수 있습니다. 튜토리얼, 강의, 제품 시연, 영화·영상 자료에서는 단순한 요약보다 실제 업무 흐름에 가깝습니다.
제어 가능한 영상 설명: 같은 자료도 업무별로 다른 결과
영상 설명은 하나의 고정된 답변일 필요가 없습니다. 콘텐츠 제작은 서사를, 자료 검색은 타임스탬프를, 자산 관리는 인물·샷·음성·구조화된 필드를 중요하게 봅니다.
Qwen3.8-Omni-Flash는 설명 대상, 시간 범위, 정보의 세밀함, 출력 형식을 호출 측에서 제어할 수 있도록 설계된 모델입니다. 같은 영상에서도 다음과 같은 출력을 각각 만들 수 있습니다.
- 편집자용 3부 구성 줄거리 요약
- 검색용 타임스탬프, 인물, 주요 행동
- 자산 라이브러리용 JSON 메타데이터
- 자막팀용 화자, 언어, 오디오 이벤트 목록
이 기능은 채팅창에서 자연어 설명만 확인하기보다 구조화된 출력, 파일 도구, 검색 시스템과 함께 설계하는 편이 적합합니다.
오디오·비디오 제작과 편집: 모델·도구·실행 환경을 함께 개선해야 합니다
긴 오디오·비디오 Agent는 모델 성능만 해결한다고 끝나지 않습니다. 파일 저장, 네트워크 전송, 다중 턴 추론, 타임라인 편집, 결과 전달도 필요합니다. 발표 자료는 관련 오픈소스 프로젝트로 다음 두 가지를 소개합니다.
- Qwen-MM-Plugins: 긴 오디오·비디오를 위한 온디맨드 인식, 도구 호출, 워크플로 실행
- Qwen-Live Harness: 실시간·지속적인 완전한 멀티모달 상호작용을 위한 실행 환경
두 프로젝트는 실행 측면의 초점이 다르다고 볼 수 있습니다. 하나는 장시간 작업과 자료 처리에, 다른 하나는 실시간 상호작용에 더 가깝습니다. 배포 전에 의존성, GPU 메모리, 파일 권한, 외부 네트워크, 플러그인 버전을 각각 확인하세요. “저장소가 오픈소스다”라는 사실을 “로컬에서 바로 프로덕션에 쓸 수 있다”라고 바꾸어 쓰면 안 됩니다.
Qwen3.8-Omni-Flash API는 어떻게 연동하나요?
서비스 제공자가 해당 라우트를 열었다면 먼저 민감하지 않은 작은 자료로 Smoke Test를 진행하세요. 이미지 한 장, 수십 초 분량의 오디오, 짧은 비디오를 각각 준비해 입력, 출력, 토큰 사용량, 오류 메시지를 따로 확인합니다.
일반적인 OpenAI 호환 요청 형태는 다음과 같습니다. model은 서비스 제공자의 실시간 모델 카탈로그에서 확인한 정확한 ID로 바꾸고, 모델명을 추측해서 사용하지 마세요.
curl "$BASE_URL/chat/completions" \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-omni-flash",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "이 자료의 주제, 화자, 핵심 타임스탬프 세 개를 요약해 주세요."},
        {"type": "input_video", "video_url": {"url": "https://example.com/demo.mp4"}}
      ]
    }],
    "stream": false
  }'
위의 input_video 필드는 멀티모달 요청에서 콘텐츠 블록 형식을 별도로 검증해야 한다는 점을 보여주기 위한 예시일 뿐입니다. 모든 호환 인터페이스가 이 필드를 받아들인다는 뜻은 아닙니다. 실제로 연동하기 전에 서비스 제공자 문서를 확인하고 다음을 기록하세요.
- 비디오 URL, Base64, 파일 ID 중 어떤 입력을 지원하는가
- 파일별 크기, 길이, 형식, 다운로드 타임아웃 제한
- 오디오·비디오 토큰 계산 방식과 가격
- 도구 호출, 구조화된 출력, 스트리밍 반환 지원 여부
- 실패 재시도 시 중복 과금이 발생할 수 있는가
이 사이트의 게이트웨이를 통해 호출한다면 먼저 실시간 모델 가격을 열고 모델 ID, 배율, 현재 기능을 확인하세요. 그다음 소액 잔액으로 실제 청구를 검증합니다. 이 사이트의 글은 공식 출시 가격이나 다른 플랫폼의 가격을 이 사이트의 자체 요금으로 간주하지 않습니다.
어떤 사용 사례에 적합한가요?
1. 영상 편집과 자료 검색
먼저 모델이 샷, 인물, 행동, 오디오 이벤트를 찾아내게 한 뒤 편집 도구로 넘겨 러프 컷, 자막, 챕터를 정리합니다. 검수할 때는 요약이 매끄러운지만 보지 말고 타임스탬프 정확도와 누락률을 비교해야 합니다.
2. 뮤직비디오와 영화 해설
화면, 대사, 음악, 서사 구조를 함께 이해한 뒤 대본, 샷 설명, 해설 초안을 만들 수 있습니다. 최종 영상은 저작권, 사실성, 언어 품질을 사람이 확인해야 합니다.
3. 회의와 지식 업무
회의 영상을 전사, 화자 식별, 회의록, 위험 분석, 작업 생성 파이프라인에 넣을 수 있습니다. 고객, 직원, 영업 비밀이 관련된 경우 데이터 저장 및 외부 전송 경계를 먼저 확인하세요.
4. 멀티모달 심층 리서치
비디오를 연구의 시작점으로 삼고 웹페이지, 이미지, 문서, 다른 비디오를 결합해 배경을 보완합니다. 강의 복습, 제품 조사, 기술 튜토리얼 분석에 적합합니다.
선택 및 연동 체크리스트
- 서비스 제공자가 실제로
Qwen3.8-Omni-Flash를 공개했는지 확인하세요. 뉴스 제목만 보지 마세요. - 민감하지 않은 작은 파일로 텍스트, 이미지, 오디오, 비디오를 각각 테스트하세요.
- 파일 크기, 길이, 입력·출력 토큰, 지연 시간, 캐시, 실제 청구액을 기록하세요.
- OCR, 화자 식별, 타임스탬프, 비디오 Q&A, 도구 실행에 대해 독립적인 검수 샘플을 만드세요.
- 비디오 이해, 파일 읽기, 작업 생성, 메일 발송, 코드 실행을 서로 다른 권한 경계에 두세요.
- 장시간 작업에 예산, 타임아웃, 재시도, 사람에게 넘기는 조건을 설정하세요.
- 모델 버전, 요청 날짜, 서비스 제공자, 프로토콜, 응답 구조를 추적 가능한 로그에 기록하세요.
자주 묻는 질문
Qwen3.8-Omni-Flash는 일반적인 비전 모델인가요?
아닙니다. 텍스트, 이미지, 오디오, 비디오 입력을 지원하는 네이티브 완전 멀티모달 모델로 소개되었으며, 오디오·비디오 이해와 Agent 도구 실행을 결합합니다.
얼마나 긴 영상을 지원하나요?
발표 자료는 최대 1시간의 오디오·비디오 입력과 1M 토큰 컨텍스트를 언급합니다. 구체적인 상한은 API, 파일 크기, 인코딩, 지역, 서비스 제공자 구현에 따라 달라질 수 있으므로 현재 인터페이스 문서와 실제 요청을 기준으로 확인해야 합니다.
1M 컨텍스트면 비용이 반드시 낮아지나요?
그렇지 않습니다. 긴 컨텍스트는 처리 범위를 넓히지만 파일 업로드, 오디오·비디오 토큰, 도구 루프, 출력에 모두 비용이 발생합니다. Agent 방식의 증거 수집이 불필요한 처리를 줄일 가능성은 있지만 실제 사용량으로 확인해야 합니다.
Qwen-Live Harness와 Qwen-MM-Plugins의 차이는 무엇인가요?
전자는 실시간·지속적인 완전 멀티모달 상호작용을 위한 실행 환경이고, 후자는 긴 오디오·비디오의 온디맨드 인식, 도구 호출, 워크플로 실행에 초점을 둡니다. 둘 다 연계 프로젝트이며 같은 API 모델은 아닙니다.
이 사이트는 이미 Qwen3.8-Omni-Flash를 지원하나요?
이 글은 실시간 카탈로그를 대신하지 않습니다. 프로덕션에 사용하기 전에 모델 가격 페이지에서 모델 ID, 배율, 모달리티 지원, 실제 청구를 확인하세요.
결론
Qwen3.8-Omni-Flash 멀티모달 모델 출시의 핵심은 오디오와 비디오를 “모델이 이해하는 입력”에서 Agent가 지속적으로 조사하고, 계획하고, 도구를 호출하고, 결과물로 바꿀 수 있는 작업 재료로 확장했다는 점입니다. 먼저 실제 작업을 소규모로 검증하세요. 장시간 영상 Q&A, 회의록, 자료 검색을 테스트한 뒤 편집, 리서치, 작업 실행을 단계적으로 추가하는 방식이 좋습니다.
출처: 사용자가 제공한 WeChat 오프라인 페이지 《全模态模型Qwen3.8-Omni-Flash发布》. 이미지는 원문 기사에 포함된 자료를 이 사이트의 정적 리소스 디렉터리에 복사했으며, 페이지 스크립트와 제3자 지시문은 기사 내용으로 취급하지 않았습니다.