全模态模型 Qwen3.8-Omni-Flash 发布:能力、API 与音视频 Agent 指南
**全模态模型 Qwen3.8-Omni-Flash 正式上线。**它把文本、图像、音频和视频放进同一条 Agent 工作流,目标不只是“看懂内容”,而是从理解素材、规划任务、调用工具一直推进到交付结果。对需要处理长视频、会议录音、音乐视频和影视素材的开发者,这次发布的重点是音视频 Agent,而不是又一个只会对话的多模态模型。
本文根据 Qwen 大模型公众号发布材料整理,配图保留原文中的发布图和演示图;文章中的评测数字是官方披露结果,不是本站独立复测。模型是否已经出现在本站目录、实际倍率和扣费,以实时模型价格和真实账单为准。
Qwen3.8-Omni-Flash 支持哪些输入?
| 项目 | 发布材料中的信息 |
|---|---|
| 模型名称 | Qwen3.8-Omni-Flash |
| 输入模态 | 文本、图像、音频、视频 |
| 上下文 | 最长 1M Tokens |
| 重点方向 | 音视频 Agent、编程、文本知识工作、GUI 操作 |
| 长程任务 | 长音视频理解、会议纪要与待办、视频研究报告、内容创作 |
| 配套工具 | Qwen-MM-Plugins、Qwen-Live Harness |
模型的实际 API 模型 ID、协议、上下文限制和区域可用性,需要以服务商的当前文档为准。不要因为发布稿提到“全模态”就假定所有兼容式网关都已经支持音频、视频和工具回传;接入时应分别验证文本、图片、音频、视频和工具调用。
官方评测:音视频 Agent 与长程任务提升明显
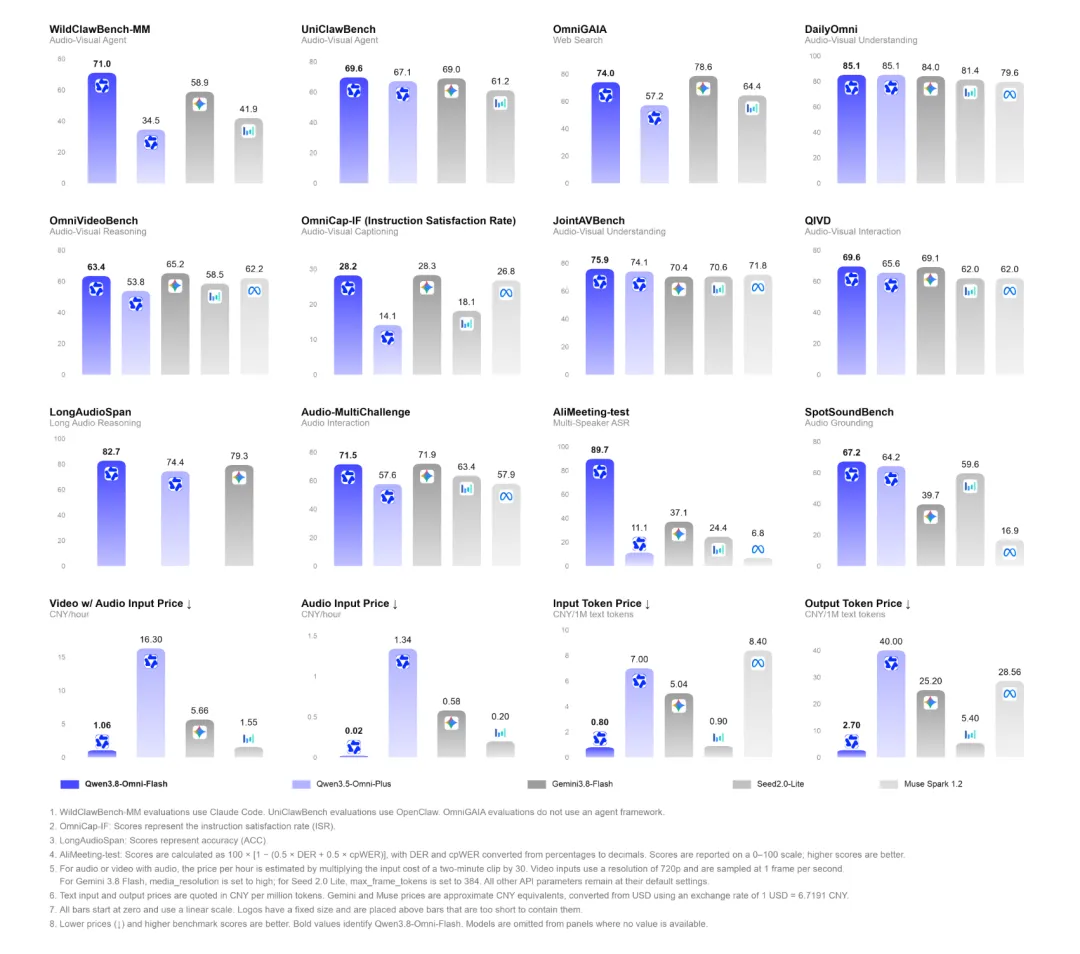
发布材料称,Qwen3.8-Omni-Flash 在累计 30 项评测上,相比上一代 Qwen3.5-Omni-Plus 平均提升超过 26%。其中几个更容易理解的变化是:
- WildClawBench-MM 提升 36.5 分,关注音视频 Agent、编程和长程任务;
- AgenticVBench 提升 22.3 分;
- UniClawBench 得分 69.6;
- LongAudioSpan 提升 8.3 分,OmniVideoBench 提升 9.6 分;
- OmniCap-IF 的 CSR / ISR 分别提升 8.5 / 14.1 分;
- AliMeeting 的 DER / cpWER 从 88.11 / 89.61 降至 3.35 / 17.18。
这些数字应结合测试集、提示词、工具环境和评价指标理解。比如 DER、cpWER 是会议识别相关错误指标,下降通常代表更好;而 Agent benchmark 的分数提升不能直接换算成所有生产任务的成功率。
长上下文不只是“能塞更多视频”
Qwen3.8-Omni-Flash 支持 1M 长序列,但长上下文的价值并不只是上传更大的文件。更实用的变化是,模型可以先根据问题决定“看什么、听什么”,再对相关片段进行由粗到细的多轮取证。
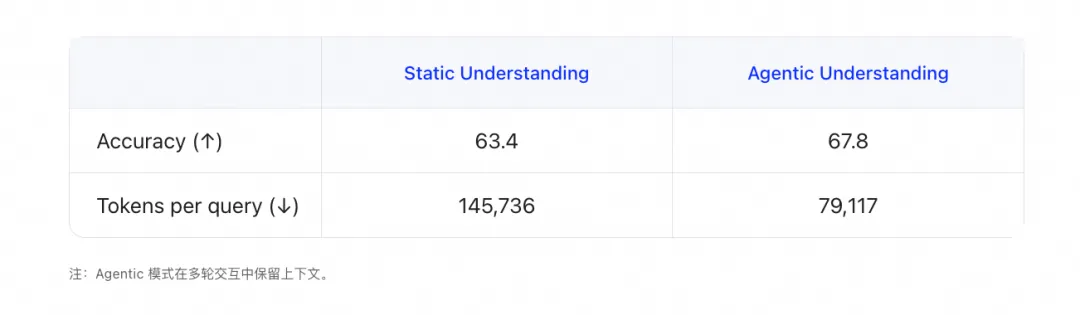
在官方材料引用的 OmniVideoBench 实验中,Agentic Understanding 将准确率从 63.4 提升至 67.8,同时 Token 消耗从 145,736 降至 79,117,下降约 45.7%。这说明主动取证可能减少无关片段的重复处理,但实际成本仍取决于文件时长、音视频编码、工具循环、输出长度和服务商计费方式。
长会议:从记录转向执行
多人会议同时包含画面、声音、说话人切分、指代关系和项目上下文。发布材料称,Qwen3.8-Omni-Flash 支持最长一小时的音视频输入,可联合理解人物画面与语音内容,完成说话人切分、转录和身份对应,再生成会议纪要、待办和风险分析。
接入工具后,工作流可以继续向外延伸,例如发送邮件、整理任务,或根据会议需求开始编码。这里需要把“模型输出建议”和“真正执行外部动作”分开验收:生产环境应为发信、写文件、创建任务和运行代码设置明确的工具权限。
以视频为中心的深度研究
当用户对视频提出具体问题时,答案往往需要结合视频之外的网页、图片、文档和其他视频资料。Qwen3.8-Omni-Flash 可以先提炼视频中的关键问题,再组织多模态资料,形成图文并茂的研究报告。对于教程、课程、产品演示和影视素材,这比单纯生成一段摘要更接近实际工作流。
可控视频描述:同一段素材,不同业务输出不同结果
视频描述不应该只有一种固定答案。内容创作关心叙事,素材检索关心时间片段,资产管理关心人物、镜头、声音和结构化字段。
Qwen3.8-Omni-Flash 的定位是允许调用方控制描述对象、时间范围、信息粒度和输出格式。例如同一段素材可以分别输出:
- 面向编辑的三段式剧情梗概;
- 面向检索的时间戳、人物和关键动作;
- 面向资产库的 JSON 元数据;
- 面向字幕团队的说话人、语言和音频事件列表。
这类能力更适合与结构化输出、文件工具和检索系统一起设计,而不是只在聊天窗口里查看一段自然语言描述。
音视频生产与编辑:模型、工具和运行环境要一起升级
长音视频 Agent 面临的不只是模型能力问题,还包括文件存储、网络传输、多轮推理、时间轴编辑和结果交付。为此,发布材料介绍了两项配套开源项目:
- Qwen-MM-Plugins:面向长音视频的按需感知、工具调用和工作流执行;
- Qwen-Live Harness:面向实时、持续的全模态交互环境。
两者可以理解为不同的运行侧重点:一个更偏长程任务与素材处理,一个更偏实时交互。部署时需要单独核对依赖、显存、文件权限、外部网络和插件版本,不要把“仓库已开源”写成“本地一键可生产”。
Qwen3.8-Omni-Flash API 怎么接入?
如果服务商已经开放对应路由,建议先用一份小型、无敏感信息的素材做 Smoke Test:一张图片、一段几十秒音频、一段短视频,分别测试输入、输出、Token 用量和错误信息。
典型的兼容式 Chat Completions 请求形状如下,model 请替换为服务商实时模型目录中确认过的准确 ID;不要直接猜测模型名:
curl "$BASE_URL/chat/completions" \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-omni-flash",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "总结这段素材的主题、说话人和三个关键时间点。"},
        {"type": "input_video", "video_url": {"url": "https://example.com/demo.mp4"}}
      ]
    }],
    "stream": false
  }'
上面的 input_video 仅用于说明多模态请求需要单独验证内容块格式,不代表所有兼容接口都接受这个字段。真实接入前应查看服务商文档,并分别记录:
- 接口是否支持视频 URL、Base64 或文件 ID;
- 单文件大小、时长、格式和下载超时限制;
- 音频/视频 Token 的计算方式与价格;
- 是否支持工具调用、结构化输出和流式返回;
- 失败重试是否会重复扣费。
如果你通过本站网关调用,请先打开实时模型价格,确认模型 ID、倍率和当前能力,再用小额余额验证真实账单。本站文章不会把官方发布价或其他平台价格直接当成本网站报价。
适合哪些场景?
1. 视频剪辑和素材检索
让模型先定位镜头、人物、动作和音频事件,再交给剪辑工具进行粗剪、字幕和章节整理。验收时应比较时间戳准确性和漏检率,而不只是看摘要读起来是否流畅。
2. 音乐视频与影视解说
模型可以同时理解画面、对白、音乐和叙事结构,再生成脚本、镜头说明或解说草稿。最终成片仍需要人工进行版权、事实和语言质量检查。
3. 会议和知识工作
会议视频可以进入转录、说话人识别、纪要、风险分析和任务创建流水线。涉及客户、员工或商业机密时,必须先确认数据存储与外部传输边界。
4. 多模态深度研究
把视频作为研究入口,结合网页、图片、文档和其他视频补充背景,适合课程复盘、产品调研和技术教程分析。
选型与接入清单
- 先确认服务商是否真的开放
Qwen3.8-Omni-Flash,不要只看新闻标题。 - 用无敏感的小文件分别测试文本、图片、音频和视频。
- 记录文件大小、时长、输入/输出 Tokens、延迟、缓存与实际扣费。
- 为 OCR、说话人识别、时间戳、视频问答和工具执行建立独立验收样本。
- 将视频理解、文件读取、任务创建、发信和代码执行放在不同权限边界内。
- 对长任务设置预算、超时、重试和人工接管条件。
- 将模型版本、请求日期、服务商、协议和返回结构写入可追溯日志。
常见问题
Qwen3.8-Omni-Flash 是普通视觉模型吗?
不是。它的发布定位是原生全模态模型,输入覆盖文本、图像、音频和视频,并把音视频理解与 Agent 工具执行结合起来。
它支持多长的视频?
发布材料提到最长一小时的音视频输入,以及 1M 长上下文。具体上限仍可能受 API、文件大小、编码、区域和服务商实现影响,应以当前接口文档和实际请求为准。
1M 上下文是否代表成本一定更低?
不代表。长上下文扩大了可处理范围,但文件上传、音视频 Token、工具循环和输出都会产生成本。Agentic 取证有机会减少无关处理,但必须通过真实用量验证。
Qwen-Live Harness 和 Qwen-MM-Plugins 有什么区别?
前者面向实时、持续的全模态交互运行环境;后者面向长音视频的按需感知、工具调用和工作流执行。两者都是配套项目,不等同于同一个 API 模型。
本站已经支持 Qwen3.8-Omni-Flash 吗?
文章不替代实时目录。请查看模型价格页,确认模型 ID、倍率、模态能力和实际账单后再用于生产。
结论
全模态模型 Qwen3.8-Omni-Flash 的重点,是把音视频从“被模型理解的输入”推进为 Agent 可以持续取证、规划、调用工具并交付结果的工作载体。它适合用小范围真实任务验证:先测长视频问答、会议纪要和素材检索,再逐步加入剪辑、研究和任务执行。
发布来源:用户提供的《全模态模型 Qwen3.8-Omni-Flash 发布》公众号离线页面;图片为该页面中的原文配图,已复制到本站静态资源目录,未把页面脚本或第三方指令当作文章内容。