Qwen3.8-Omni-Flash: lanzamiento, capacidades, API y guía de agentes de audio y vídeo
El modelo multimodal Qwen3.8-Omni-Flash ya se ha lanzado oficialmente. Reúne texto, imágenes, audio y vídeo en el mismo flujo de trabajo de un agente. Su objetivo no es solo «entender» el contenido, sino avanzar desde el análisis del material hasta la planificación, las llamadas a herramientas y la entrega del resultado. Para los desarrolladores que trabajan con vídeos largos, grabaciones de reuniones, vídeos musicales y material audiovisual, la novedad principal es el agente de audio y vídeo, no otro modelo multimodal limitado a conversar.
Este artículo resume el material publicado en la cuenta oficial de Qwen en WeChat. Las imágenes conservan las ilustraciones de lanzamiento y demostración del artículo original; las cifras de evaluación son resultados comunicados por el proveedor y no una medición independiente de este sitio. La disponibilidad del modelo en el catálogo, su multiplicador y el importe real cobrado deben comprobarse en la página de precios en tiempo real y en el recibo real.
¿Qué entradas admite Qwen3.8-Omni-Flash?
| Elemento | Información de la publicación |
|---|---|
| Nombre del modelo | Qwen3.8-Omni-Flash |
| Modalidades de entrada | Texto, imagen, audio y vídeo |
| Contexto | Hasta 1M de tokens |
| Áreas principales | Agentes de audio y vídeo, programación, trabajo documental y operaciones GUI |
| Tareas largas | Comprensión de audio y vídeo largo, actas y tareas de reuniones, informes de investigación en vídeo, creación de contenido |
| Herramientas asociadas | Qwen-MM-Plugins, Qwen-Live Harness |
El identificador real de la API, el protocolo, el límite de contexto y la disponibilidad por región dependen de la documentación vigente del proveedor. No des por hecho que todas las pasarelas compatibles con OpenAI ya admiten audio, vídeo y devolución de herramientas solo porque la publicación hable de «multimodalidad completa». Hay que validar por separado texto, imágenes, audio, vídeo y llamadas a herramientas.
Benchmarks oficiales: avances en agentes de audio y vídeo y tareas largas
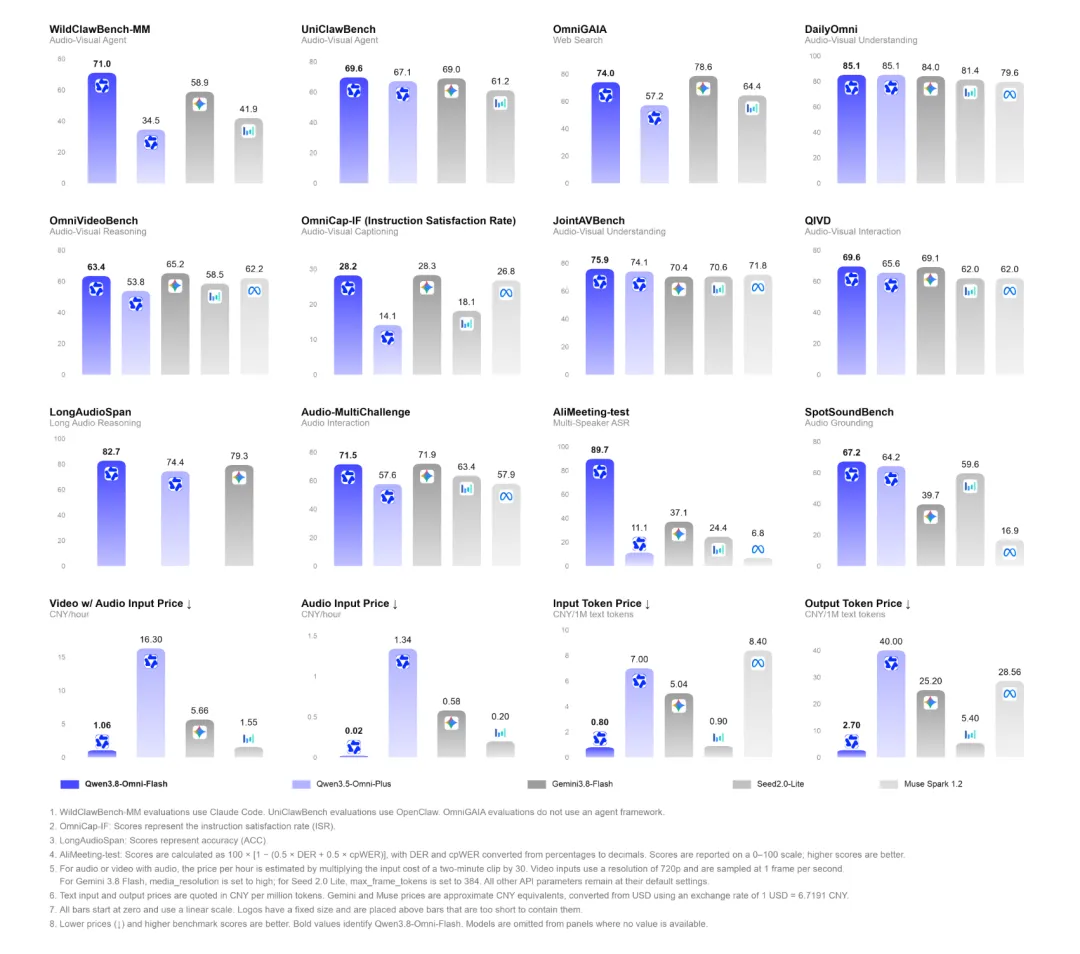
La publicación afirma que Qwen3.8-Omni-Flash mejora una media de más del 26 % en un total acumulado de 30 evaluaciones frente a Qwen3.5-Omni-Plus. Algunos cambios más fáciles de interpretar son:
- WildClawBench-MM sube 36,5 puntos y evalúa agentes de audio y vídeo, programación y tareas largas;
- AgenticVBench sube 22,3 puntos;
- UniClawBench alcanza 69,6;
- LongAudioSpan sube 8,3 puntos y OmniVideoBench 9,6 puntos;
- el CSR / ISR de OmniCap-IF mejora 8,5 / 14,1 puntos, respectivamente;
- en AliMeeting, el DER / cpWER baja de 88,11 / 89,61 a 3,35 / 17,18.
Estas cifras deben leerse junto con el conjunto de pruebas, los prompts, el entorno de herramientas y las métricas utilizadas. DER y cpWER son indicadores de error relacionados con el reconocimiento de reuniones; normalmente, una reducción es mejor. En cambio, una mejora en un benchmark de agentes no se puede convertir directamente en una tasa de éxito para todas las tareas de producción.
El contexto largo no consiste solo en «meter más vídeo»
Qwen3.8-Omni-Flash admite secuencias de hasta 1M, pero el valor del contexto largo no se reduce a subir archivos más grandes. El cambio más práctico es que el modelo puede decidir, según la pregunta, qué debe ver y escuchar, y después examinar los fragmentos relevantes en varias rondas, de lo general a lo específico.
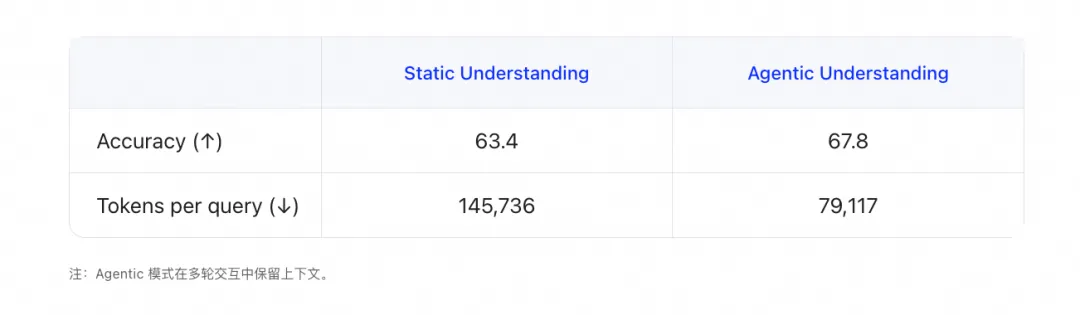
En el experimento de OmniVideoBench citado por el material oficial, Agentic Understanding eleva la precisión de 63,4 a 67,8, mientras que el consumo de tokens baja de 145.736 a 79.117, una reducción aproximada del 45,7 %. Esto indica que la búsqueda activa de evidencias puede reducir el reprocesamiento de fragmentos irrelevantes, aunque el coste real sigue dependiendo de la duración del archivo, la codificación de audio y vídeo, los ciclos de herramientas, la longitud de salida y la facturación del proveedor.
Reuniones largas: de tomar notas a ejecutar acciones
Una reunión combina imágenes, voces, separación de hablantes, referencias y contexto del proyecto. La publicación indica que Qwen3.8-Omni-Flash admite hasta una hora de entrada de audio y vídeo, puede comprender conjuntamente las personas que aparecen y el contenido hablado, separar a los hablantes, transcribir y asociar identidades, y después generar actas, tareas pendientes y análisis de riesgos.
Con herramientas, el flujo puede continuar: enviar un correo, organizar tareas o empezar a programar según las necesidades de la reunión. Hay que separar las recomendaciones del modelo de la ejecución real de acciones externas: en producción, el envío de correos, la escritura de archivos, la creación de tareas y la ejecución de código deben tener permisos explícitos.
Investigación profunda centrada en el vídeo
Cuando un usuario formula una pregunta concreta sobre un vídeo, la respuesta suele necesitar también páginas web, imágenes, documentos y otros vídeos. Qwen3.8-Omni-Flash puede extraer primero las preguntas clave del vídeo, organizar después materiales multimodales y generar un informe de investigación con texto e imágenes. Para tutoriales, cursos, demostraciones de producto y material audiovisual, esto se acerca más al flujo de trabajo real que un simple resumen.
Descripción de vídeo controlable: el mismo material, distintas salidas para cada negocio
La descripción de un vídeo no debería tener una única forma fija. La creación de contenido necesita narración, la búsqueda de recursos necesita segmentos temporales y la gestión de activos necesita personas, planos, sonidos y campos estructurados.
Qwen3.8-Omni-Flash está orientado a permitir que quien realiza la llamada controle los objetos descritos, el intervalo temporal, el nivel de detalle y el formato de salida. Un mismo material puede producir, por ejemplo:
- una sinopsis en tres partes para un editor;
- marcas de tiempo, personas y acciones clave para búsquedas;
- metadatos JSON para una biblioteca de activos;
- una lista de hablantes, idiomas y eventos de audio para un equipo de subtitulado.
Esta capacidad encaja mejor con salidas estructuradas, herramientas de archivos y sistemas de búsqueda que con una simple descripción en lenguaje natural dentro de una ventana de chat.
Producción y edición de audio y vídeo: modelo, herramientas y entorno deben evolucionar juntos
Un agente para audio y vídeo largos no depende solo de la capacidad del modelo. También hay que resolver el almacenamiento de archivos, la transferencia de red, la inferencia en varias rondas, la edición de la línea de tiempo y la entrega del resultado. La publicación presenta dos proyectos open source asociados:
- Qwen-MM-Plugins: percepción bajo demanda, llamadas a herramientas y ejecución de flujos de trabajo para audio y vídeo largos;
- Qwen-Live Harness: entorno de interacción multimodal completa en tiempo real y de forma continua.
Se pueden entender como dos enfoques de ejecución: uno está más orientado a tareas largas y procesamiento de material, y el otro a la interacción en tiempo real. Antes de desplegar, comprueba por separado dependencias, memoria de GPU, permisos de archivos, red externa y versiones de los plugins. Que un repositorio sea open source no significa que esté listo para producción con un clic.
¿Cómo integrar la API de Qwen3.8-Omni-Flash?
Si el proveedor ya ha abierto la ruta correspondiente, empieza con archivos pequeños y sin información sensible: una imagen, unas decenas de segundos de audio y un vídeo corto. Prueba por separado entradas, salidas, uso de tokens y mensajes de error.
Una petición típica compatible con OpenAI tiene este aspecto. Sustituye model por el identificador exacto confirmado en el catálogo actualizado del proveedor; no adivines el nombre del modelo:
curl "$BASE_URL/chat/completions" \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-omni-flash",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "Resume el tema, los hablantes y tres momentos clave de este material."},
        {"type": "input_video", "video_url": {"url": "https://example.com/demo.mp4"}}
      ]
    }],
    "stream": false
  }'
input_video solo sirve para mostrar que una petición multimodal requiere validar por separado el formato de cada bloque de contenido; no todas las interfaces compatibles aceptan necesariamente este campo. Antes de una integración real, revisa la documentación del proveedor y registra por separado:
- si la interfaz admite una URL de vídeo, Base64 o un ID de archivo;
- los límites de tamaño, duración, formato y tiempo de espera de descarga;
- cómo se calculan y cobran los tokens de audio y vídeo;
- si admite llamadas a herramientas, salida estructurada y streaming;
- si un reintento tras un fallo puede generar un cobro duplicado.
Si llamas a la pasarela de este sitio, abre primero la página de precios en tiempo real, confirma el ID del modelo, el multiplicador y las capacidades, y verifica la factura real con un saldo pequeño. Este artículo no convierte el precio anunciado por el proveedor ni el de otra plataforma en el precio de este sitio.
¿Para qué escenarios es adecuado?
1. Edición de vídeo y búsqueda de material
Pide al modelo que localice primero planos, personas, acciones y eventos de audio, y entrega después el resultado a una herramienta de edición para hacer el primer montaje, los subtítulos y los capítulos. En la aceptación hay que comparar la precisión de las marcas de tiempo y la tasa de omisiones, no solo si el resumen suena fluido.
2. Vídeos musicales y narración audiovisual
El modelo puede comprender a la vez imágenes, diálogos, música y estructura narrativa, y generar guiones, indicaciones de planos o un borrador de narración. El resultado final todavía necesita una revisión humana de derechos, hechos y calidad lingüística.
3. Reuniones y trabajo del conocimiento
Los vídeos de reuniones pueden alimentar una cadena de transcripción, identificación de hablantes, actas, análisis de riesgos y creación de tareas. Cuando haya información de clientes, empleados o secretos comerciales, hay que confirmar primero los límites de almacenamiento y transferencia externa.
4. Investigación multimodal profunda
Usa el vídeo como punto de entrada y complétalo con páginas web, imágenes, documentos y otros vídeos. Es útil para revisar cursos, investigar productos y analizar tutoriales técnicos.
Lista de comprobación para elegir e integrar
- Confirma primero que el proveedor ofrece realmente
Qwen3.8-Omni-Flash; no te bases solo en el titular de una noticia. - Prueba texto, imagen, audio y vídeo por separado con archivos pequeños y sin datos sensibles.
- Registra tamaño y duración de los archivos, tokens de entrada y salida, latencia, caché y el importe realmente cobrado.
- Crea muestras de aceptación independientes para OCR, identificación de hablantes, marcas de tiempo, preguntas sobre vídeo y ejecución de herramientas.
- Mantén separados los permisos para comprender vídeo, leer archivos, crear tareas, enviar correos y ejecutar código.
- Define para las tareas largas un presupuesto, un tiempo de espera, reglas de reintento y condiciones para la intervención humana.
- Registra de forma trazable la versión del modelo, la fecha de la solicitud, el proveedor, el protocolo y la estructura de la respuesta.
Preguntas frecuentes
¿Qwen3.8-Omni-Flash es un modelo de visión convencional?
No. Se presenta como un modelo multimodal nativo con entradas de texto, imagen, audio y vídeo, que conecta la comprensión de audio y vídeo con la ejecución de herramientas de un agente.
¿Qué duración de vídeo admite?
La publicación menciona hasta una hora de entrada de audio y vídeo y un contexto de 1M. El límite concreto puede depender de la API, el tamaño del archivo, la codificación, la región y la implementación del proveedor; compruébalo en la documentación vigente y con una petición real.
¿Un contexto de 1M significa que el coste será necesariamente menor?
No. El contexto largo amplía el alcance procesable, pero la subida de archivos, los tokens de audio y vídeo, los ciclos de herramientas y la salida siguen generando costes. La búsqueda activa puede reducir el procesamiento irrelevante, pero hay que validarlo con el consumo real.
¿Qué diferencia hay entre Qwen-Live Harness y Qwen-MM-Plugins?
El primero se centra en un entorno de interacción multimodal completa, continua y en tiempo real; el segundo, en percepción bajo demanda, llamadas a herramientas y ejecución de flujos para audio y vídeo largos. Son proyectos asociados y no dos nombres de la misma API.
¿Este sitio ya admite Qwen3.8-Omni-Flash?
Este artículo no sustituye al catálogo en tiempo real. Consulta la página de modelos y precios para confirmar el ID, el multiplicador, las modalidades y la factura real antes de usarlo en producción.
Conclusión
La idea central del modelo multimodal Qwen3.8-Omni-Flash es convertir el audio y el vídeo de simples entradas que el modelo comprende en materiales de trabajo que un agente puede investigar, planificar, procesar con herramientas y transformar en entregables. Empieza validando tareas reales a pequeña escala —preguntas sobre vídeos largos, actas de reuniones y búsqueda de material— y añade después edición, investigación y ejecución de tareas de forma gradual.
Fuente: página de WeChat sin conexión proporcionada por el usuario, titulada «全模态模型 Qwen3.8-Omni-Flash 发布». Las imágenes proceden de la publicación original y se copiaron a los recursos estáticos del sitio; los scripts de la página y las instrucciones de terceros no se trataron como contenido editorial.