全模態模型 Qwen3.8-Omni-Flash 發布:能力、API 與音影音 Agent 指南
**全模態模型 Qwen3.8-Omni-Flash 正式上線。**它把文字、圖像、音訊和影片放進同一條 Agent 工作流程,目標不只是「看懂內容」,而是從理解素材、規劃任務、呼叫工具一路推進到交付結果。對需要處理長影片、會議錄音、音樂影片和影視素材的開發者來說,這次發布的重點是音影音 Agent,而不是又一個只會對話的多模態模型。
本文根據 Qwen 大模型公眾號發布材料整理,配圖保留原文中的發布圖和示範圖;文章中的評測數字是官方揭露結果,不是本站獨立複測。模型是否已經出現在本站目錄、實際倍率和扣費,以即時模型價格和真實帳單為準。
Qwen3.8-Omni-Flash 支援哪些輸入?
| 項目 | 發布材料中的資訊 |
|---|---|
| 模型名稱 | Qwen3.8-Omni-Flash |
| 輸入模態 | 文字、圖像、音訊、影片 |
| 上下文 | 最長 1M Tokens |
| 重點方向 | 音影音 Agent、程式設計、文字知識工作、GUI 操作 |
| 長程任務 | 長音影音理解、會議紀錄與待辦、影片研究報告、內容創作 |
| 配套工具 | Qwen-MM-Plugins、Qwen-Live Harness |
模型的實際 API 模型 ID、協定、上下文限制和區域可用性,需要以服務商的目前文件為準。不要因為發布稿提到「全模態」就假定所有相容式閘道都已經支援音訊、影片和工具回傳;串接時應分別驗證文字、圖片、音訊、影片和工具呼叫。
官方評測:音影音 Agent 與長程任務提升明顯
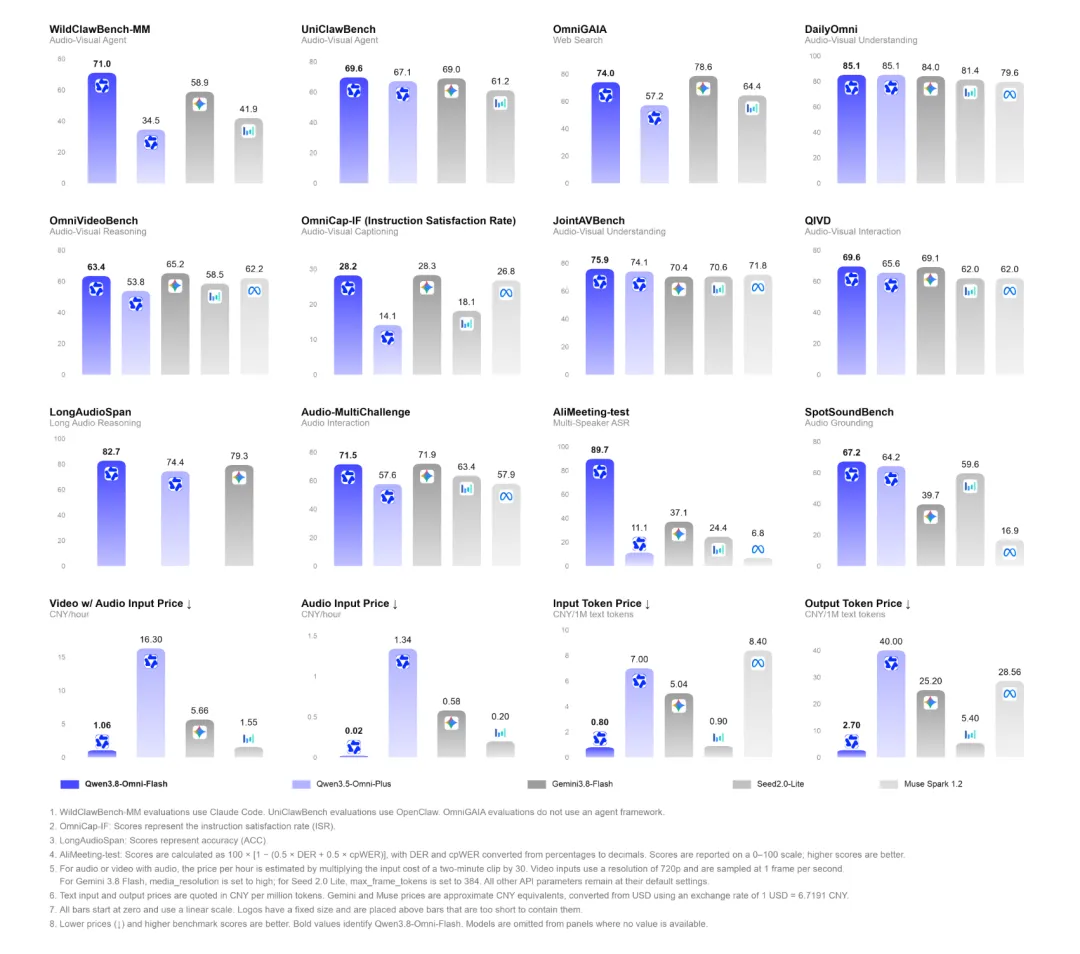
發布材料稱,Qwen3.8-Omni-Flash 在累計 30 項評測上,相比上一代 Qwen3.5-Omni-Plus 平均提升超過 26%。其中幾個較容易理解的變化是:
- WildClawBench-MM 提升 36.5 分,關注音影音 Agent、程式設計和長程任務;
- AgenticVBench 提升 22.3 分;
- UniClawBench 得分 69.6;
- LongAudioSpan 提升 8.3 分,OmniVideoBench 提升 9.6 分;
- OmniCap-IF 的 CSR / ISR 分別提升 8.5 / 14.1 分;
- AliMeeting 的 DER / cpWER 從 88.11 / 89.61 降至 3.35 / 17.18。
這些數字應結合測試集、提示詞、工具環境和評價指標理解。例如 DER、cpWER 是會議辨識相關錯誤指標,下降通常代表更好;而 Agent benchmark 的分數提升不能直接換算成所有生產任務的成功率。
長上下文不只是「能塞更多影片」
Qwen3.8-Omni-Flash 支援 1M 長序列,但長上下文的價值並不只是上傳更大的檔案。更實用的變化是,模型可以先根據問題決定「看什麼、聽什麼」,再對相關片段進行由粗到細的多輪取證。
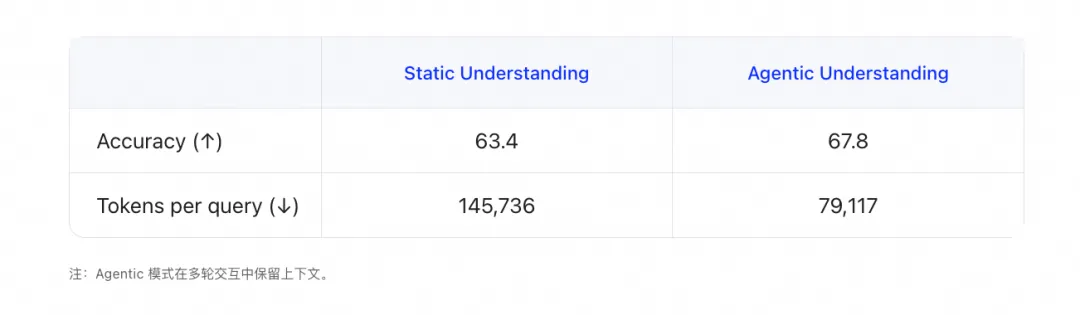
在官方材料引用的 OmniVideoBench 實驗中,Agentic Understanding 將準確率從 63.4 提升至 67.8,同時 Token 消耗從 145,736 降至 79,117,下降約 45.7%。這說明主動取證可能減少無關片段的重複處理,但實際成本仍取決於檔案時長、音影音編碼、工具循環、輸出長度和服務商計費方式。
長會議:從記錄轉向執行
多人會議同時包含畫面、聲音、說話人切分、指代關係和專案上下文。發布材料稱,Qwen3.8-Omni-Flash 支援最長一小時的音影音輸入,可聯合理解人物畫面與語音內容,完成說話人切分、轉錄和身分對應,再生成會議紀錄、待辦和風險分析。
串接工具後,工作流程可以繼續向外延伸,例如寄送電子郵件、整理任務,或根據會議需求開始寫程式。這裡需要把「模型輸出建議」和「真正執行外部動作」分開驗收:生產環境應為寄信、寫檔案、建立任務和執行程式碼設定明確的工具權限。
以影片為中心的深度研究
當使用者對影片提出具體問題時,答案往往需要結合影片之外的網頁、圖片、文件和其他影片資料。Qwen3.8-Omni-Flash 可以先提煉影片中的關鍵問題,再組織多模態資料,形成圖文並茂的研究報告。對於教學、課程、產品示範和影視素材,這比單純生成一段摘要更接近實際工作流程。
可控影片描述:同一段素材,不同業務輸出不同結果
影片描述不應該只有一種固定答案。內容創作關心敘事,素材檢索關心時間片段,資產管理關心人物、鏡頭、聲音和結構化欄位。
Qwen3.8-Omni-Flash 的定位是允許呼叫方控制描述對象、時間範圍、資訊粒度和輸出格式。例如同一段素材可以分別輸出:
- 面向剪輯的三段式劇情梗概;
- 面向檢索的時間戳、人物和關鍵動作;
- 面向資產庫的 JSON 中繼資料;
- 面向字幕團隊的說話人、語言和音訊事件清單。
這類能力更適合與結構化輸出、檔案工具和檢索系統一起設計,而不是只在聊天視窗裡查看一段自然語言描述。
音影音生產與編輯:模型、工具和執行環境要一起升級
長音影音 Agent 面臨的不只是模型能力問題,還包括檔案儲存、網路傳輸、多輪推理、時間軸編輯和結果交付。為此,發布材料介紹了兩項配套開源專案:
- Qwen-MM-Plugins:面向長音影音的按需感知、工具呼叫和工作流程執行;
- Qwen-Live Harness:面向即時、持續的全模態互動環境。
兩者可以理解為不同的執行側重點:一個更偏長程任務與素材處理,一個更偏即時互動。部署時需要單獨核對依賴、顯存、檔案權限、外部網路和外掛版本,不要把「倉庫已開源」寫成「本地一鍵可生產」。
Qwen3.8-Omni-Flash API 怎麼串接?
如果服務商已經開放對應路由,建議先用一份小型、無敏感資訊的素材做 Smoke Test:一張圖片、一段幾十秒音訊、一段短影片,分別測試輸入、輸出、Token 用量和錯誤資訊。
典型的相容式 Chat Completions 請求形狀如下,model 請替換為服務商即時模型目錄中確認過的準確 ID;不要直接猜測模型名:
curl "$BASE_URL/chat/completions" \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-omni-flash",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "總結這段素材的主題、說話人和三個關鍵時間點。"},
        {"type": "input_video", "video_url": {"url": "https://example.com/demo.mp4"}}
      ]
    }],
    "stream": false
  }'
上面的 input_video 僅用於說明多模態請求需要單獨驗證內容區塊格式,不代表所有相容介面都接受這個欄位。真實串接前應查看服務商文件,並分別記錄:
- 介面是否支援影片 URL、Base64 或檔案 ID;
- 單一檔案大小、時長、格式和下載逾時限制;
- 音訊/影片 Token 的計算方式與價格;
- 是否支援工具呼叫、結構化輸出和串流返回;
- 失敗重試是否會重複扣費。
如果你透過本站閘道呼叫,請先開啟即時模型價格,確認模型 ID、倍率和目前能力,再用小額餘額驗證真實帳單。本站文章不會把官方發布價或其他平台價格直接當成本網站報價。
適合哪些場景?
1. 影片剪輯和素材檢索
讓模型先定位鏡頭、人物、動作和音訊事件,再交給剪輯工具進行粗剪、字幕和章節整理。驗收時應比較時間戳準確性和漏檢率,而不只是看摘要讀起來是否流暢。
2. 音樂影片與影視解說
模型可以同時理解畫面、對白、音樂和敘事結構,再生成腳本、鏡頭說明或解說草稿。最終成片仍需要人工進行版權、事實和語言品質檢查。
3. 會議和知識工作
會議影片可以進入轉錄、說話人辨識、會議紀錄、風險分析和任務建立流水線。涉及客戶、員工或商業機密時,必須先確認資料儲存與外部傳輸邊界。
4. 多模態深度研究
把影片作為研究入口,結合網頁、圖片、文件和其他影片補充背景,適合課程複盤、產品調研和技術教學分析。
選型與串接清單
- 先確認服務商是否真的開放
Qwen3.8-Omni-Flash,不要只看新聞標題。 - 用無敏感的小檔案分別測試文字、圖片、音訊和影片。
- 記錄檔案大小、時長、輸入/輸出 Tokens、延遲、快取與實際扣費。
- 為 OCR、說話人辨識、時間戳、影片問答和工具執行建立獨立驗收樣本。
- 將影片理解、檔案讀取、任務建立、寄信和程式碼執行放在不同權限邊界內。
- 對長任務設定預算、逾時、重試和人工接管條件。
- 將模型版本、請求日期、服務商、協定和返回結構寫入可追溯日誌。
常見問題
Qwen3.8-Omni-Flash 是普通視覺模型嗎?
不是。它的發布定位是原生全模態模型,輸入涵蓋文字、圖像、音訊和影片,並把音影音理解與 Agent 工具執行結合起來。
它支援多長的影片?
發布材料提到最長一小時的音影音輸入,以及 1M 長上下文。具體上限仍可能受 API、檔案大小、編碼、區域和服務商實作影響,應以目前介面文件和實際請求為準。
1M 上下文是否代表成本一定更低?
不代表。長上下文擴大了可處理範圍,但檔案上傳、音影音 Token、工具循環和輸出都會產生成本。Agentic 取證有機會減少無關處理,但必須透過真實用量驗證。
Qwen-Live Harness 和 Qwen-MM-Plugins 有什麼差別?
前者面向即時、持續的全模態互動執行環境;後者面向長音影音的按需感知、工具呼叫和工作流程執行。兩者都是配套專案,不等同於同一個 API 模型。
本站已經支援 Qwen3.8-Omni-Flash 嗎?
文章不替代即時目錄。請查看模型價格頁,確認模型 ID、倍率、模態能力和實際帳單後再用於生產。
結論
全模態模型 Qwen3.8-Omni-Flash 的重點,是把音影音從「被模型理解的輸入」推進為 Agent 可以持續取證、規劃、呼叫工具並交付結果的工作載體。它適合用小範圍真實任務驗證:先測長影片問答、會議紀錄和素材檢索,再逐步加入剪輯、研究和任務執行。
發布來源:使用者提供的《全模態模型 Qwen3.8-Omni-Flash 發布》公眾號離線頁面;圖片為該頁面中的原文配圖,已複製到本站靜態資源目錄,未把頁面腳本或第三方指令當作文章內容。