Pelancaran Model Omnimodal Qwen3.8-Omni-Flash: Keupayaan, API dan Panduan Agent Audio-Video
Model omnimodal Qwen3.8-Omni-Flash kini dilancarkan secara rasmi. Ia menggabungkan teks, imej, audio dan video ke dalam satu aliran kerja Agent yang sama, dengan matlamat bukan sekadar "memahami kandungan", tetapi bergerak daripada memahami bahan, merancang tugasan, memanggil alat sehinggalah menyerahkan hasil. Untuk pembangun yang perlu memproses video panjang, rakaman mesyuarat, video muzik dan bahan filem atau televisyen, fokus utama pelancaran ini ialah Agent audio-video, bukan sekadar satu lagi model multimodal yang hanya boleh berbual.
Artikel ini disusun berdasarkan bahan yang diterbitkan oleh akaun rasmi Qwen; imej yang disertakan mengekalkan imej pelancaran dan demonstrasi daripada artikel asal. Angka penilaian dalam artikel ini ialah keputusan yang didedahkan secara rasmi, bukan ujian semula bebas oleh laman ini. Sama ada model ini sudah muncul dalam direktori laman ini, kadar sebenar dan caj penggunaan hendaklah merujuk kepada harga model masa nyata serta bil sebenar.
Apakah input yang disokong oleh Qwen3.8-Omni-Flash?
| Item | Maklumat dalam bahan pelancaran |
|---|---|
| Nama model | Qwen3.8-Omni-Flash |
| Modaliti input | Teks, imej, audio, video |
| Konteks | Sehingga 1M Tokens |
| Fokus utama | Agent audio-video, pengaturcaraan, kerja pengetahuan berasaskan teks, operasi GUI |
| Tugasan jangka panjang | Pemahaman audio-video panjang, minit mesyuarat dan tugasan susulan, laporan penyelidikan video, penciptaan kandungan |
| Alat sokongan | Qwen-MM-Plugins, Qwen-Live Harness |
ID model API sebenar, protokol, had konteks dan ketersediaan mengikut rantau perlu dirujuk kepada dokumentasi semasa penyedia perkhidmatan. Jangan menganggap semua gerbang serasi sudah menyokong audio, video dan pulangan alat hanya kerana bahan pelancaran menyebut "omnimodal"; semasa integrasi, teks, imej, audio, video dan panggilan alat perlu disahkan secara berasingan.
Penilaian rasmi: peningkatan ketara untuk Agent audio-video dan tugasan jangka panjang
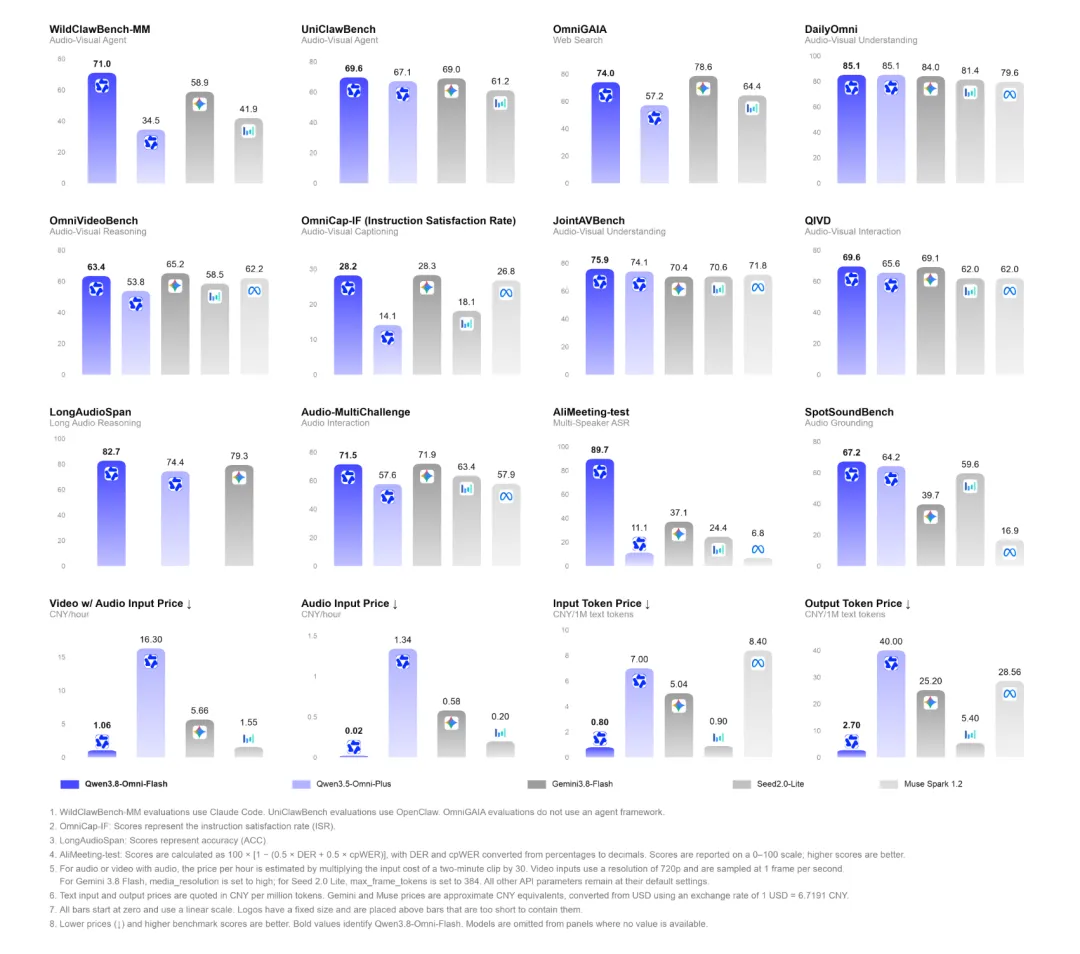
Menurut bahan pelancaran, Qwen3.8-Omni-Flash mencatat peningkatan purata lebih 26% berbanding generasi sebelumnya, Qwen3.5-Omni-Plus, merentas 30 penilaian terkumpul. Antara perubahan yang lebih mudah difahami ialah:
- WildClawBench-MM meningkat 36.5 mata, dengan tumpuan pada Agent audio-video, pengaturcaraan dan tugasan jangka panjang;
- AgenticVBench meningkat 22.3 mata;
- UniClawBench mencatat skor 69.6;
- LongAudioSpan meningkat 8.3 mata, OmniVideoBench meningkat 9.6 mata;
- CSR / ISR untuk OmniCap-IF masing-masing meningkat 8.5 / 14.1 mata;
- DER / cpWER untuk AliMeeting turun daripada 88.11 / 89.61 kepada 3.35 / 17.18.
Angka ini perlu difahami bersama set ujian, prompt, persekitaran alat dan metrik penilaian. Sebagai contoh, DER dan cpWER ialah metrik ralat berkaitan pengecaman mesyuarat, dan penurunan biasanya menandakan hasil yang lebih baik; namun peningkatan skor dalam benchmark Agent tidak boleh terus ditukar kepada kadar kejayaan semua tugasan produksi.
Konteks panjang bukan sekadar "boleh memasukkan lebih banyak video"
Qwen3.8-Omni-Flash menyokong jujukan panjang 1M, tetapi nilai konteks panjang bukan hanya untuk memuat naik fail yang lebih besar. Perubahan yang lebih praktikal ialah model boleh terlebih dahulu menentukan "apa yang perlu dilihat dan didengar" berdasarkan soalan, kemudian menjalankan beberapa pusingan pengumpulan bukti daripada gambaran kasar kepada butiran halus pada segmen yang berkaitan.
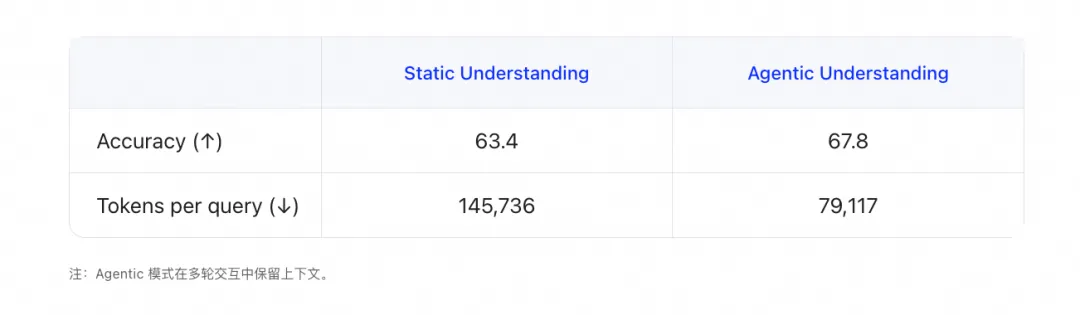
Dalam eksperimen OmniVideoBench yang dirujuk oleh bahan rasmi, Agentic Understanding meningkatkan ketepatan daripada 63.4 kepada 67.8, sambil mengurangkan penggunaan Token daripada 145,736 kepada 79,117, iaitu penurunan kira-kira 45.7%. Ini menunjukkan pengumpulan bukti secara aktif berpotensi mengurangkan pemprosesan berulang bagi segmen yang tidak berkaitan, tetapi kos sebenar masih bergantung pada tempoh fail, pengekodan audio-video, kitaran alat, panjang output dan kaedah pengebilan penyedia perkhidmatan.
Mesyuarat panjang: daripada merekod kepada melaksanakan
Mesyuarat berbilang peserta merangkumi visual, suara, pemisahan penutur, hubungan rujukan dan konteks projek pada masa yang sama. Menurut bahan pelancaran, Qwen3.8-Omni-Flash menyokong input audio-video sehingga satu jam, boleh memahami visual individu dan kandungan pertuturan secara gabungan, melakukan pemisahan penutur, transkripsi dan pemadanan identiti, kemudian menjana minit mesyuarat, tugasan susulan dan analisis risiko.
Selepas alat diintegrasikan, aliran kerja boleh diteruskan ke luar, seperti menghantar e-mel, menyusun tugasan atau mula menulis kod berdasarkan keperluan mesyuarat. Di sini, "cadangan output model" dan "pelaksanaan sebenar tindakan luaran" perlu dinilai secara berasingan: persekitaran produksi harus menetapkan kebenaran alat yang jelas untuk penghantaran e-mel, penulisan fail, penciptaan tugasan dan pelaksanaan kod.
Penyelidikan mendalam berpusatkan video
Apabila pengguna mengemukakan soalan khusus tentang video, jawapan lazimnya perlu digabungkan dengan laman web, imej, dokumen dan bahan video lain di luar video tersebut. Qwen3.8-Omni-Flash boleh terlebih dahulu mengekstrak persoalan utama dalam video, kemudian menyusun bahan multimodal untuk menghasilkan laporan penyelidikan yang lengkap dengan teks dan visual. Untuk tutorial, kursus, demonstrasi produk dan bahan filem atau televisyen, ini lebih hampir kepada aliran kerja sebenar berbanding sekadar menjana satu ringkasan.
Penerangan video yang boleh dikawal: bahan yang sama, hasil berbeza untuk keperluan perniagaan berbeza
Penerangan video tidak sepatutnya hanya mempunyai satu jawapan tetap. Penciptaan kandungan mementingkan naratif, carian bahan mementingkan segmen masa, manakala pengurusan aset mementingkan individu, syot, bunyi dan medan berstruktur.
Kedudukan Qwen3.8-Omni-Flash ialah membolehkan pihak pemanggil mengawal objek penerangan, julat masa, tahap butiran maklumat dan format output. Sebagai contoh, bahan yang sama boleh menghasilkan output berikut secara berasingan:
- Sinopsis plot tiga bahagian untuk editor;
- Cap masa, individu dan aksi utama untuk carian;
- Metadata JSON untuk perpustakaan aset;
- Senarai penutur, bahasa dan peristiwa audio untuk pasukan sari kata.
Keupayaan sebegini lebih sesuai direka bersama output berstruktur, alat fail dan sistem carian, bukan sekadar melihat satu penerangan bahasa semula jadi dalam tetingkap sembang.
Produksi dan penyuntingan audio-video: model, alat dan persekitaran runtime perlu dinaik taraf bersama
Agent audio-video panjang bukan sahaja berdepan isu keupayaan model, tetapi juga storan fail, penghantaran rangkaian, penaakulan berbilang pusingan, penyuntingan garis masa dan penyerahan hasil. Untuk tujuan ini, bahan pelancaran memperkenalkan dua projek sumber terbuka sokongan:
- Qwen-MM-Plugins: persepsi atas permintaan, panggilan alat dan pelaksanaan aliran kerja untuk audio-video panjang;
- Qwen-Live Harness: persekitaran interaksi omnimodal masa nyata dan berterusan.
Kedua-duanya boleh difahami sebagai mempunyai fokus runtime yang berbeza: satu lebih cenderung kepada tugasan jangka panjang dan pemprosesan bahan, manakala satu lagi lebih cenderung kepada interaksi masa nyata. Semasa deployment, semak kebergantungan, VRAM, kebenaran fail, rangkaian luaran dan versi plugin secara berasingan; jangan menulis "repositori sudah sumber terbuka" sebagai "boleh terus digunakan untuk produksi setempat dengan satu klik".
Bagaimana mengintegrasikan API Qwen3.8-Omni-Flash?
Jika penyedia perkhidmatan sudah membuka laluan yang berkaitan, disarankan bermula dengan Smoke Test menggunakan bahan kecil tanpa maklumat sensitif: satu imej, satu audio beberapa puluh saat dan satu video pendek, kemudian uji input, output, penggunaan Token dan mesej ralat secara berasingan.
Bentuk permintaan Chat Completions yang serasi secara tipikal adalah seperti berikut. Gantikan model dengan ID tepat yang telah disahkan dalam direktori model masa nyata penyedia perkhidmatan; jangan meneka nama model secara terus:
curl "$BASE_URL/chat/completions" \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-omni-flash",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "Ringkaskan tema bahan ini, penutur dan tiga cap masa utama."},
        {"type": "input_video", "video_url": {"url": "https://example.com/demo.mp4"}}
      ]
    }],
    "stream": false
  }'
input_video di atas hanya digunakan untuk menjelaskan bahawa format blok kandungan bagi permintaan multimodal perlu disahkan secara berasingan; ia tidak bermaksud semua antara muka serasi menerima medan ini. Sebelum integrasi sebenar, rujuk dokumentasi penyedia perkhidmatan dan rekod perkara berikut secara berasingan:
- Sama ada antara muka menyokong URL video, Base64 atau ID fail;
- Had saiz fail tunggal, tempoh, format dan tamat masa muat turun;
- Kaedah pengiraan dan harga Token audio/video;
- Sama ada panggilan alat, output berstruktur dan pulangan penstriman disokong;
- Sama ada percubaan semula selepas kegagalan akan menyebabkan caj berulang.
Jika anda membuat panggilan melalui gerbang laman ini, buka dahulu harga model masa nyata, sahkan ID model, kadar dan keupayaan semasa, kemudian gunakan baki kecil untuk mengesahkan bil sebenar. Artikel laman ini tidak akan menganggap harga pelancaran rasmi atau harga platform lain sebagai sebut harga laman ini secara langsung.
Sesuai untuk senario apa?
1. Penyuntingan video dan carian bahan
Biarkan model mengenal pasti syot, individu, aksi dan peristiwa audio terlebih dahulu, kemudian serahkan kepada alat penyuntingan untuk potongan kasar, sari kata dan penyusunan bab. Semasa penerimaan, bandingkan ketepatan cap masa dan kadar terlepas kesan, bukan sekadar melihat sama ada ringkasan dibaca dengan lancar.
2. Video muzik dan ulasan filem atau televisyen
Model boleh memahami visual, dialog, muzik dan struktur naratif secara serentak, kemudian menjana skrip, penerangan syot atau draf ulasan. Hasil akhir masih memerlukan semakan manusia untuk hak cipta, fakta dan kualiti bahasa.
3. Mesyuarat dan kerja pengetahuan
Video mesyuarat boleh masuk ke dalam pipeline transkripsi, pengecaman penutur, minit, analisis risiko dan penciptaan tugasan. Apabila melibatkan pelanggan, pekerja atau rahsia perniagaan, sempadan storan data dan penghantaran luaran mesti disahkan terlebih dahulu.
4. Penyelidikan mendalam multimodal
Gunakan video sebagai pintu masuk penyelidikan, digabungkan dengan laman web, imej, dokumen dan video lain untuk menambah konteks. Ini sesuai untuk ulang kaji kursus, penyelidikan produk dan analisis tutorial teknikal.
Senarai semak pemilihan dan integrasi
- Sahkan dahulu sama ada penyedia perkhidmatan benar-benar membuka
Qwen3.8-Omni-Flash, bukan hanya melihat tajuk berita. - Gunakan fail kecil tanpa maklumat sensitif untuk menguji teks, imej, audio dan video secara berasingan.
- Rekod saiz fail, tempoh, Tokens input/output, latensi, cache dan caj sebenar.
- Wujudkan sampel penerimaan berasingan untuk OCR, pengecaman penutur, cap masa, soal jawab video dan pelaksanaan alat.
- Letakkan pemahaman video, pembacaan fail, penciptaan tugasan, penghantaran e-mel dan pelaksanaan kod dalam sempadan kebenaran yang berbeza.
- Tetapkan bajet, tamat masa, percubaan semula dan syarat pengambilalihan manusia untuk tugasan panjang.
- Tulis versi model, tarikh permintaan, penyedia perkhidmatan, protokol dan struktur pulangan ke dalam log yang boleh dijejak.
Soalan lazim
Adakah Qwen3.8-Omni-Flash model visual biasa?
Tidak. Kedudukan pelancarannya ialah model omnimodal natif, dengan input merangkumi teks, imej, audio dan video, serta menggabungkan pemahaman audio-video dengan pelaksanaan alat Agent.
Seberapa panjang video yang disokong?
Bahan pelancaran menyebut input audio-video sehingga satu jam serta konteks panjang 1M. Had khusus masih mungkin dipengaruhi oleh API, saiz fail, pengekodan, rantau dan pelaksanaan penyedia perkhidmatan, jadi rujuk dokumentasi antara muka semasa dan permintaan sebenar.
Adakah konteks 1M bermaksud kos pasti lebih rendah?
Tidak. Konteks panjang memperluas skop yang boleh diproses, tetapi muat naik fail, Token audio-video, kitaran alat dan output semuanya menghasilkan kos. Pengumpulan bukti Agentic berpeluang mengurangkan pemprosesan yang tidak berkaitan, tetapi mesti disahkan melalui penggunaan sebenar.
Apakah perbezaan antara Qwen-Live Harness dan Qwen-MM-Plugins?
Yang pertama ditujukan kepada persekitaran runtime interaksi omnimodal masa nyata dan berterusan; yang kedua ditujukan kepada persepsi atas permintaan, panggilan alat dan pelaksanaan aliran kerja untuk audio-video panjang. Kedua-duanya ialah projek sokongan, bukan model API yang sama.
Adakah laman ini sudah menyokong Qwen3.8-Omni-Flash?
Artikel ini tidak menggantikan direktori masa nyata. Sila semak halaman harga model, sahkan ID model, kadar, keupayaan modaliti dan bil sebenar sebelum digunakan untuk produksi.
Kesimpulan
Fokus model omnimodal Qwen3.8-Omni-Flash ialah mengangkat audio-video daripada "input yang difahami oleh model" kepada medium kerja yang boleh digunakan oleh Agent untuk terus mengumpul bukti, merancang, memanggil alat dan menyerahkan hasil. Ia sesuai disahkan dengan tugasan sebenar berskala kecil: uji dahulu soal jawab video panjang, minit mesyuarat dan carian bahan, kemudian tambah penyuntingan, penyelidikan dan pelaksanaan tugasan secara berperingkat.
Sumber pelancaran: halaman luar talian akaun rasmi "Pelancaran Model Omnimodal Qwen3.8-Omni-Flash" yang disediakan oleh pengguna; imej ialah imej asal daripada halaman tersebut dan telah disalin ke direktori sumber statik laman ini, tanpa menganggap skrip halaman atau arahan pihak ketiga sebagai kandungan artikel.