Qwen3.8-Omni-Flash lançado: recursos, API e guia de agentes de áudio e vídeo
O modelo multimodal Qwen3.8-Omni-Flash foi lançado oficialmente. Ele reúne texto, imagens, áudio e vídeo no mesmo fluxo de trabalho de um agente. O objetivo não é apenas “entender” o conteúdo, mas avançar da análise do material para o planejamento, as chamadas de ferramentas e a entrega do resultado. Para desenvolvedores que trabalham com vídeos longos, gravações de reuniões, videoclipes e materiais audiovisuais, o destaque deste lançamento é o agente de áudio e vídeo, e não apenas mais um modelo multimodal de conversa.
Este artigo organiza o material publicado na conta oficial do Qwen no WeChat. As imagens mantêm as ilustrações de lançamento e demonstração do artigo original; os números de avaliação são resultados divulgados pelo fornecedor, não uma medição independente deste site. A disponibilidade do modelo no catálogo, o multiplicador e o valor efetivamente cobrado devem ser conferidos na página de preços em tempo real e no extrato real.
Quais entradas o Qwen3.8-Omni-Flash aceita?
| Item | Informações do lançamento |
|---|---|
| Nome do modelo | Qwen3.8-Omni-Flash |
| Modalidades de entrada | Texto, imagem, áudio e vídeo |
| Contexto | Até 1M de tokens |
| Principais direções | Agentes de áudio e vídeo, programação, trabalho com documentos e operação de GUI |
| Tarefas longas | Compreensão de áudio e vídeo longos, atas e tarefas de reuniões, relatórios de pesquisa em vídeo, criação de conteúdo |
| Ferramentas associadas | Qwen-MM-Plugins, Qwen-Live Harness |
O ID real do modelo na API, o protocolo, o limite de contexto e a disponibilidade regional dependem da documentação atual do provedor. Não presuma que todo gateway compatível com OpenAI já aceita áudio, vídeo e retorno de ferramentas só porque o lançamento usa a expressão “multimodalidade completa”. Valide texto, imagem, áudio, vídeo e chamadas de ferramentas separadamente.
Benchmarks oficiais: avanço nos agentes de áudio e vídeo e nas tarefas longas
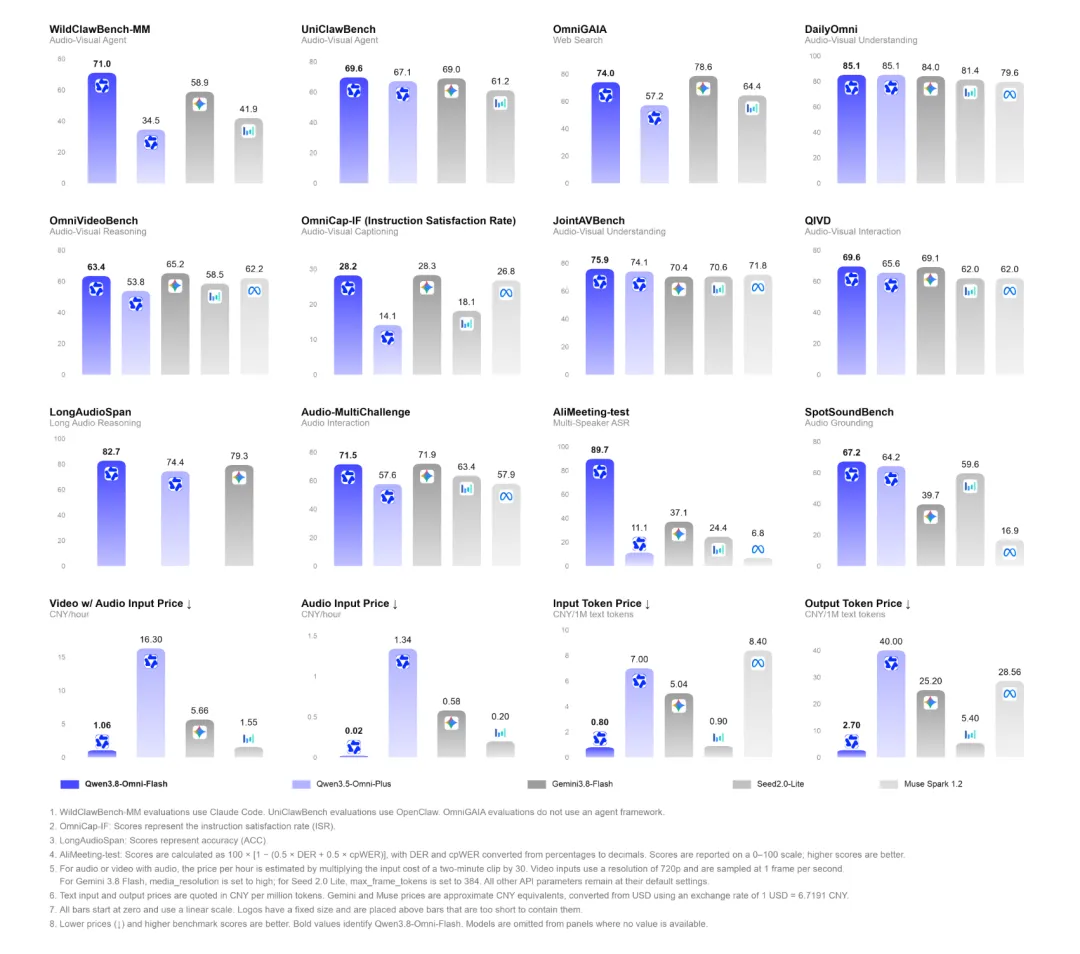
O material do lançamento afirma que o Qwen3.8-Omni-Flash teve uma melhoria média superior a 26% em 30 avaliações acumuladas, em comparação com o Qwen3.5-Omni-Plus. Alguns resultados mais fáceis de interpretar:
- o WildClawBench-MM subiu 36,5 pontos e cobre agentes de áudio e vídeo, programação e tarefas longas;
- o AgenticVBench subiu 22,3 pontos;
- o UniClawBench alcançou 69,6;
- o LongAudioSpan subiu 8,3 pontos e o OmniVideoBench, 9,6 pontos;
- o CSR / ISR do OmniCap-IF melhorou 8,5 / 14,1 pontos, respectivamente;
- no AliMeeting, o DER / cpWER caiu de 88,11 / 89,61 para 3,35 / 17,18.
Esses números devem ser analisados junto com o conjunto de testes, os prompts, o ambiente de ferramentas e as métricas usadas. DER e cpWER são indicadores de erro relacionados ao reconhecimento de reuniões; em geral, uma queda é positiva. Já uma melhora em um benchmark de agentes não pode ser convertida diretamente em taxa de sucesso para todas as tarefas de produção.
Contexto longo não significa apenas “colocar mais vídeo”
O Qwen3.8-Omni-Flash aceita sequências de até 1M, mas o valor do contexto longo não está apenas em enviar arquivos maiores. A mudança mais prática é que o modelo pode decidir, de acordo com a pergunta, o que precisa ver e ouvir e, depois, examinar os trechos relevantes em várias rodadas, do geral ao detalhado.
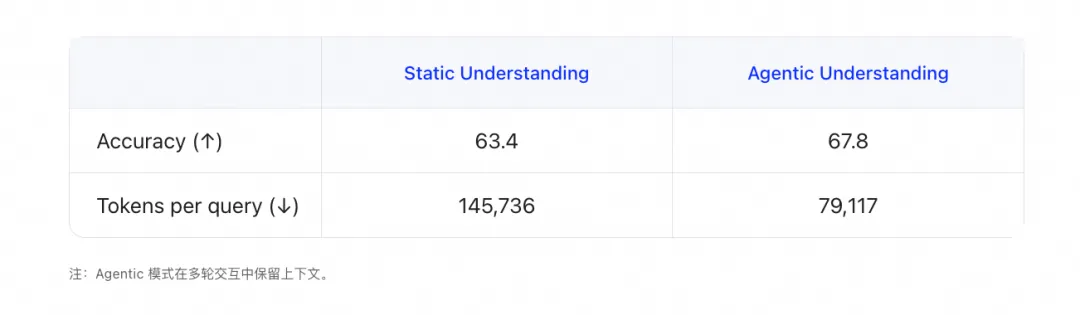
No experimento do OmniVideoBench citado no material oficial, o Agentic Understanding elevou a precisão de 63,4 para 67,8, enquanto o consumo de tokens caiu de 145.736 para 79.117, uma redução de aproximadamente 45,7%. Isso sugere que a busca ativa por evidências pode reduzir o processamento repetido de trechos irrelevantes, mas o custo real ainda depende da duração do arquivo, da codificação de áudio e vídeo, dos ciclos de ferramentas, do tamanho da saída e da cobrança do provedor.
Reuniões longas: do registro à execução
Uma reunião reúne imagem, voz, separação de falantes, referências e contexto do projeto. O lançamento afirma que o Qwen3.8-Omni-Flash aceita até uma hora de entrada de áudio e vídeo, entende em conjunto as pessoas na imagem e o conteúdo falado, separa os falantes, faz a transcrição e associa as identidades, gerando depois atas, tarefas pendentes e análises de risco.
Com ferramentas, o fluxo pode continuar: enviar e-mails, organizar tarefas ou começar a programar de acordo com as necessidades da reunião. Separe as recomendações do modelo da execução efetiva de ações externas: em produção, envio de e-mail, gravação de arquivos, criação de tarefas e execução de código devem ter permissões explícitas.
Pesquisa aprofundada com vídeo como ponto de partida
Quando o usuário faz uma pergunta específica sobre um vídeo, a resposta costuma precisar combinar o vídeo com páginas da web, imagens, documentos e outros vídeos. O Qwen3.8-Omni-Flash pode primeiro extrair as perguntas principais do vídeo e depois organizar materiais multimodais para montar um relatório de pesquisa com texto e imagens. Para tutoriais, cursos, demonstrações de produtos e materiais audiovisuais, isso se aproxima mais do fluxo de trabalho real do que um simples resumo.
Descrição de vídeo controlável: o mesmo material, saídas diferentes para cada negócio
Uma descrição de vídeo não deveria ter uma única forma fixa. A criação de conteúdo precisa de narrativa, a busca de materiais precisa de trechos com marcação de tempo e a gestão de ativos precisa de pessoas, planos, sons e campos estruturados.
O Qwen3.8-Omni-Flash foi posicionado para permitir que o chamador controle os objetos descritos, o intervalo de tempo, o nível de detalhe e o formato de saída. O mesmo material pode gerar, por exemplo:
- uma sinopse em três partes para um editor;
- marcas de tempo, pessoas e ações importantes para pesquisa;
- metadados JSON para uma biblioteca de ativos;
- uma lista de falantes, idiomas e eventos de áudio para uma equipe de legendagem.
Esse recurso é mais útil quando projetado junto com saída estruturada, ferramentas de arquivos e um sistema de busca, em vez de ser apenas consultado como uma descrição em linguagem natural numa janela de chat.
Produção e edição de áudio e vídeo: modelo, ferramentas e ambiente precisam evoluir juntos
Um agente para áudio e vídeo longos não depende apenas da capacidade do modelo. Também é preciso lidar com armazenamento de arquivos, transferência de rede, inferência em várias etapas, edição de linha do tempo e entrega do resultado. O lançamento apresenta dois projetos open source relacionados:
- Qwen-MM-Plugins: percepção sob demanda, chamadas de ferramentas e execução de fluxos para conteúdos longos de áudio e vídeo;
- Qwen-Live Harness: ambiente para interação multimodal completa, contínua e em tempo real.
Eles podem ser entendidos como focos de execução diferentes: um é mais voltado a tarefas longas e processamento de materiais; o outro, à interação em tempo real. No deploy, verifique separadamente dependências, memória de GPU, permissões de arquivos, rede externa e versões dos plugins. O fato de um repositório ser open source não significa que esteja pronto para produção com um clique.
Como integrar a API do Qwen3.8-Omni-Flash?
Se o provedor já abriu a rota correspondente, comece com arquivos pequenos e sem informações sensíveis: uma imagem, algumas dezenas de segundos de áudio e um vídeo curto. Teste separadamente entrada, saída, uso de tokens e mensagens de erro.
Uma solicitação típica compatível com OpenAI tem o formato abaixo. Substitua model pelo ID exato confirmado no catálogo atualizado do provedor; não adivinhe o nome do modelo:
curl "$BASE_URL/chat/completions" \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-omni-flash",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "Resuma o tema, os falantes e três momentos importantes deste material."},
        {"type": "input_video", "video_url": {"url": "https://example.com/demo.mp4"}}
      ]
    }],
    "stream": false
  }'
O campo input_video serve apenas para mostrar que uma solicitação multimodal exige a validação separada do formato de cada bloco de conteúdo; nem toda interface compatível aceita esse campo. Antes da integração real, consulte a documentação do provedor e registre separadamente:
- se a interface aceita URL de vídeo, Base64 ou ID de arquivo;
- os limites de tamanho, duração, formato e tempo de download;
- como os tokens de áudio e vídeo são calculados e cobrados;
- se há suporte a chamadas de ferramentas, saída estruturada e streaming;
- se uma nova tentativa depois de uma falha pode gerar cobrança duplicada.
Se você chamar o gateway deste site, abra primeiro a página de preços em tempo real, confirme o ID do modelo, o multiplicador e as capacidades e valide a cobrança real com um saldo pequeno. Este artigo não transforma o preço oficial do lançamento nem o preço de outra plataforma no preço deste site.
Para quais cenários ele é indicado?
1. Edição de vídeo e busca de materiais
Peça ao modelo para localizar primeiro planos, pessoas, ações e eventos de áudio e depois entregue o resultado a uma ferramenta de edição para montagem inicial, legendas e capítulos. Na aceitação, compare a precisão das marcas de tempo e a taxa de omissões, não apenas a fluidez do resumo.
2. Videoclipes e narração audiovisual
O modelo pode entender simultaneamente imagens, diálogos, música e estrutura narrativa e gerar roteiros, descrições de planos ou um rascunho de narração. O material final ainda precisa de revisão humana de direitos autorais, fatos e qualidade linguística.
3. Reuniões e trabalho do conhecimento
Vídeos de reuniões podem alimentar uma cadeia de transcrição, identificação de falantes, atas, análise de riscos e criação de tarefas. Quando houver dados de clientes, funcionários ou segredos comerciais, confirme primeiro os limites de armazenamento e transferência externa.
4. Pesquisa multimodal aprofundada
Use o vídeo como porta de entrada e complemente-o com páginas da web, imagens, documentos e outros vídeos. Isso é adequado para revisar cursos, pesquisar produtos e analisar tutoriais técnicos.
Checklist de escolha e integração
- Confirme primeiro se o provedor realmente oferece
Qwen3.8-Omni-Flash; não confie apenas no título de uma notícia. - Teste texto, imagem, áudio e vídeo separadamente com arquivos pequenos e sem dados sensíveis.
- Registre tamanho e duração dos arquivos, tokens de entrada e saída, latência, cache e o valor efetivamente cobrado.
- Crie amostras de aceitação separadas para OCR, identificação de falantes, marcas de tempo, perguntas sobre vídeo e execução de ferramentas.
- Mantenha limites de permissão separados para compreensão de vídeo, leitura de arquivos, criação de tarefas, envio de e-mail e execução de código.
- Para tarefas longas, defina orçamento, timeout, política de novas tentativas e condições de intervenção humana.
- Grave em logs rastreáveis a versão do modelo, a data da solicitação, o provedor, o protocolo e a estrutura da resposta.
Perguntas frequentes
O Qwen3.8-Omni-Flash é um modelo de visão comum?
Não. Ele é apresentado como um modelo multimodal nativo, com entradas de texto, imagem, áudio e vídeo, que conecta a compreensão de áudio e vídeo à execução de ferramentas por um agente.
Qual é a duração máxima do vídeo?
O lançamento menciona até uma hora de entrada de áudio e vídeo e contexto de 1M. O limite concreto ainda pode depender da API, do tamanho do arquivo, da codificação, da região e da implementação do provedor; confira a documentação atual e uma solicitação real.
Contexto de 1M significa que o custo será sempre menor?
Não. O contexto longo amplia o alcance do processamento, mas upload, tokens de áudio e vídeo, ciclos de ferramentas e saída continuam gerando custos. A coleta ativa pode reduzir o processamento irrelevante, mas isso precisa ser validado com o uso real.
Qual é a diferença entre Qwen-Live Harness e Qwen-MM-Plugins?
O primeiro se concentra em um ambiente de interação multimodal completa, contínua e em tempo real; o segundo, em percepção sob demanda, chamadas de ferramentas e execução de fluxos para conteúdos longos de áudio e vídeo. São projetos relacionados, não dois nomes para a mesma API de modelo.
Este site já oferece o Qwen3.8-Omni-Flash?
Este artigo não substitui o catálogo em tempo real. Consulte a página de modelos e preços para confirmar ID, multiplicador, modalidades e cobrança real antes de usar o modelo em produção.
Conclusão
O ponto central do modelo multimodal Qwen3.8-Omni-Flash é transformar áudio e vídeo de simples entradas compreendidas pelo modelo em materiais de trabalho que um agente pode investigar, planejar, processar com ferramentas e converter em entregas. Comece validando tarefas reais em pequena escala — perguntas sobre vídeos longos, atas de reuniões e busca de materiais — e depois adicione edição, pesquisa e execução de tarefas gradualmente.
Fonte: página offline do WeChat fornecida pelo usuário, intitulada “全模态模型 Qwen3.8-Omni-Flash 发布”. As imagens são da publicação original e foram copiadas para os recursos estáticos do site; os scripts da página e as instruções de terceiros não foram tratados como conteúdo editorial.