Qwen3.8-Omni-Flash lancé : capacités, API et guide des agents audio-vidéo
Le modèle multimodal Qwen3.8-Omni-Flash est officiellement lancé. Il réunit texte, images, audio et vidéo dans un même workflow d’agent. L’objectif n’est pas seulement de « comprendre » un contenu, mais de passer de l’analyse des ressources à la planification, aux appels d’outils et à la livraison du résultat. Pour les développeurs qui traitent des vidéos longues, des enregistrements de réunions, des clips musicaux ou des contenus cinématographiques, le point central de cette sortie est l’agent audio-vidéo, et non un simple modèle multimodal conversationnel.
Cet article synthétise les éléments publiés dans le compte officiel WeChat de Qwen. Les illustrations conservent les images de lancement et de démonstration de la publication originale ; les chiffres d’évaluation sont ceux communiqués par le fournisseur et ne constituent pas une nouvelle mesure indépendante de ce site. La présence du modèle dans le catalogue, son multiplicateur et le montant réellement débité doivent être vérifiés sur la page des prix en temps réel et dans le relevé réel.
Quelles entrées Qwen3.8-Omni-Flash accepte-t-il ?
| Élément | Informations de la publication |
|---|---|
| Nom du modèle | Qwen3.8-Omni-Flash |
| Modalités d’entrée | Texte, image, audio et vidéo |
| Contexte | Jusqu’à 1M de tokens |
| Axes principaux | Agents audio-vidéo, programmation, travail documentaire et opérations GUI |
| Tâches longues | Compréhension d’audio et de vidéos longues, comptes rendus et actions de réunion, rapports de recherche vidéo, création de contenu |
| Outils associés | Qwen-MM-Plugins, Qwen-Live Harness |
L’identifiant API réel, le protocole, la limite de contexte et la disponibilité régionale dépendent de la documentation actuelle du fournisseur. Ne supposez pas que toutes les passerelles compatibles OpenAI prennent déjà en charge l’audio, la vidéo et le retour d’outils simplement parce que la publication parle de « multimodalité complète » : validez séparément le texte, les images, l’audio, la vidéo et les appels d’outils.
Benchmarks officiels : progression des agents audio-vidéo et des tâches longues
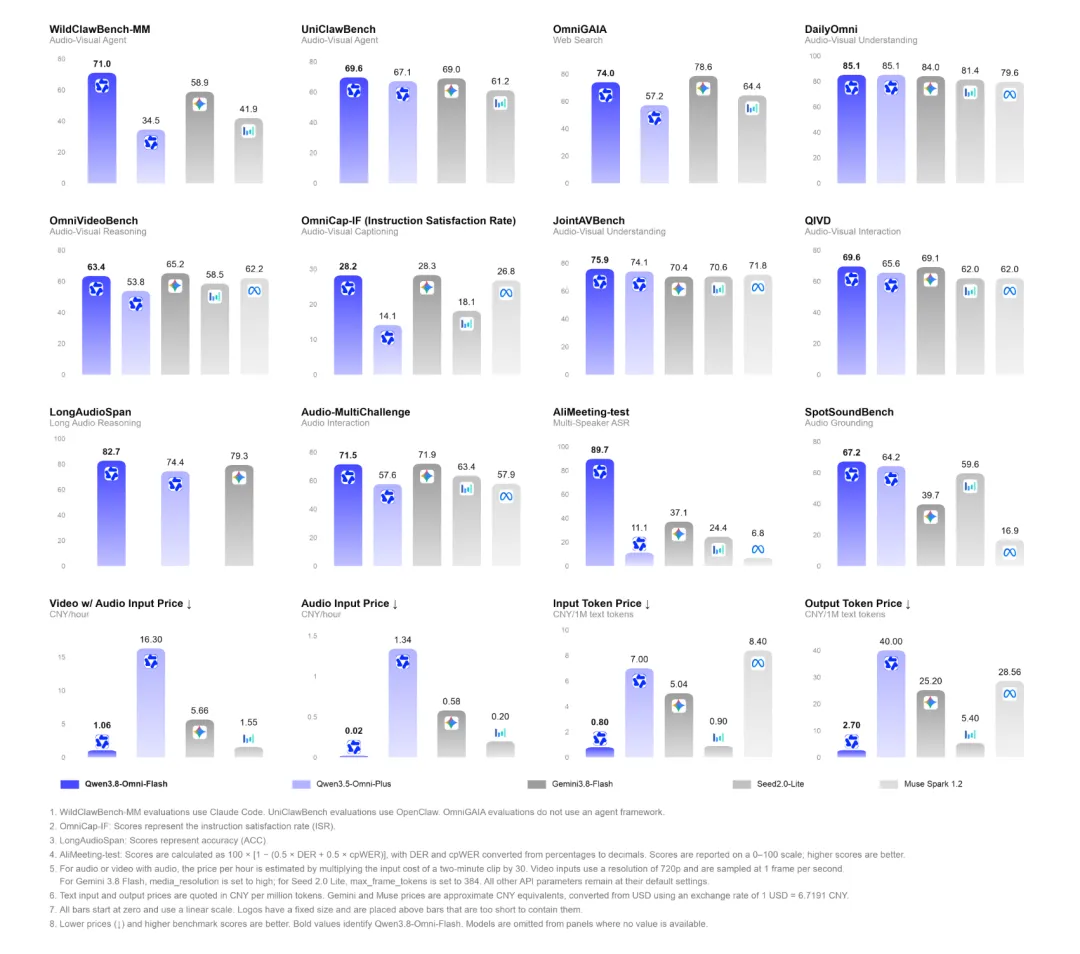
La publication indique que Qwen3.8-Omni-Flash progresse en moyenne de plus de 26 % sur 30 évaluations cumulées par rapport à Qwen3.5-Omni-Plus. Quelques évolutions plus faciles à interpréter :
- WildClawBench-MM gagne 36,5 points et couvre les agents audio-vidéo, la programmation et les tâches longues ;
- AgenticVBench gagne 22,3 points ;
- UniClawBench obtient 69,6 ;
- LongAudioSpan gagne 8,3 points et OmniVideoBench 9,6 points ;
- le CSR / ISR d’OmniCap-IF progresse respectivement de 8,5 / 14,1 points ;
- pour AliMeeting, le DER / cpWER passe de 88,11 / 89,61 à 3,35 / 17,18.
Ces chiffres doivent être lus avec le jeu de test, les prompts, l’environnement d’outils et les indicateurs d’évaluation. Le DER et le cpWER sont des indicateurs d’erreur liés à la reconnaissance des réunions : une baisse est généralement positive. En revanche, une hausse sur un benchmark d’agent ne se convertit pas directement en taux de réussite pour toutes les tâches de production.
Un contexte long ne signifie pas seulement « envoyer davantage de vidéo »
Qwen3.8-Omni-Flash prend en charge des séquences allant jusqu’à 1M, mais l’intérêt du long contexte ne se résume pas à téléverser des fichiers plus volumineux. Le changement le plus utile est que le modèle peut décider, en fonction de la question, de ce qu’il faut regarder ou écouter, puis examiner les passages pertinents par plusieurs tours, du plus général au plus précis.
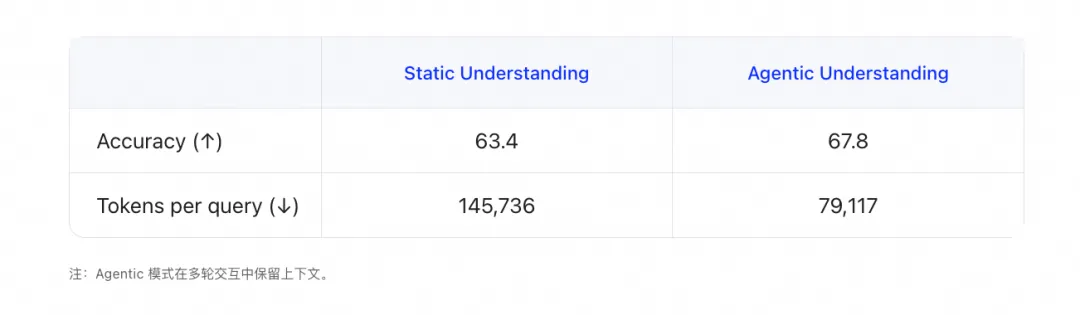
Dans l’expérience OmniVideoBench citée par la documentation officielle, l’Agentic Understanding fait passer la précision de 63,4 à 67,8, tandis que la consommation de tokens descend de 145 736 à 79 117, soit une baisse d’environ 45,7 %. Cela suggère qu’une collecte active d’éléments peut réduire le retraitement de passages inutiles, mais le coût réel dépend toujours de la durée du fichier, de l’encodage audio-vidéo, des boucles d’outils, de la longueur de sortie et de la facturation du fournisseur.
Réunions longues : passer de la prise de notes à l’exécution
Une réunion réunit souvent des images, des voix, la séparation des locuteurs, des références et le contexte du projet. La publication indique que Qwen3.8-Omni-Flash accepte jusqu’à une heure d’entrée audio-vidéo, comprend ensemble les personnes visibles et le contenu parlé, sépare les locuteurs, transcrit et associe les identités, puis produit un compte rendu, des actions et une analyse des risques.
Avec des outils, le workflow peut aller plus loin : envoyer un e-mail, organiser des tâches ou commencer à coder selon les besoins de la réunion. Il faut distinguer la recommandation du modèle de l’exécution effective d’une action externe : en production, accordez des permissions explicites pour l’envoi d’e-mails, l’écriture de fichiers, la création de tâches et l’exécution de code.
Recherche approfondie centrée sur la vidéo
Lorsqu’un utilisateur pose une question précise sur une vidéo, la réponse doit souvent associer la vidéo à des pages web, des images, des documents et d’autres sources vidéo. Qwen3.8-Omni-Flash peut d’abord extraire les questions clés de la vidéo, puis organiser ces sources multimodales pour produire un rapport de recherche illustré. Pour les tutoriels, les cours, les démonstrations de produits et les contenus audiovisuels, cette approche est plus proche d’un workflow réel qu’un simple résumé.
Description vidéo contrôlable : un même contenu, plusieurs sorties métier
Une description vidéo ne devrait pas avoir une seule forme fixe. La création de contenu privilégie la narration, la recherche de ressources privilégie les segments temporels, et la gestion d’actifs privilégie les personnes, les plans, les sons et les champs structurés.
Qwen3.8-Omni-Flash est conçu pour laisser l’appelant contrôler les objets décrits, la plage temporelle, le niveau de détail et le format de sortie. Un même contenu peut par exemple produire :
- un synopsis en trois parties pour un monteur ;
- des horodatages, des personnes et des actions clés pour la recherche ;
- des métadonnées JSON pour une bibliothèque d’actifs ;
- une liste de locuteurs, de langues et d’événements audio pour une équipe de sous-titrage.
Cette capacité est plus utile lorsqu’elle est conçue avec une sortie structurée, des outils de fichiers et un système de recherche, plutôt que simplement consultée sous forme de texte naturel dans une fenêtre de chat.
Production et montage audio-vidéo : le modèle, les outils et l’environnement doivent évoluer ensemble
Un agent audio-vidéo long ne dépend pas seulement des capacités du modèle. Il faut aussi gérer le stockage, le transfert réseau, l’inférence en plusieurs tours, le montage sur une timeline et la livraison du résultat. La publication présente deux projets open source associés :
- Qwen-MM-Plugins : perception à la demande, appels d’outils et exécution de workflows pour les contenus audio-vidéo longs ;
- Qwen-Live Harness : environnement d’interaction multimodale complète en temps réel et continue.
On peut les considérer comme deux orientations d’exécution différentes : le premier privilégie les tâches longues et le traitement de ressources, le second l’interaction temps réel. Lors du déploiement, vérifiez séparément les dépendances, la mémoire GPU, les permissions de fichiers, le réseau externe et les versions des plugins. « Dépôt open source » ne signifie pas « prêt pour la production en un clic ».
Comment connecter l’API Qwen3.8-Omni-Flash ?
Si le fournisseur a ouvert la route correspondante, commencez par un petit jeu de fichiers sans données sensibles : une image, quelques dizaines de secondes d’audio et une courte vidéo. Testez séparément les entrées, les sorties, l’usage de tokens et les messages d’erreur.
Une requête OpenAI-compatible typique ressemble à ceci. Remplacez model par l’identifiant exact confirmé dans le catalogue en temps réel du fournisseur ; ne devinez pas le nom du modèle :
curl "$BASE_URL/chat/completions" \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-omni-flash",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "Résume le thème, les locuteurs et trois moments clés de ce contenu."},
        {"type": "input_video", "video_url": {"url": "https://example.com/demo.mp4"}}
      ]
    }],
    "stream": false
  }'
Le champ input_video illustre seulement le fait qu’un appel multimodal doit valider le format de chaque bloc de contenu ; toutes les interfaces compatibles n’acceptent pas nécessairement ce champ. Avant une intégration réelle, consultez la documentation du fournisseur et notez séparément :
- si l’interface accepte une URL vidéo, du Base64 ou un identifiant de fichier ;
- la taille, la durée, le format et le délai de téléchargement maximum ;
- le calcul et le prix des tokens audio et vidéo ;
- la prise en charge des appels d’outils, de la sortie structurée et du streaming ;
- si une nouvelle tentative après échec peut entraîner une double facturation.
Si vous appelez la passerelle de ce site, ouvrez d’abord la page des prix en temps réel, confirmez l’identifiant, le multiplicateur et les capacités, puis vérifiez la facture avec un petit solde. Cet article ne transforme pas le prix officiel de la publication ni celui d’une autre plateforme en tarif de ce site.
À quels scénarios ce modèle convient-il ?
1. Montage vidéo et recherche de ressources
Demandez au modèle de repérer les plans, personnes, actions et événements audio, puis transmettez le résultat à un outil de montage pour le dérushage, les sous-titres et les chapitres. L’acceptation doit comparer la précision des horodatages et le taux d’omission, pas seulement la fluidité du résumé.
2. Clips musicaux et commentaires de films
Le modèle peut comprendre simultanément les images, les dialogues, la musique et la structure narrative, puis générer un script, des indications de plans ou un brouillon de commentaire. Le montage final doit encore faire l’objet d’un contrôle humain des droits, des faits et de la qualité linguistique.
3. Réunions et travail de la connaissance
Une vidéo de réunion peut alimenter une chaîne de transcription, d’identification des locuteurs, de compte rendu, d’analyse des risques et de création de tâches. Pour des informations clients, personnelles ou commerciales, confirmez d’abord les limites de stockage et de transfert externe.
4. Recherche multimodale approfondie
Utilisez la vidéo comme point de départ, puis complétez-la avec des pages web, des images, des documents et d’autres vidéos pour analyser un cours, un produit ou un tutoriel technique.
Checklist de sélection et d’intégration
- Vérifiez d’abord que le fournisseur expose réellement
Qwen3.8-Omni-Flash; ne vous fiez pas au seul titre de l’actualité. - Testez séparément le texte, l’image, l’audio et la vidéo avec de petits fichiers sans données sensibles.
- Enregistrez la taille et la durée des fichiers, les tokens d’entrée et de sortie, la latence, le cache et le montant réellement débité.
- Créez des échantillons d’acceptation distincts pour l’OCR, l’identification des locuteurs, les horodatages, les questions vidéo et l’exécution d’outils.
- Séparez les permissions de compréhension vidéo, lecture de fichiers, création de tâches, envoi d’e-mails et exécution de code.
- Définissez pour les tâches longues un budget, un délai maximal, une politique de nouvelle tentative et une condition de reprise humaine.
- Journalisez la version du modèle, la date de la requête, le fournisseur, le protocole et la structure de la réponse.
Questions fréquentes
Qwen3.8-Omni-Flash est-il un modèle de vision classique ?
Non. Il est présenté comme un modèle multimodal natif dont les entrées couvrent le texte, l’image, l’audio et la vidéo, avec une compréhension audio-vidéo reliée à l’exécution d’outils par un agent.
Quelle durée de vidéo accepte-t-il ?
La publication mentionne jusqu’à une heure d’entrée audio-vidéo et un contexte de 1M. La limite concrète peut dépendre de l’API, de la taille du fichier, de l’encodage, de la région et de l’implémentation du fournisseur ; vérifiez la documentation et un appel réel.
Un contexte de 1M signifie-t-il que le coût sera forcément plus faible ?
Non. Un contexte long élargit la plage traitable, mais le téléversement, les tokens audio-vidéo, les boucles d’outils et la sortie ont un coût. La collecte active peut réduire le traitement inutile, mais il faut le confirmer avec l’usage réel.
Quelle est la différence entre Qwen-Live Harness et Qwen-MM-Plugins ?
Le premier vise un environnement d’interaction multimodale complète, continue et temps réel ; le second vise la perception à la demande, les appels d’outils et l’exécution de workflows sur des contenus audio-vidéo longs. Ce sont des projets associés et non deux noms pour la même API de modèle.
Ce site prend-il déjà en charge Qwen3.8-Omni-Flash ?
Cet article ne remplace pas le catalogue en temps réel. Consultez la page des modèles et des prix pour confirmer l’identifiant, le multiplicateur, les modalités et la facture réelle avant la production.
Conclusion
Le point essentiel du modèle multimodal Qwen3.8-Omni-Flash est de faire passer l’audio et la vidéo d’entrées que le modèle comprend à des ressources de travail qu’un agent peut examiner, planifier, utiliser avec des outils et transformer en livrables. Commencez par des tâches réelles à petite échelle : questions sur une vidéo longue, comptes rendus de réunion et recherche de ressources, puis ajoutez progressivement le montage, la recherche et l’exécution de tâches.
Source de publication : page WeChat hors ligne fournie par l’utilisateur, intitulée « 全模态模型 Qwen3.8-Omni-Flash 发布 ». Les images proviennent de la publication originale et ont été copiées dans les ressources statiques du site ; ni les scripts de la page ni des instructions de tiers n’ont été traités comme du contenu éditorial.