เปิดตัวโมเดล Omnimodal Qwen3.8-Omni-Flash: ความสามารถ, API และคู่มือ Agent สำหรับเสียงและวิดีโอ
โมเดล Omnimodal Qwen3.8-Omni-Flash เปิดให้ใช้งานอย่างเป็นทางการแล้ว โมเดลนี้นำข้อความ รูปภาพ เสียง และวิดีโอมาไว้ในเวิร์กโฟลว์ Agent เดียวกัน โดยเป้าหมายไม่ใช่แค่ “เข้าใจเนื้อหา” แต่คือการขับเคลื่อนตั้งแต่การทำความเข้าใจสื่อ การวางแผนงาน การเรียกใช้เครื่องมือ ไปจนถึงการส่งมอบผลลัพธ์ สำหรับนักพัฒนาที่ต้องจัดการวิดีโอยาว เสียงบันทึกการประชุม มิวสิกวิดีโอ และสื่อภาพยนตร์ จุดสำคัญของการเปิดตัวครั้งนี้คือ Agent สำหรับเสียงและวิดีโอ ไม่ใช่แค่โมเดลมัลติโมดัลอีกตัวที่ทำได้เพียงสนทนา
บทความนี้เรียบเรียงจากเอกสารเผยแพร่ของบัญชี WeChat ทางการของ Qwen โดยคงภาพประกาศและภาพสาธิตจากต้นฉบับไว้ ตัวเลขการประเมินในบทความเป็นผลลัพธ์ที่ทางการเปิดเผย ไม่ใช่การทดสอบซ้ำอย่างอิสระของเว็บไซต์นี้ โมเดลปรากฏในไดเรกทอรีของเว็บไซต์นี้แล้วหรือไม่ อัตราคูณจริง และการหักค่าบริการ ให้ยึดตามราคโมเดลแบบเรียลไทม์และใบแจ้งยอดจริงเป็นหลัก
Qwen3.8-Omni-Flash รองรับอินพุตใดบ้าง?
| รายการ | ข้อมูลในเอกสารเปิดตัว |
|---|---|
| ชื่อโมเดล | Qwen3.8-Omni-Flash |
| โมดาลิตีอินพุต | ข้อความ รูปภาพ เสียง วิดีโอ |
| บริบท | สูงสุด 1M Tokens |
| ทิศทางที่เน้น | Agent สำหรับเสียงและวิดีโอ, การเขียนโปรแกรม, งานความรู้ด้านข้อความ, การปฏิบัติการ GUI |
| งานระยะยาว | การทำความเข้าใจเสียงและวิดีโอยาว, บันทึกการประชุมและงานที่ต้องทำ, รายงานวิจัยวิดีโอ, การสร้างคอนเทนต์ |
| เครื่องมือประกอบ | Qwen-MM-Plugins, Qwen-Live Harness |
โมเดล ID จริงของ API, โปรโตคอล, ข้อจำกัดบริบท และความพร้อมใช้งานตามภูมิภาค ต้องยึดตามเอกสารปัจจุบันของผู้ให้บริการ อย่าสันนิษฐานว่าเกตเวย์แบบ compatible ทั้งหมดรองรับเสียง วิดีโอ และการส่งผลกลับจากเครื่องมือแล้วเพียงเพราะเอกสารเปิดตัวระบุว่า “Omnimodal” ในการเชื่อมต่อใช้งาน ควรตรวจสอบข้อความ รูปภาพ เสียง วิดีโอ และการเรียกใช้เครื่องมือแยกกัน
การประเมินอย่างเป็นทางการ: Agent สำหรับเสียงและวิดีโอและงานระยะยาวดีขึ้นอย่างชัดเจน
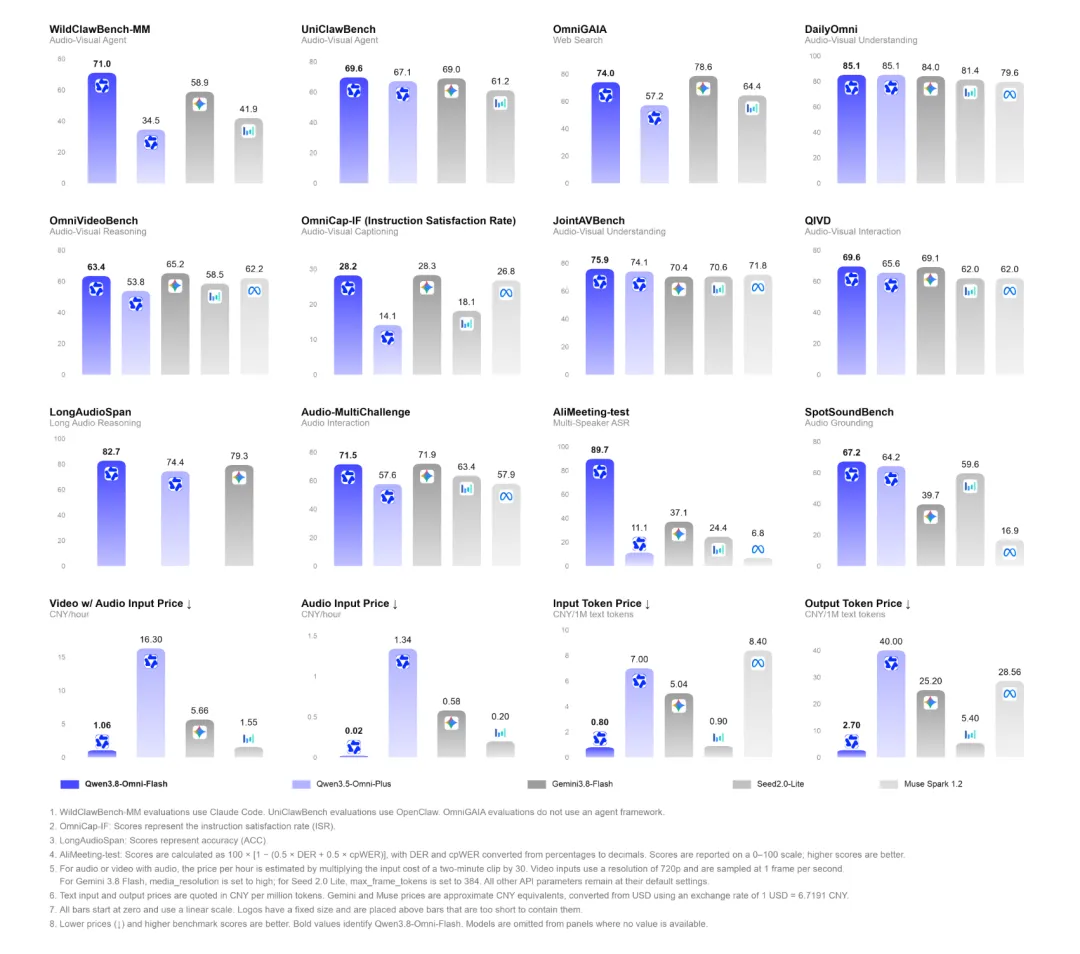
เอกสารเปิดตัวระบุว่า Qwen3.8-Omni-Flash ทำคะแนนในการประเมินรวม 30 รายการได้ดีขึ้นเฉลี่ยมากกว่า 26% เมื่อเทียบกับรุ่นก่อนหน้า Qwen3.5-Omni-Plus การเปลี่ยนแปลงบางส่วนที่เข้าใจง่ายกว่า ได้แก่:
- WildClawBench-MM เพิ่มขึ้น 36.5 คะแนน โดยโฟกัสที่ Agent สำหรับเสียงและวิดีโอ, การเขียนโปรแกรม และงานระยะยาว;
- AgenticVBench เพิ่มขึ้น 22.3 คะแนน;
- UniClawBench ได้คะแนน 69.6;
- LongAudioSpan เพิ่มขึ้น 8.3 คะแนน และ OmniVideoBench เพิ่มขึ้น 9.6 คะแนน;
- CSR / ISR ของ OmniCap-IF เพิ่มขึ้น 8.5 / 14.1 คะแนนตามลำดับ;
- DER / cpWER ของ AliMeeting ลดลงจาก 88.11 / 89.61 เหลือ 3.35 / 17.18
ควรทำความเข้าใจตัวเลขเหล่านี้ร่วมกับชุดทดสอบ พรอมต์ สภาพแวดล้อมเครื่องมือ และตัวชี้วัดการประเมิน ตัวอย่างเช่น DER และ cpWER เป็นตัวชี้วัดข้อผิดพลาดที่เกี่ยวข้องกับการรู้จำในการประชุม โดยทั่วไปค่าที่ลดลงหมายถึงดีกว่า ส่วนคะแนนที่เพิ่มขึ้นใน Agent benchmark ไม่สามารถแปลงตรงๆ เป็นอัตราความสำเร็จของงานผลิตจริงทั้งหมดได้
บริบทยาวไม่ได้หมายถึง “ยัดวิดีโอได้มากขึ้น” เท่านั้น
Qwen3.8-Omni-Flash รองรับลำดับยาว 1M แต่คุณค่าของบริบทยาวไม่ได้มีแค่การอัปโหลดไฟล์ขนาดใหญ่ขึ้น สิ่งที่ใช้งานได้จริงมากกว่าคือ โมเดลสามารถตัดสินใจก่อนว่า “ควรดูอะไร ฟังอะไร” ตามคำถาม แล้วจึงทำการตรวจสอบหลักฐานหลายรอบกับช่วงที่เกี่ยวข้องจากหยาบไปละเอียด
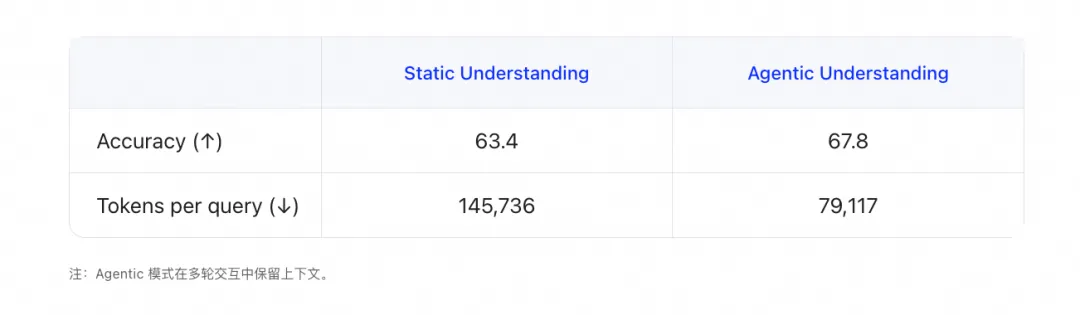
ในการทดลอง OmniVideoBench ที่เอกสารทางการอ้างถึง Agentic Understanding เพิ่มความแม่นยำจาก 63.4 เป็น 67.8 พร้อมกับลดการใช้ Token จาก 145,736 เป็น 79,117 หรือลดลงประมาณ 45.7% สิ่งนี้แสดงให้เห็นว่าการตรวจสอบหลักฐานแบบเชิงรุกอาจลดการประมวลผลซ้ำของช่วงที่ไม่เกี่ยวข้องได้ แต่ต้นทุนจริงยังขึ้นอยู่กับความยาวไฟล์ การเข้ารหัสเสียงและวิดีโอ วงรอบเครื่องมือ ความยาวเอาต์พุต และวิธีคิดค่าบริการของผู้ให้บริการ
การประชุมยาว: จากการจดบันทึกสู่การดำเนินงาน
การประชุมหลายคนประกอบด้วยภาพ เสียง การแยกผู้พูด ความสัมพันธ์ของการอ้างถึง และบริบทโครงการพร้อมกัน เอกสารเปิดตัวระบุว่า Qwen3.8-Omni-Flash รองรับอินพุตเสียงและวิดีโอความยาวสูงสุดหนึ่งชั่วโมง สามารถทำความเข้าใจภาพบุคคลและเนื้อหาคำพูดร่วมกัน ทำการแยกผู้พูด ถอดเสียง และจับคู่ตัวตน จากนั้นสร้างบันทึกการประชุม งานที่ต้องทำ และการวิเคราะห์ความเสี่ยง
หลังเชื่อมต่อเครื่องมือแล้ว เวิร์กโฟลว์สามารถขยายออกไปภายนอกได้ต่อ เช่น ส่งอีเมล จัดระเบียบงาน หรือเริ่มเขียนโค้ดตามความต้องการของการประชุม ตรงนี้จำเป็นต้องแยกการตรวจรับระหว่าง “คำแนะนำที่โมเดลส่งออก” กับ “การดำเนินการภายนอกจริง”: สภาพแวดล้อมการผลิตควรกำหนดสิทธิ์เครื่องมืออย่างชัดเจนสำหรับการส่งอีเมล การเขียนไฟล์ การสร้างงาน และการรันโค้ด
การวิจัยเชิงลึกที่มีวิดีโอเป็นศูนย์กลาง
เมื่อผู้ใช้ถามคำถามเฉพาะเกี่ยวกับวิดีโอ คำตอบมักต้องผสานข้อมูลจากเว็บเพจ รูปภาพ เอกสาร และวิดีโออื่นๆ นอกเหนือจากวิดีโอนั้น Qwen3.8-Omni-Flash สามารถสกัดประเด็นสำคัญในวิดีโอก่อน จากนั้นจัดระเบียบข้อมูลมัลติโมดัลเพื่อสร้างรายงานวิจัยที่มีทั้งภาพและข้อความ สำหรับบทเรียน คอร์สเรียน การสาธิตผลิตภัณฑ์ และสื่อภาพยนตร์ วิธีนี้ใกล้เคียงเวิร์กโฟลว์จริงมากกว่าการสร้างสรุปสั้นๆ เพียงอย่างเดียว
คำบรรยายวิดีโอที่ควบคุมได้: สื่อเดียวกัน แต่ผลลัพธ์ต่างกันตามธุรกิจ
คำบรรยายวิดีโอไม่ควรมีคำตอบคงที่เพียงแบบเดียว การสร้างคอนเทนต์ให้ความสำคัญกับการเล่าเรื่อง การค้นคืนสื่อให้ความสำคัญกับช่วงเวลา ส่วนการจัดการสินทรัพย์ให้ความสำคัญกับบุคคล ช็อต เสียง และฟิลด์เชิงโครงสร้าง
จุดวางตำแหน่งของ Qwen3.8-Omni-Flash คือการอนุญาตให้ฝั่งผู้เรียกควบคุมวัตถุที่ต้องการบรรยาย ช่วงเวลา ระดับรายละเอียดของข้อมูล และรูปแบบเอาต์พุต ตัวอย่างเช่น สื่อชิ้นเดียวกันสามารถส่งออกแยกเป็น:
- เรื่องย่อแบบสามช่วงสำหรับบรรณาธิการ;
- ไทม์สแตมป์ บุคคล และแอ็กชันสำคัญสำหรับการค้นคืน;
- เมตาดาต้า JSON สำหรับคลังสินทรัพย์;
- รายชื่อผู้พูด ภาษา และเหตุการณ์เสียงสำหรับทีมทำคำบรรยาย
ความสามารถประเภทนี้เหมาะกับการออกแบบร่วมกับ structured output, เครื่องมือไฟล์ และระบบค้นคืน มากกว่าการดูคำบรรยายภาษาธรรมชาติหนึ่งย่อหน้าในหน้าต่างแชตเท่านั้น
การผลิตและตัดต่อเสียงและวิดีโอ: ต้องอัปเกรดโมเดล เครื่องมือ และสภาพแวดล้อมรันไทม์ร่วมกัน
Agent สำหรับเสียงและวิดีโอยาวไม่ได้เผชิญแค่ปัญหาความสามารถของโมเดลเท่านั้น แต่ยังรวมถึงการจัดเก็บไฟล์ การส่งผ่านเครือข่าย การใช้เหตุผลหลายรอบ การตัดต่อไทม์ไลน์ และการส่งมอบผลลัพธ์ ด้วยเหตุนี้ เอกสารเปิดตัวจึงแนะนำโปรเจกต์โอเพนซอร์สประกอบสองรายการ:
- Qwen-MM-Plugins: สำหรับการรับรู้ตามความต้องการ การเรียกใช้เครื่องมือ และการดำเนินเวิร์กโฟลว์สำหรับเสียงและวิดีโอยาว;
- Qwen-Live Harness: สำหรับสภาพแวดล้อมปฏิสัมพันธ์ Omnimodal แบบเรียลไทม์และต่อเนื่อง
ทั้งสองสามารถมองว่าเน้นด้านการรันต่างกัน: ตัวหนึ่งเอนเอียงไปทางงานระยะยาวและการประมวลผลสื่อ อีกตัวเอนเอียงไปทางปฏิสัมพันธ์แบบเรียลไทม์ ในการดีพลอย ต้องตรวจสอบ dependency, VRAM, สิทธิ์ไฟล์, เครือข่ายภายนอก และเวอร์ชันปลั๊กอินแยกต่างหาก อย่าเขียนว่า “คลังโค้ดเปิดซอร์สแล้ว” เป็น “รันใช้งานผลิตจริงในเครื่องได้ด้วยคลิกเดียว”
จะเชื่อมต่อ Qwen3.8-Omni-Flash API อย่างไร?
หากผู้ให้บริการเปิด route ที่เกี่ยวข้องแล้ว แนะนำให้เริ่มจากการทำ Smoke Test ด้วยสื่อขนาดเล็กที่ไม่มีข้อมูลอ่อนไหว: รูปภาพหนึ่งภาพ เสียงยาวไม่กี่สิบวินาทีหนึ่งไฟล์ และวิดีโอสั้นหนึ่งไฟล์ โดยทดสอบอินพุต เอาต์พุต ปริมาณ Token และข้อความผิดพลาดแยกกัน
รูปทรงคำขอ Chat Completions แบบ compatible ที่พบได้ทั่วไปมีดังนี้ ให้แทนที่ model ด้วย ID ที่ถูกต้องซึ่งยืนยันแล้วจากไดเรกทอรีโมเดลแบบเรียลไทม์ของผู้ให้บริการ อย่าเดาชื่อโมเดลโดยตรง:
curl "$BASE_URL/chat/completions" \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-omni-flash",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "สรุปธีม ผู้พูด และเวลาสำคัญสามจุดของสื่อนี้"},
        {"type": "input_video", "video_url": {"url": "https://example.com/demo.mp4"}}
      ]
    }],
    "stream": false
  }'
input_video ด้านบนใช้เพื่ออธิบายว่า request แบบมัลติโมดัลจำเป็นต้องตรวจสอบรูปแบบ content block แยกต่างหากเท่านั้น ไม่ได้หมายความว่าอินเทอร์เฟซแบบ compatible ทั้งหมดจะยอมรับฟิลด์นี้ ก่อนเชื่อมต่อจริงควรดูเอกสารของผู้ให้บริการ และบันทึกแยกกันว่า:
- อินเทอร์เฟซรองรับวิดีโอ URL, Base64 หรือ file ID หรือไม่;
- ข้อจำกัดขนาดไฟล์เดี่ยว ความยาว รูปแบบ และ timeout ในการดาวน์โหลด;
- วิธีคำนวณและราคาของ Token สำหรับเสียง/วิดีโอ;
- รองรับการเรียกใช้เครื่องมือ, structured output และการส่งกลับแบบ streaming หรือไม่;
- การ retry เมื่อผิดพลาดจะถูกหักค่าบริการซ้ำหรือไม่
หากคุณเรียกใช้ผ่านเกตเวย์ของเว็บไซต์นี้ โปรดเปิดราคโมเดลแบบเรียลไทม์ก่อน เพื่อยืนยันโมเดล ID, อัตราคูณ และความสามารถปัจจุบัน จากนั้นใช้ยอดเงินจำนวนน้อยเพื่อตรวจสอบใบแจ้งยอดจริง บทความของเว็บไซต์นี้จะไม่นำราคาเปิดตัวอย่างเป็นทางการหรือราคาจากแพลตฟอร์มอื่นมาใช้เป็นราคาของเว็บไซต์นี้โดยตรง
เหมาะกับสถานการณ์ใดบ้าง?
1. การตัดต่อวิดีโอและการค้นคืนสื่อ
ให้โมเดลระบุช็อต บุคคล แอ็กชัน และเหตุการณ์เสียงก่อน แล้วค่อยส่งต่อให้เครื่องมือตัดต่อเพื่อทำ rough cut, คำบรรยาย และการจัดตอน ในการตรวจรับ ควรเปรียบเทียบความแม่นยำของไทม์สแตมป์และอัตราการตกหล่น ไม่ใช่ดูแค่ว่าสรุปอ่านลื่นไหลหรือไม่
2. มิวสิกวิดีโอและการบรรยายภาพยนตร์
โมเดลสามารถทำความเข้าใจภาพ บทสนทนา ดนตรี และโครงสร้างการเล่าเรื่องพร้อมกัน จากนั้นสร้างสคริปต์ คำอธิบายช็อต หรือร่างคำบรรยายผลงาน วิดีโอสุดท้ายยังต้องให้มนุษย์ตรวจสอบลิขสิทธิ์ ข้อเท็จจริง และคุณภาพภาษา
3. การประชุมและงานความรู้
วิดีโอการประชุมสามารถเข้าสู่ pipeline สำหรับการถอดเสียง การรู้จำผู้พูด บันทึกการประชุม การวิเคราะห์ความเสี่ยง และการสร้างงาน เมื่อเกี่ยวข้องกับลูกค้า พนักงาน หรือความลับทางธุรกิจ ต้องยืนยันขอบเขตการจัดเก็บข้อมูลและการส่งผ่านภายนอกก่อน
4. การวิจัยเชิงลึกแบบมัลติโมดัล
ใช้วิดีโอเป็นจุดเริ่มต้นของการวิจัย ผสานเว็บเพจ รูปภาพ เอกสาร และวิดีโออื่นๆ เพื่อเสริมบริบท เหมาะสำหรับการทบทวนคอร์สเรียน การวิจัยผลิตภัณฑ์ และการวิเคราะห์บทเรียนเชิงเทคนิค
เช็กลิสต์การเลือกใช้และการเชื่อมต่อ
- ยืนยันก่อนว่าผู้ให้บริการเปิดให้ใช้
Qwen3.8-Omni-Flashจริงหรือไม่ อย่าดูแค่หัวข้อข่าว - ใช้ไฟล์ขนาดเล็กที่ไม่มีข้อมูลอ่อนไหวเพื่อทดสอบข้อความ รูปภาพ เสียง และวิดีโอแยกกัน
- บันทึกขนาดไฟล์ ความยาว อินพุต/เอาต์พุต Tokens, latency, cache และการหักค่าบริการจริง
- สร้างชุดตัวอย่างตรวจรับแยกต่างหากสำหรับ OCR, การรู้จำผู้พูด, ไทม์สแตมป์, วิดีโอถามตอบ และการดำเนินการของเครื่องมือ
- วางการทำความเข้าใจวิดีโอ การอ่านไฟล์ การสร้างงาน การส่งอีเมล และการรันโค้ดไว้ในขอบเขตสิทธิ์ที่แตกต่างกัน
- ตั้งงบประมาณ timeout, retry และเงื่อนไขให้มนุษย์เข้าควบคุมสำหรับงานยาว
- เขียนเวอร์ชันโมเดล วันที่ request, ผู้ให้บริการ โปรโตคอล และโครงสร้างผลลัพธ์ลงใน log ที่ตรวจสอบย้อนกลับได้
คำถามที่พบบ่อย
Qwen3.8-Omni-Flash เป็นโมเดล vision ทั่วไปหรือไม่?
ไม่ใช่ การวางตำแหน่งในการเปิดตัวคือโมเดล Omnimodal แบบ native โดยอินพุตครอบคลุมข้อความ รูปภาพ เสียง และวิดีโอ และผสานการทำความเข้าใจเสียงและวิดีโอกับการดำเนินการเครื่องมือของ Agent
รองรับวิดีโอยาวแค่ไหน?
เอกสารเปิดตัวกล่าวถึงอินพุตเสียงและวิดีโอความยาวสูงสุดหนึ่งชั่วโมง และบริบทยาว 1M ขีดจำกัดเฉพาะยังอาจได้รับผลกระทบจาก API, ขนาดไฟล์, การเข้ารหัส, ภูมิภาค และการ implement ของผู้ให้บริการ จึงควรยึดตามเอกสารอินเทอร์เฟซปัจจุบันและ request จริง
บริบท 1M หมายความว่าต้นทุนต้องต่ำลงเสมอหรือไม่?
ไม่ใช่ บริบทยาวขยายขอบเขตที่ประมวลผลได้ แต่การอัปโหลดไฟล์ Token ของเสียงและวิดีโอ วงรอบเครื่องมือ และเอาต์พุตล้วนก่อให้เกิดต้นทุน การตรวจสอบหลักฐานแบบ Agentic มีโอกาสลดการประมวลผลที่ไม่เกี่ยวข้อง แต่ต้องตรวจสอบด้วยปริมาณการใช้งานจริง
Qwen-Live Harness และ Qwen-MM-Plugins ต่างกันอย่างไร?
ตัวแรกเป็นสภาพแวดล้อมรันไทม์สำหรับปฏิสัมพันธ์ Omnimodal แบบเรียลไทม์และต่อเนื่อง ส่วนตัวหลังมุ่งที่การรับรู้ตามความต้องการ การเรียกใช้เครื่องมือ และการดำเนินเวิร์กโฟลว์สำหรับเสียงและวิดีโอยาว ทั้งสองเป็นโปรเจกต์ประกอบ ไม่เท่ากับโมเดล API เดียวกัน
เว็บไซต์นี้รองรับ Qwen3.8-Omni-Flash แล้วหรือยัง?
บทความไม่สามารถใช้แทนไดเรกทอรีแบบเรียลไทม์ได้ โปรดดูหน้าราคาโมเดล เพื่อยืนยันโมเดล ID, อัตราคูณ, ความสามารถด้านโมดาลิตี และใบแจ้งยอดจริงก่อนนำไปใช้ในการผลิต
สรุป
จุดสำคัญของโมเดล Omnimodal Qwen3.8-Omni-Flash คือการผลักดันเสียงและวิดีโอจาก “อินพุตที่โมเดลเข้าใจ” ไปสู่สื่อการทำงานที่ Agent สามารถตรวจสอบหลักฐานอย่างต่อเนื่อง วางแผน เรียกใช้เครื่องมือ และส่งมอบผลลัพธ์ได้ เหมาะกับการตรวจสอบด้วยงานจริงในขอบเขตเล็กก่อน: เริ่มจากทดสอบวิดีโอยาวถามตอบ บันทึกการประชุม และการค้นคืนสื่อ แล้วค่อยเพิ่มการตัดต่อ การวิจัย และการดำเนินงานตามลำดับ
แหล่งที่มา: หน้าออฟไลน์จากบัญชี WeChat เรื่อง “เปิดตัวโมเดล Omnimodal Qwen3.8-Omni-Flash” ที่ผู้ใช้จัดเตรียมให้; รูปภาพเป็นภาพประกอบต้นฉบับจากหน้านั้น ซึ่งได้คัดลอกไปยังไดเรกทอรี static resources ของเว็บไซต์นี้แล้ว โดยไม่ได้ถือว่าสคริปต์ของหน้าเว็บหรือคำสั่งจากบุคคลที่สามเป็นเนื้อหาของบทความ.