DeepSeek V4.1 Flash Open Source: 552B-Architektur, API-Preis und Migration
DeepSeek V4.1 Flash wurde am 10. September 2026 veröffentlicht und die Gewichte sind offen verfügbar; die offizielle API-Modell-ID lautet deepseek-flash. Das Modell unterstützt nativ Text- und Bildeingaben und nutzt eine neue asymmetrische Struktur: 552B Parameter im Backbone, etwa 8B aktive Parameter pro Token bei der Eingabeverarbeitung und rund 16B bei der Generierung. Offizielle Ankündigung
Für Entwickler ist nicht nur der Benchmark-Sprung relevant. Drei Punkte wirken sich direkt auf Integrationen aus: stärkere Agent-Fähigkeiten, niedrigere Cache-Kosten für lange Sitzungen und ein tatsächlicher Modellwechsel hinter alten Namen. Besonders wichtig ist deepseek-v4-pro, für das DeepSeek eine Routing-Umstellung nach dem 14. September, 12:00 Uhr Pekinger Zeit angekündigt hat.
Die Abbildungen in diesem Artikel stammen aus der offiziellen DeepSeek-Veröffentlichung. Die Benchmark-Zahlen sind Herstellerangaben und wurden von dieser Website nicht unabhängig neu gemessen.
Was ist DeepSeek V4.1 Flash? Die wichtigsten Spezifikationen
| Punkt | Veröffentlichte Information |
|---|---|
| Veröffentlichungsdatum | 10. September 2026 |
| Offizieller API-Modellname | deepseek-flash |
| Modelltyp | Natives multimodales MoE, Text und Bilder als Eingabe, Text als Ausgabe |
| Backbone-Parameter | 552B, etwa 552 Milliarden Parameter |
| Aktive Parameter Eingabe / Ausgabe | 8B / 16B (prefill / decode) |
| Kernarchitektur | Causal Encoder-Decoder, kurz CED |
| Kontextfenster | 1M Tokens |
| Maximale API-Ausgabe | 384K Tokens |
| Globaler KV Cache | 890 bytes / Token, etwa ein Viertel von V4 Flash |
| Lizenz für Gewichte und Repository | MIT |
Parameter und Architektur folgen der offiziellen DeepSeek Model Card. Kontext, Ausgabegrenze und API-Funktionen sind auf der offiziellen Preis- und Modellseite zu prüfen. Manche Zusammenfassungen runden auf etwa 550B; dieser Artikel verwendet die offizielle Angabe 552B.
Wenn Sie den Zugriff über diese Website planen, prüfen Sie zuerst die Live-Modellpreise. Offizielle Veröffentlichung und Synchronisierung einer Drittanbieter-Gateway-Route sind getrennte Vorgänge: Konfigurieren Sie die tatsächlich angezeigte Modell-ID, und verlassen Sie sich für Preis und Verfügbarkeit auf den aktuellen Katalog, reale API-Antworten und die Rechnung.
Was bedeuten 552B, 8B und 16B?
Ein MoE-Modell nutzt nicht bei jedem generierten Token alle Parameter. 552B beschreibt die Größe des Modell-Backbones; 8B und 16B beschreiben die aktivierten Parameter pro Token in den jeweiligen Berechnungsschritten. Diese Zahlen sind keine drei austauschbaren Modellgrößen.
Der CED-Backbone von V4.1 Flash besteht aus 40 Schichten: 20 kausalen Encoder-Schichten und 20 Decoder-Schichten. Laut Model Card wird der globale KV Cache des Decoders aus dem finalen Hidden State des Encoders projiziert, statt von jeder Decoder-Schicht separat erzeugt zu werden. Dadurch können Eingabeverarbeitung und Ausgabegenerierung unterschiedliche Rechenumfänge nutzen.
Für Codebase-Analyse, lange Dokumente und mehrstufige Tool-Aufrufe, bei denen viel Eingabe wiederholt gelesen wird, senkt dieses Design vor allem den Aufwand der Eingabeverarbeitung. Es bedeutet nicht, dass Qualität nur anhand aktiver Parameter beurteilt werden kann oder dass beim Deployment nur 8B Gewichte geladen werden müssten.
Wo verbessern sich Agent-Benchmarks gegenüber V4 Pro?
Die folgende Tabelle übernimmt Werte aus der offiziellen Model Card. Die Spalte “Änderung” ist eine Punktdifferenz, kein relativer Prozentsatz.
| Benchmark | V4 Pro | V4.1 Flash | Änderung |
|---|---|---|---|
| DeepSWE v1.1 | 62.7 | 74.2 | +11.5 |
| Terminal-Bench 3.0 | 11.8 | 30.0 | +18.2 |
| AutomationBench | 43.2 | 54.8 | +11.6 |
| CyberGym | 83.3 | 88.1 | +4.8 |
| GPQA Diamond | 92.4 | 90.9 | −1.5 |
Die ersten vier Zeilen zeigen, dass V4.1 Flash auf mehreren Code-, Terminal- und Automatisierungsbenchmarks vor dem früheren Pro liegt. GPQA Diamond bleibt jedoch unter V4 Pro. Die präzise Aussage lautet daher: Die Agent-Fähigkeiten steigen deutlich, aber nicht jede Fähigkeit liegt überall vorn. Offizielle Ergebnistabelle und Testbedingungen
Ebenso wichtig ist die Laufzeitumgebung. Die Instruct-Vergleiche in der Model Card nutzen maximale Reasoning-Stärke, temperature=1.0 und top_p=0.95. Der DeepSWE-v1.1-Wert 74.2 bezieht sich auf die mini-SWE-Umgebung; dasselbe Modell erreicht unter DSH Minimal 72.6. Modellversion, Task-Set, Agent-Framework und Reasoning-Budget bestimmen gemeinsam das Ergebnis.
Für die Modellauswahl sollten Sie drei kleine eigene Aufgaben ziehen: eine Codekorrektur mit vorhandenem Test, eine Terminal-Aufgabe mit mehreren Befehlen und eine Dokumentenaufgabe mit Screenshot oder Diagramm. Vergleichen Sie Akzeptanzrate, Gesamtdauer und Rechnung; das ist praxisnäher als ein einzelner Ranglistenwert.
API-Preis: 1 Yuan Input und 4 Yuan Output pro Million Tokens in Off-Peak-Zeiten
Die Preise gelten seit dem 10. September 2026 um 12:00 Uhr Pekinger Zeit. Alle Werte unten sind die offiziellen RMB-Direktpreise von DeepSeek in Yuan / Million Tokens, nicht die Preise dieses Gateways. Offizielle Preisseite
| Abrechnungsposten | Off-Peak | Peak |
|---|---|---|
| Input: Cache Hit | ¥0.02 | ¥0.04 |
| Input: Cache Miss | ¥1.00 | ¥2.00 |
| Output | ¥4.00 | ¥8.00 |
Peak-Zeiten sind Montag bis Freitag 09:00—12:00 und 14:00—18:00 Pekinger Zeit. Alle übrigen Zeiten sind Off-Peak, inklusive Wochenende. Nutzen Sie genau diese Zeitfenster und wenden Sie keine eigene Feiertags- oder Ausgleichstag-Logik an.
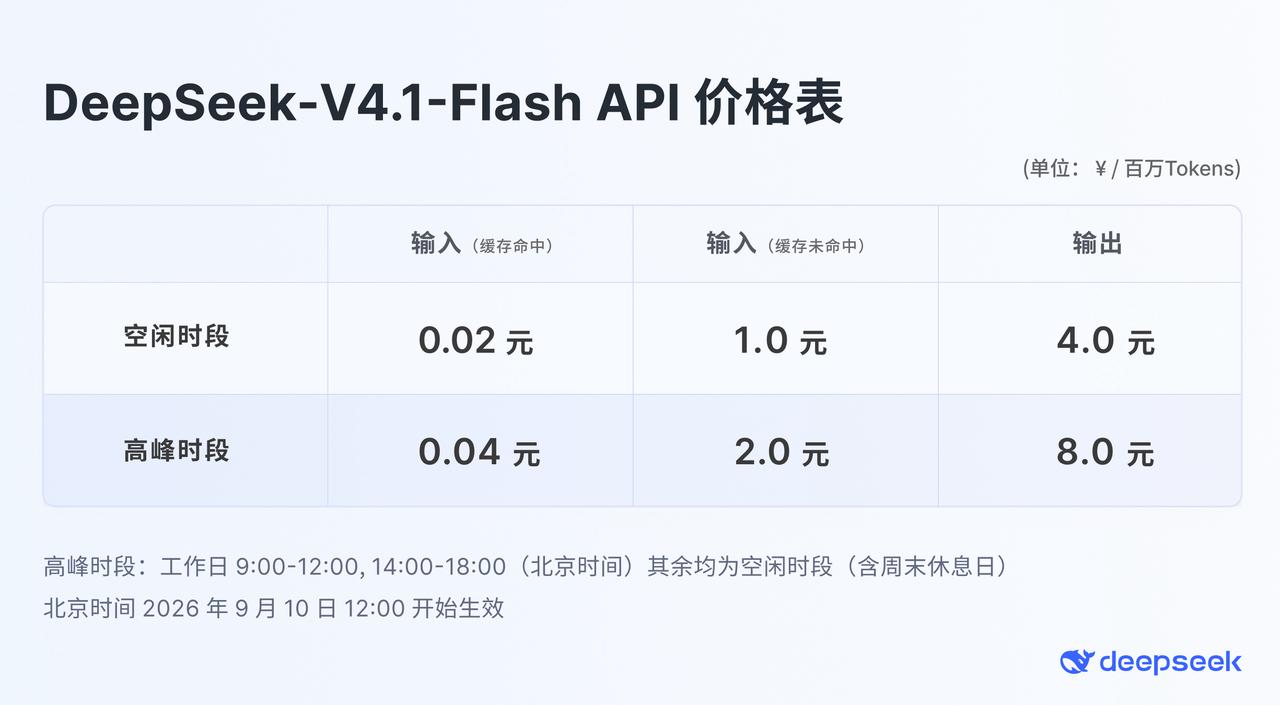
Quelle: offizielle DeepSeek-Ankündigung, Bild unverändert. Preise können sich ändern; Drittanbieter rechnen separat ab.
Ein nachrechenbares Agent-Kostenbeispiel
Angenommen, ein Aufgabenpaket verbraucht 8 Millionen Cache-Hit-Input-Tokens, 2 Millionen Cache-Miss-Input-Tokens und 0,5 Millionen Output-Tokens, vollständig in derselben Zeitkategorie:
Gesamtkosten = Millionen Hit-Input × Hit-Preis
             + Millionen Miss-Input × Miss-Preis
             + Millionen Output × Output-Preis

Off-Peak: 8 × 0.02 + 2 × 1 + 0.5 × 4 = 4.16 Yuan
Peak: 8 × 0.04 + 2 × 2 + 0.5 × 8 = 8.32 Yuan
Die beiden Input-Preise unterscheiden sich tatsächlich um den Faktor 50, aber die gesamte Aufgabe wird dadurch nicht 50-mal billiger. In diesem Beispiel kostet der Off-Peak-Cache-Hit-Anteil nur 0.16 Yuan, während Cache-Miss-Input und Output jeweils 2 Yuan kosten. Optimierung sollte daher Cache-Hits, Tool-Schleifen, überlange Ausgaben und Wiederholungen gemeinsam betrachten.
Warum ein kleinerer KV Cache bei langen Sitzungen wichtiger ist
Der KV Cache speichert Zwischenergebnisse des Kontexts. Für Agenten, die dieselbe Codebasis, Systemanweisungen oder Historie wiederholt lesen, kann ein identischer Präfix erneute Berechnung reduzieren. V4.1 Flash komprimiert den globalen KV Cache auf 890 bytes / Token, etwa ein Viertel von V4 Flash. Offizielle Architekturangaben
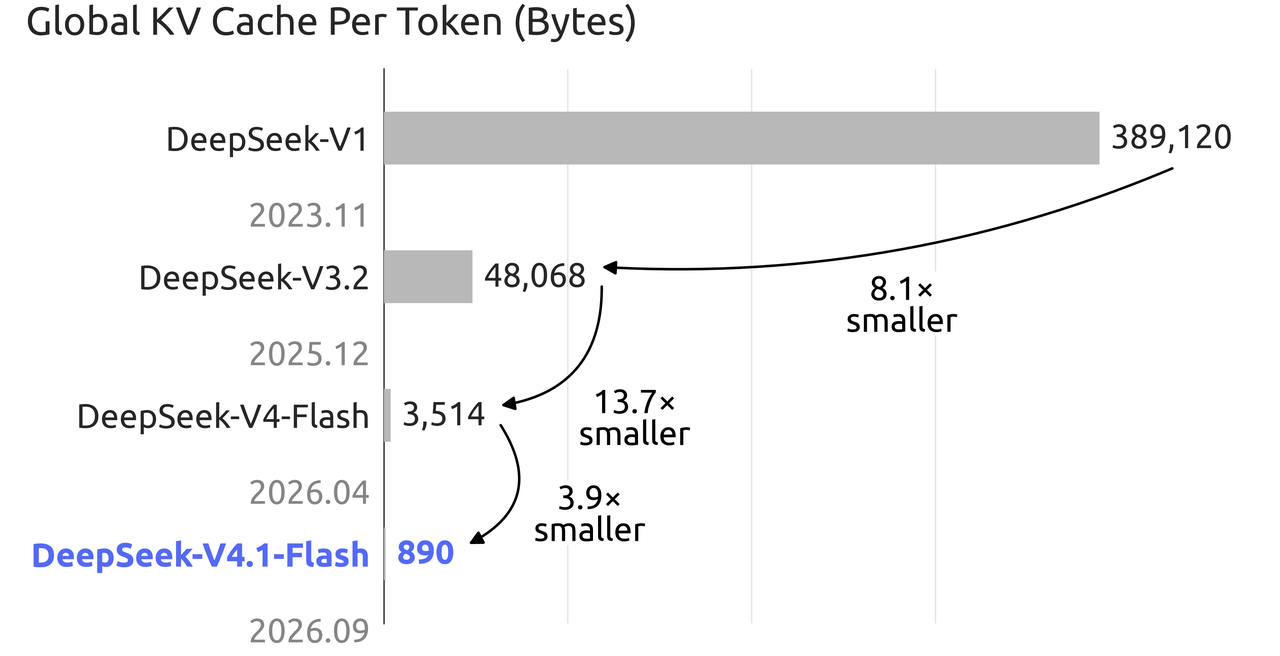
Quelle: offizielle DeepSeek-Ankündigung, Bild unverändert. Der Vergleich betrifft den globalen KV Cache pro Token, nicht den gesamten VRAM-Bedarf eines Deployments.
Zwei Speicherbegriffe müssen getrennt bleiben: DeepSeek nennt eine Reduktion des cachebezogenen HBM-Bedarfs auf etwa 1/4 und des SSD-Bedarfs auf etwa 1/8. Das beschreibt Cache-Ressourcen, nicht Modellgewichte, gesamte Laufzeitspeicher oder einen kompletten Cluster.
Für Integratoren heißt das: Halten Sie wiederverwendbare Präfixe stabil. Vermeiden Sie bei jeder Runde wechselnde Zeitstempel, Zufallsnummern oder neu sortierte Tool-Listen im Präfix. Prüfen Sie anschließend reale Usage-Felder auf Cache-Hits. “Inhaltlich ähnlich” genügt nicht als Hit-Prognose.
Wie ruft man die DeepSeek V4.1 Flash API auf?
Neue Integrationen verwenden direkt den offiziellen Namen deepseek-flash. Das folgende Beispiel nutzt die direkte DeepSeek Chat-Completions-API für Text; setzen Sie zuvor DEEPSEEK_API_KEY in der Shell. Das Beispiel wurde nicht als bezahlter Aufruf über diese Website validiert.
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {
        "role": "user",
        "content": "Liste Implementierungsschritte, Grenzfälle und Abnahmekriterien für ein Tool auf, das Markdown-Dateien stapelweise umbenennt."
      }
    ],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "high",
    "max_tokens": 2048,
    "stream": false
  }'
Erwartet wird JSON; der Antworttext liegt in choices[0].message.content. Prüfen Sie HTTP-Status, Inhalt und usage, nicht nur, ob die Anfrage gesendet wurde. Offizielle Quickstart-Anleitung
Native Vision bedeutet, dass das Modell Bilder versteht, nicht Bilder erzeugt. Für Screenshots fügen Sie gemäß offiziellem Vision-Guide Bildblöcke in die Nachricht ein. Eine erfolgreiche reine Textanfrage ersetzt keine separaten Tests für Bildeingabe, Tool-Aufrufe und Streaming.
Bei Drittanbieter-Gateways prüfen Sie Base URL, Modell-ID, Authentifizierung und Protokollunterstützung gemeinsam. Das reine Austauschen der offiziellen Adresse garantiert weder gleiche Fähigkeiten noch gleiche Abrechnung.
Funktionieren alte Modelle noch? Wann wird V4 Pro umgestellt?
| Aktuell konfigurierte Modell-ID | Offizielle Behandlung |
|---|---|
deepseek-flash |
Empfohlener Name für neue Integrationen, ruft V4.1 Flash auf |
deepseek-v4-flash |
Altes Modell abgeschaltet; Name bleibt vorübergehend kompatibel und routet zu V4.1 Flash |
deepseek-v4-flash-vision-exp |
Altes Modell abgeschaltet; Name bleibt vorübergehend kompatibel und routet zu V4.1 Flash |
deepseek-v4-pro |
Nach dem 14. September 2026 um 12:00 Uhr Pekinger Zeit und bis zur künftigen Veröffentlichung von V4.1 Pro wird alles zu V4.1 Flash geroutet und zum neuen Flash-Preis berechnet |
Diese Angaben stammen aus den offiziellen DeepSeek-Anweisungen. Drittanbieter-Gateways können andere Aliase oder einen anderen Zeitplan nutzen. Ein alter Name sperrt kein altes Modell fest und ist keine belastbare Rückfallstrategie auf frühere Gewichte.
Eine Migration kann in drei Schritten erfolgen: zuerst aktuelle Modellnamen und kritische Request-Beispiele exportieren; danach mit dem neuen Namen Text, Bild, Tools und Cache-Nutzung prüfen; zuletzt Standardmodell im Client, Task-Templates und Abrechnung kontrollieren. Für streng reproduzierbare Aufgaben speichern Sie Datum, tatsächlichen Anbieter und zurückgegebene Informationen, nicht nur einen alten Alias.
Was ist neu in DeepSeek Harness v0.1.5?
Das Modell übernimmt Verständnis und Reasoning; Harness verbindet Dateien, Befehle und Tools und macht aus Modellausgaben ausführbare Aufgaben. Mit diesem Release wurde DeepSeek Harness auf v0.1.5 aktualisiert, mit Anpassungen für Standardmodus, Programmatic Tool Calling (PTC) und Minimalmodus.
Den Release-Materialien zufolge unterstützt die neue Version Bild- und PDF-Uploads, Dateibaum des Arbeitsbereichs und Artefaktvorschau, verbessert Wiederaufnahme und Navigation langer Sitzungen und stärkt Eltern-Kind-Agent-Kommunikation, Warteschlangen-Nachrichten und Task-Intervention. Experimentelle Agent Teams können über eine gemeinsame Aufgabenliste zusammenarbeiten, sind aber standardmäßig deaktiviert und verbrauchen zusätzliche Tokens.
Auf Systemen mit Node.js folgt der Start der offiziellen Repository-Anleitung:
npx @deepseek-ai/dsh web
Tragen Sie im Webinterface den DeepSeek API Key ein, wählen Sie den Arbeitsbereich und senden Sie eine Aufgabe. Der Befehl lädt die zur Laufzeit verfügbare Paketversion und fixiert nicht automatisch v0.1.5. Für reproduzierbare historische Umgebungen notieren Sie die tatsächlich verwendete Version.
Starten Sie mit einer kleinen abnahmefähigen Aufgabe:
Lies die Projektdokumentation im aktuellen Arbeitsbereich und erstelle einen Markdown-Einstiegsleitfaden.
Beschreibe Startbefehle, notwendige Konfiguration und einen minimalen Verifikationsschritt.
Lege nur docs/getting-started-draft.md neu an und ändere keinen Anwendungscode.
Prüfe am Ende, ob die genannten Pfade existieren, und liste nicht bestätigte Informationen.
Erwartet wird eine tatsächlich öffnbare Markdown-Datei, nicht nur ein “erledigt” im Chat. Prüfen Sie Datei, Pfade und Quellen der Startbefehle, bevor Sie Aufgaben erweitern. Weitere Client-Konfigurationen finden Sie in den Tutorials.
Kann man das offene Modell direkt auf einem normalen Computer deployen?
Nein. Aus “Eingabe aktiviert nur 8B” folgt nicht, dass 8B-Hardware genügt. Der Backbone von V4.1 Flash bleibt 552B groß; reales Deployment hängt außerdem von Gewichtpräzision, Runtime, Cache, Parallelität und Storage ab.
Modell und Gewichte stehen unter MIT-Lizenz; Einstiegspunkte sind das offizielle Modell-Repository und der technische Bericht. Die Ankündigung erwähnt Kooperationen für großskalige Deployments mit Teams, die etwa 2000 GPUs und Storage-Cluster-Ressourcen besitzen; das ist eine Kooperationsbedingung, keine veröffentlichte Mindestkonfiguration.
Für Teams, die Anwendungen bauen, Agenten betreiben oder geschäftliche Wirkung testen wollen, ist es meist sinnvoller, Qualität und Kosten zuerst per API zu messen und erst danach Self-Hosting zu prüfen.
Häufig gestellte Fragen
Hat DeepSeek V4.1 Flash 550B oder 552B Parameter?
Offizielle Veröffentlichung und Model Card verwenden 552B und bezeichnen dies als Backbone-Parameterzahl. 550B ist eine gerundete Darstellung in manchen Zusammenfassungen; für Spezifikationen und Deployment-Bewertungen sollte die offizielle 552B-Angabe verwendet werden.
Welche API-Modell-ID hat V4.1 Flash?
DeepSeek empfiehlt deepseek-flash. Leiten Sie nicht selbst deepseek-v4.1-flash aus dem Anzeigenamen ab; selbst wenn eine Drittplattform diesen Alias nutzt, ist es nicht der offizielle Direkt-API-Name.
Kauft 0,02 Yuan eine Million beliebiger Tokens?
Nein. 0,02 Yuan / Million Tokens gilt nur für Cache-Hit-Input in Off-Peak-Zeiten. Cache-Miss-Input, Output und Peak-Zeiten haben eigene Preise.
Unterstützt V4.1 Flash Vision und Bildgenerierung?
Es unterstützt Text- und Bildeingaben und generiert Text, also Screenshot-Verständnis, Diagrammanalyse und ähnliche Aufgaben. Die offizielle Model Card definiert es nicht als Bildgenerierungsmodell.
Ist V4 Pro bereits vollständig abgeschaltet?
Zum Veröffentlichungsdatum dieses Artikels, dem 10. September 2026, kündigte DeepSeek eine Umstellung nach dem 14. September um 12:00 Uhr an; vorher sollte man nicht schreiben, dass alles bereits umgestellt wurde. Die beiden alten Flash-Modelle sind abgeschaltet und ihre Namen nur vorübergehend kompatibel.
Rechnet diese Website nach DeepSeeks Peak/Off-Peak-Preisen ab?
Das sollte man nicht direkt ableiten. Die Tabelle beschreibt die direkte DeepSeek API; Modell-ID, Verfügbarkeit und Abrechnung auf dieser Website richten sich nach den Live-Modellpreisen und der realen Rechnung. Nach Bestätigung des Zielmodells können Sie mit kleinem Guthaben über die Kaufseite testen.
Fazit: Erst Gesamtkosten der Aufgabe prüfen, dann das Migrationsfenster
DeepSeek V4.1 Flash kombiniert native Vision, asymmetrische Berechnung und einen kompakteren Kontext-Cache. Für Agenten mit langen Eingaben und vielen Tool-Aufrufen ist das ein Update, das auf echten Aufgaben getestet werden sollte. Für bestehende API-Anwendungen ist am dringendsten, alte Alias-Routen und die Pro-Umstellung am 14. September zu prüfen.
Die praktische Reihenfolge lautet: Modell-ID bestätigen → mit eigenen Aufgaben abnehmen → Cache, Output und Rechnung prüfen → Konfiguration aktualisieren. So wird aus einer Modellankündigung ein messbares Anwendungsupgrade.
Quellen
- Offizielle DeepSeek V4.1 Flash Ankündigung: Veröffentlichungsdatum, 552B-Architektur, Preisstart und Migration.
- Offizielle DeepSeek V4.1 Flash Model Card: CED-Struktur, Benchmarks, Testbedingungen, KV Cache und MIT-Lizenz.
- Offizielle DeepSeek Modelle und Preise: RMB-Peak/Off-Peak-Preise, Kontext und Ausgabegrenze.
- Offizieller DeepSeek Quickstart: aktuelle Modell-ID, Request-Beispiel und kompatible Namen.
- Offizieller DeepSeek Vision-Guide: Bildeingabefähigkeit und Format.
- Offizielles DeepSeek Harness Repository: Startmethode und Developer-Preview-Status.
- Ergänzende Release-Materialien: WeChat-Artikel 1, WeChat-Artikel 2. Der Abschnitt zu Harness v0.1.5 basiert auf den dort bereitgestellten Informationen.
Quellen geprüft am 10. September 2026. Dieser Artikel ist eine Release-Einordnung und Integrationsanleitung, kein unabhängiger Performance-Test.