DeepSeek V4.1 Flash с открытыми весами: архитектура 552B, цены API и миграция
DeepSeek V4.1 Flash был выпущен 10 сентября 2026 года, а веса модели открыты; официальное имя для API — deepseek-flash. Модель нативно принимает текст и изображения, использует новую асимметричную структуру: магистраль содержит 552B параметров, при обработке входа на каждый Token активируется около 8B параметров, при генерации выхода — около 16B параметров. Официальный анонс
Для разработчиков важны не только более высокие бенчмарки. Три вещи напрямую влияют на интеграцию: усиление Agent-задач, снижение стоимости кэша в длинных диалогах и изменение фактической модели за старыми именами. Особенно это касается deepseek-v4-pro: официальный график маршрутизации после 14 сентября 2026 года, 12:00 по пекинскому времени уже опубликован.
Иллюстрации ниже взяты из официального релиза DeepSeek без изменений. Бенчмарки — это результаты поставщика, а не независимое повторное тестирование нашего сайта.
Что такое DeepSeek V4.1 Flash: ключевые характеристики
| Параметр | Опубликованная информация |
|---|---|
| Дата релиза | 10 сентября 2026 года |
| Официальное имя API | deepseek-flash |
| Тип модели | Нативная мультимодальная MoE: принимает текст и изображения, генерирует текст |
| Размер магистрали | 552B, около 552 млрд параметров |
| Активные параметры ввода / вывода | 8B / 16B (prefill / decode) |
| Архитектура | Causal Encoder-Decoder, CED |
| Контекстное окно | 1M Tokens |
| Максимальный API-вывод | 384K Tokens |
| Глобальный KV Cache | 890 bytes / Token, около четверти V4 Flash |
| Лицензия весов и репозитория | MIT |
Параметры и архитектуру стоит сверять с официальной модельной карточкой DeepSeek, а лимиты контекста, вывода и интерфейса — с официальной страницей цен API. Некоторые пересказы округляют размер до 550B; в этой статье используется официальный показатель 552B.
Если вы планируете подключать модель через наш сайт, сначала проверьте актуальные цены моделей. Официальный релиз и синхронизация стороннего шлюза — разные события: настраивайте фактический model ID из каталога, а цены и доступность нашего сайта подтверждайте каталогом, ответами API и счетами.
Что означают 552B, 8B и 16B?
MoE-модель не задействует все параметры для каждого Token. 552B — это размер магистрали, а 8B и 16B — активный вычислительный масштаб на Token в соответствующих стадиях. Их нельзя считать тремя взаимозаменяемыми «размерами модели».
Магистраль CED в V4.1 Flash состоит из 40 слоев: 20 слоев causal encoder и 20 слоев decoder. По модельной карточке, глобальный KV Cache декодера строится проекцией финального скрытого состояния encoder, а не отдельно каждой декодерной прослойкой. Поэтому обработка входа и генерация выхода могут использовать разные вычислительные масштабы.
Для анализа кодовых баз, чтения длинных материалов и многошаговых вызовов инструментов такая схема уменьшает нагрузку на обработку входа. Но это не значит, что качество ввода и вывода можно оценивать только по активным параметрам, и не значит, что для загрузки или деплоя нужны только веса уровня 8B.
Где выросли Agent-бенчмарки? Сравнение с V4 Pro
В таблице ниже приведены официальные результаты из модельной карточки. В последнем столбце указана разница в баллах, а не относительный процент.
| Бенчмарк | V4 Pro | V4.1 Flash | Изменение |
|---|---|---|---|
| DeepSWE v1.1 | 62.7 | 74.2 | +11.5 |
| Terminal-Bench 3.0 | 11.8 | 30.0 | +18.2 |
| AutomationBench | 43.2 | 54.8 | +11.6 |
| CyberGym | 83.3 | 88.1 | +4.8 |
| GPQA Diamond | 92.4 | 90.9 | −1.5 |
Первые четыре строки показывают, что V4.1 Flash опережает прошлое поколение Pro на ряде кодовых, терминальных и автоматизационных задач. Но GPQA Diamond ниже, чем у V4 Pro. Точная формулировка: Agent-возможности заметно выросли, но модель не лидирует абсолютно во всех способностях. Официальная таблица и условия тестов
Среда запуска тоже важна. В официальном сравнении Instruct использовались максимальная reasoning-интенсивность, temperature=1.0 и top_p=0.95; 74.2 в DeepSWE v1.1 относится к mini-SWE, а в DSH Minimal та же модель набрала 72.6. Версия модели, набор задач, Agent-фреймворк и бюджет рассуждения вместе влияют на итог.
Для выбора модели лучше взять три собственных образца: исправление кода с уже существующим тестом, терминальную задачу с несколькими командами и материал со скриншотом или графиком. Сравнивайте completion rate, общее время и счет — это ближе к реальной выгоде, чем один рейтинг.
Цены API: 1 юань за вход и 4 юаня за выход / миллион Token в непиковое время
Цены вступили в силу 10 сентября 2026 года в 12:00 по пекинскому времени. Ниже указаны официальные прямые цены DeepSeek в RMB, за миллион Tokens; это не тариф нашего шлюза. Официальная страница цен
| Статья счета | Непиковое время | Пиковое время |
|---|---|---|
| Вход: cache hit | ¥0.02 | ¥0.04 |
| Вход: cache miss | ¥1.00 | ¥2.00 |
| Выход | ¥4.00 | ¥8.00 |
Пиковое время — понедельник–пятница 09:00—12:00 и 14:00—18:00 по пекинскому времени; все остальное время, включая выходные, считается непиковым. Следует использовать именно этот интервал, а не самостоятельно переносить праздничные графики.
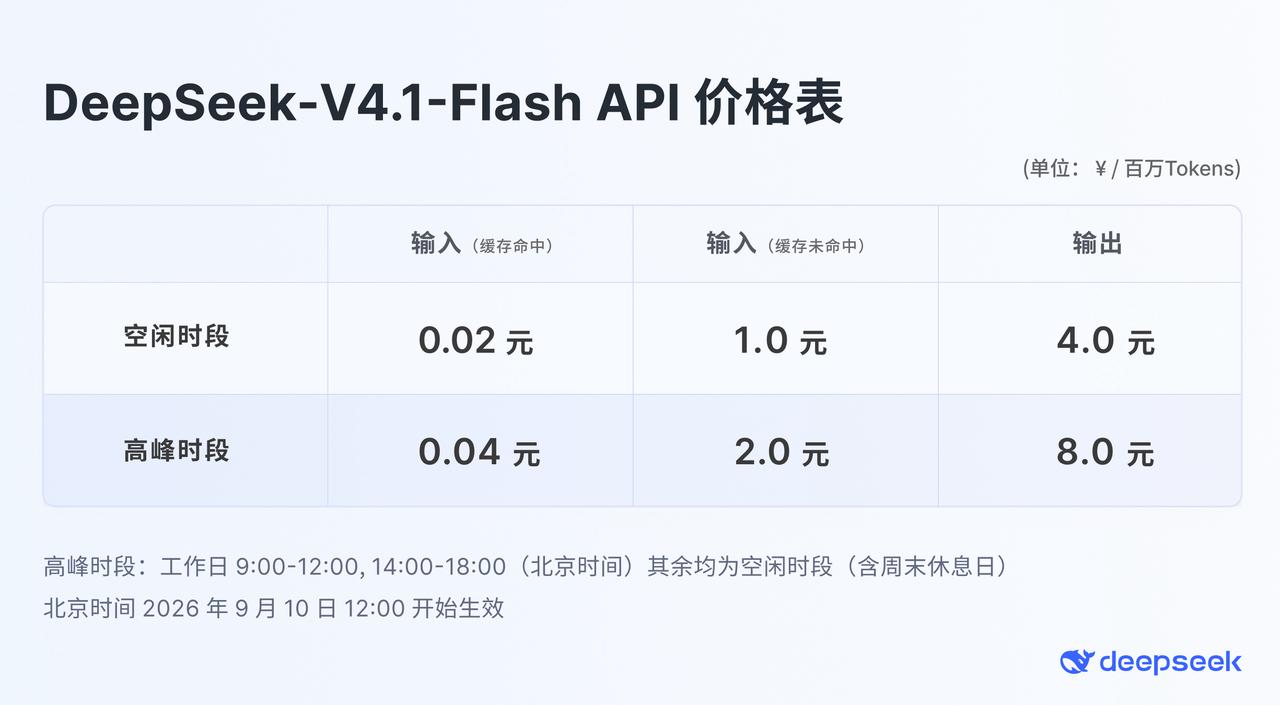
Источник: официальный релиз DeepSeek, изображение без изменений. Цены могут меняться; сторонние сервисы считают отдельно.
Воспроизводимый пример счета Agent
Допустим, пакет задач израсходовал 8 млн входных Tokens с попаданием в кэш, 2 млн входных Tokens без попадания и 0.5 млн выходных Tokens, все в одном тарифном интервале:
Итого = млн hit-входа × цена hit
      + млн miss-входа × цена miss
      + млн выхода × цена выхода

Непиковое время: 8 × 0.02 + 2 × 1 + 0.5 × 4 = 4.16 юаня
Пиковое время:   8 × 0.04 + 2 × 2 + 0.5 × 8 = 8.32 юаня
Разница между двумя входными ценами действительно 50-кратная, но это не означает, что вся задача дешевле в 50 раз. В примере кэшированные входы стоят всего 0.16 юаня, а miss-вход и вывод — по 2 юаня. Оптимизация должна смотреть не только на кэш, но и на повторные tool calls, чрезмерный output и retries.
Почему меньший KV Cache важен для длинных сессий?
KV Cache хранит промежуточные результаты контекста. Для Agent, которые снова и снова читают один и тот же репозиторий, системные инструкции и историю диалога, повторное использование общего префикса снижает повторные вычисления. V4.1 Flash сжимает глобальный KV Cache до 890 bytes / Token, примерно до четверти V4 Flash. Архитектурное описание
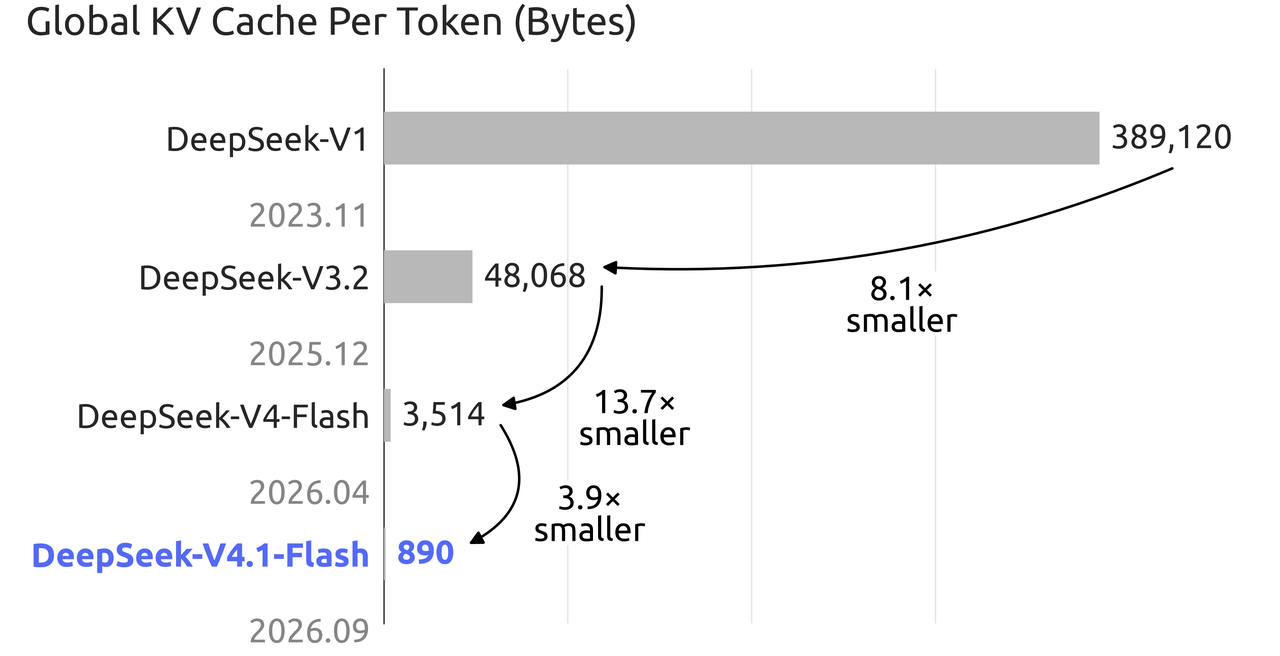
Источник: официальный релиз DeepSeek, изображение без изменений. На графике сравнивается глобальный KV Cache на Token, а не общий VRAM для деплоя модели.
Важно разделять два типа хранения: по официальным материалам потребность HBM для кэша снижается примерно до 1/4, а SSD — примерно до 1/8. Это относится к ресурсам кэша, а не к весам модели, всей оперативной памяти или размеру кластера в той же пропорции.
Для интеграторов практический первый шаг — стабилизировать повторяемый префикс: не добавлять в него меняющиеся timestamps, случайные IDs или переупорядоченные списки инструментов на каждом шаге. Затем проверяйте фактический hit rate по usage. Не оценивайте попадание в кэш только по ощущению, что «контент похож».
Как вызвать DeepSeek V4.1 Flash API?
Для новой интеграции используйте официальное имя deepseek-flash. Ниже пример текстового запроса к прямому Chat Completions API; сначала задайте DEEPSEEK_API_KEY в терминале. Пример не проверялся как платный вызов через наш сайт.
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {
        "role": "user",
        "content": "Составь шаги реализации, граничные случаи и критерии приемки для инструмента массового переименования Markdown-файлов."
      }
    ],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "high",
    "max_tokens": 2048,
    "stream": false
  }'
Ожидается JSON, а текст ответа находится в choices[0].message.content. При проверке смотрите HTTP status, содержимое ответа и usage; одного факта отправки запроса недостаточно. Официальное руководство первого вызова
Нативное зрение означает, что модель понимает изображения, а не генерирует их. Для скриншотов добавляйте image content blocks согласно официальному vision guide. Успешный текстовый запрос не заменяет отдельную проверку image input, tool calls и streaming.
Если вызов идет через сторонний шлюз, отдельно сверяйте Base URL, model ID, auth и поддержку протокола. Простая замена официального адреса не гарантирует те же возможности и биллинг.
Можно ли продолжать использовать старые модели? Когда переключается V4 Pro?
| Текущее имя модели | Официальная обработка |
|---|---|
deepseek-flash |
Рекомендуемое имя для новой интеграции, вызывает V4.1 Flash |
deepseek-v4-flash |
Старая модель снята; имя временно совместимо и маршрутизируется на V4.1 Flash |
deepseek-v4-flash-vision-exp |
Старая модель снята; имя временно совместимо и маршрутизируется на V4.1 Flash |
deepseek-v4-pro |
После 2026-09-14 12:00 по Пекину, до выхода будущего V4.1 Pro, маршрутизируется на V4.1 Flash и тарифицируется по новым Flash-ценам |
Это официальная схема DeepSeek; сторонние шлюзы могут иметь другие aliases и иной график миграции. Сохранение старого имени не фиксирует старую модель и не является планом отката к старым весам.
Практичная миграция состоит из трех шагов: выгрузить текущие model names и ключевые request samples; проверить текст, изображения, инструменты и usage cache с новым именем; затем обновить default model, templates и биллинговые записи. Для строго воспроизводимых задач записывайте дату вызова, фактического поставщика и ответ, а не только старый alias.
Что изменилось в DeepSeek Harness v0.1.5?
Модель отвечает за понимание и рассуждение, а Harness соединяет файлы, команды и инструменты и превращает ответ модели в исполнимую задачу. Вместе с релизом модели DeepSeek Harness обновился до v0.1.5; модель адаптирована к standard mode, Programmatic Tool Calling (PTC) и minimal mode.
По материалам релиза новая версия поддерживает загрузку изображений и PDF, дерево файлов workspace и предпросмотр артефактов, улучшает восстановление длинных сессий и навигацию, а также усиливает двустороннюю коммуникацию parent/child Agent, queued messages и task intervention. Экспериментальные Agent Teams могут делить работу через общий список задач, но по умолчанию выключены и при включении расходуют дополнительные Tokens.
Если установлен Node.js, запуск по официальному репозиторию:
npx @deepseek-ai/dsh web
После запуска заполните DeepSeek API Key в веб-интерфейсе, выберите workspace и отправьте задачу. Команда получает доступную на момент запуска версию пакета и не фиксирует v0.1.5; для воспроизводимости записывайте фактическую версию.
Начните с небольшой приемочной задачи:
Read the current workspace project notes and create a Markdown getting-started guide.
Include startup commands, required configuration, and one minimal validation step.
Only add docs/getting-started-draft.md; do not change business code.
After completion, check whether the paths in the document exist and list anything that could not be confirmed.
Ожидаемый результат — реальный Markdown-файл, а не только сообщение в чате. Проверьте, что файл создан, пути корректны, а команды запуска имеют источник, затем расширяйте задачи. Дополнительные настройки клиентов смотрите в наших tutorials.
Можно ли развернуть open-source модель на обычном компьютере?
Из фразы «на входе активируется только 8B» нельзя сделать вывод, что достаточно железа уровня 8B. Магистраль V4.1 Flash все еще 552B; фактический деплой зависит от точности весов, runtime, cache, concurrency и storage.
Модель и веса опубликованы под MIT; входные точки — официальный репозиторий модели и технический отчет. В релизе упоминается сотрудничество по крупномасштабному деплою для команд с примерно 2000 GPU и storage cluster; это условие партнерства, а не опубликованная минимальная конфигурация.
Если ваша цель — приложения, Agent или проверка бизнес-эффекта, чаще разумнее сначала собрать свои quality/cost данные через API и только потом оценивать self-hosting.
FAQ
DeepSeek V4.1 Flash — это 550B или 552B?
Официальная страница и модельная карточка используют 552B и называют это размером магистрали. 550B — приблизительное число в некоторых пересказах; для спецификаций и оценки деплоя используйте официальный показатель.
Какой API model ID у V4.1 Flash?
Официальная рекомендация DeepSeek — deepseek-flash. Не пишите самостоятельно deepseek-v4.1-flash; даже если сторонняя платформа использует такой alias, это не официальное имя интерфейса.
Можно ли за 0.02 юаня получить 1 миллион любых Tokens?
Нет. 0.02 юаня / миллион Tokens относится только к cache-hit input в непиковое время. Cache miss input, output и пиковое время тарифицируются иначе.
V4.1 Flash поддерживает vision и генерацию изображений?
Он нативно принимает текст и изображения и генерирует текст, подходит для скриншотов и анализа диаграмм. Официальная модельная карточка не определяет его как image generation model.
V4 Pro уже полностью снят?
На дату публикации статьи, 10 сентября 2026 года, официально объявлен график переключения после 14 сентября 12:00; нельзя заранее писать, что он уже полностью переключен. Две старые Flash-модели уже сняты, а их имена временно совместимы.
Наш сайт считает по официальным peak/off-peak ценам?
Так напрямую выводить нельзя. Таблица относится к прямому DeepSeek API; model ID, доступность и биллинг нашего сайта смотрите в актуальных ценах моделей и фактических счетах. После выбора модели можно начать с небольшого теста через покупку.
Итог: сначала считайте полную стоимость задачи, потом окно миграции
DeepSeek V4.1 Flash объединяет нативное vision, асимметричные вычисления и более компактный cache контекста. Для Agent с длинным входом и многошаговыми tool calls это релиз, который стоит проверить на реальных задачах. Для существующих API-приложений срочнее всего уточнить routing старых aliases и время переключения Pro 14 сентября.
Практичный порядок: подтвердить model ID → проверить собственные задачи → сверить cache и output billing → обновить конфигурацию. Так релиз модели превращается в измеримое обновление приложения.
Источники
- Официальный релиз DeepSeek V4.1 Flash: дата, структура 552B, время вступления цен и миграция.
- Официальная модельная карточка DeepSeek V4.1 Flash: CED, evaluation table, test settings, KV Cache и MIT.
- Официальные модели и цены DeepSeek: RMB peak/off-peak цены, context и output limits.
- Официальный first-call guide DeepSeek: текущий model ID, примеры запросов и совместимые имена.
- Официальный vision guide DeepSeek: image input capabilities и формат.
- Официальный репозиторий DeepSeek Harness: запуск и developer preview.
- Дополнительные материалы релиза: WeChat article 1, WeChat article 2. Абзац о Harness v0.1.5 составлен по сопутствующим release materials.
Дата проверки материалов: 10 сентября 2026 года. Это разбор релиза и руководство по интеграции, а не независимый performance review.