DeepSeek V4.1 Flash de código aberto: arquitetura 552B, preço da API e guia de migração
O DeepSeek V4.1 Flash foi lançado em 10 de setembro de 2026 com os pesos abertos; o nome oficial para chamadas na API é deepseek-flash. O modelo aceita nativamente entradas de texto e imagem e usa uma nova estrutura assimétrica: 552B parâmetros no backbone, cerca de 8B parâmetros ativados por token no processamento da entrada e 16B na geração da saída. Anúncio oficial
Para quem desenvolve, a mudança não se resume aos benchmarks. Três pontos afetam diretamente a integração: maior capacidade para tarefas agentivas, menor custo de cache em sessões longas e mudança do modelo real por trás de nomes antigos. O caso mais importante é deepseek-v4-pro, cuja rota foi anunciada para mudar depois de 14 de setembro, às 12:00 no horário de Pequim.
As imagens deste artigo são os materiais originais publicados pela DeepSeek. Os números de benchmark vêm do fornecedor e não foram medidos novamente de forma independente por este site.
O que é o DeepSeek V4.1 Flash? Especificações principais
| Item | Informação publicada |
|---|---|
| Data de lançamento | 10 de setembro de 2026 |
| Nome oficial do modelo na API | deepseek-flash |
| Tipo de modelo | MoE multimodal nativo: texto e imagem na entrada, texto na saída |
| Parâmetros do backbone | 552B, cerca de 552 bilhões |
| Parâmetros ativos de entrada / saída | 8B / 16B (prefill / decode) |
| Arquitetura central | Causal Encoder-Decoder, ou CED |
| Janela de contexto | 1M tokens |
| Saída máxima na API | 384K tokens |
| KV Cache global | 890 bytes / token, aproximadamente um quarto do V4 Flash |
| Licença dos pesos e do repositório | MIT |
Os parâmetros e a estrutura devem ser consultados na model card oficial da DeepSeek. Contexto, limite de saída e recursos da API devem ser confirmados na página oficial de preços e especificações. Algumas republicações arredondam o número para 550B; este artigo usa a medida oficial de 552B.
Se você pretende usar o modelo por este site, comece pela página de preços em tempo real. Uma publicação oficial e a sincronização de um gateway de terceiros são coisas diferentes: configure o ID que aparece no catálogo e considere como referência o catálogo atual, as respostas reais e a cobrança efetiva.
O que significam 552B, 8B e 16B?
Um modelo MoE não ativa todos os parâmetros em cada token gerado. 552B é o tamanho do backbone; 8B e 16B são as quantidades ativadas por token nas respectivas etapas de cálculo. Portanto, não são três “tamanhos de modelo” intercambiáveis.
O backbone CED do V4.1 Flash tem 40 camadas: 20 camadas de encoder causal e 20 camadas de decoder. A model card informa que o KV Cache global do decoder é projetado a partir do estado oculto final do encoder, em vez de ser produzido separadamente por cada camada do decoder. Isso permite usar escalas de computação diferentes para processar a entrada e gerar a saída.
Para analisar bases de código, ler materiais longos e fazer chamadas de ferramentas em vários turnos, quando muito conteúdo de entrada é lido repetidamente, esse design reduz principalmente o custo do processamento inicial. Ele não significa que a qualidade possa ser julgada apenas pelos parâmetros ativos, nem que um deploy precise carregar apenas 8B de pesos.
Onde os benchmarks de agentes melhoram em relação ao V4 Pro?
A tabela abaixo reproduz os resultados da model card oficial. A coluna de mudança é uma diferença de pontos, não uma porcentagem relativa.
| Benchmark | V4 Pro | V4.1 Flash | Mudança |
|---|---|---|---|
| DeepSWE v1.1 | 62.7 | 74.2 | +11.5 |
| Terminal-Bench 3.0 | 11.8 | 30.0 | +18.2 |
| AutomationBench | 43.2 | 54.8 | +11.6 |
| CyberGym | 83.3 | 88.1 | +4.8 |
| GPQA Diamond | 92.4 | 90.9 | −1.5 |
As quatro primeiras linhas mostram que o V4.1 Flash supera o antigo Pro em várias tarefas de código, terminal e automação; no GPQA Diamond, porém, continua abaixo do V4 Pro. A conclusão mais precisa é: as capacidades agentivas avançaram bastante, mas o modelo não lidera em todos os tipos de tarefa. Tabela oficial e condições de teste
O ambiente de execução também é importante. A comparação Instruct da model card usa a intensidade máxima de raciocínio, temperature=1.0 e top_p=0.95. O resultado 74.2 do DeepSWE v1.1 corresponde ao ambiente mini-SWE; o mesmo modelo marca 72.6 no DSH Minimal. Versão, conjunto de tarefas, framework do agente e orçamento de raciocínio influenciam o resultado em conjunto.
Para escolher o modelo, retire três pequenas amostras das suas tarefas: uma correção de código com testes existentes, uma tarefa de terminal com vários comandos e uma tarefa documental com captura de tela ou gráfico. Compare taxa de aceitação, tempo total e cobrança; isso se aproxima mais do ganho real do que um único número de ranking.
Preço da API: 1 yuan de entrada e 4 yuans de saída por milhão de tokens fora do pico
Os preços entraram em vigor em 10 de setembro de 2026 às 12:00, horário de Pequim. Os valores abaixo são os preços oficiais da API direta da DeepSeek em RMB, em yuans / milhão de tokens; não são as tarifas deste gateway. Página oficial de preços
| Item de cobrança | Fora do pico | Horário de pico |
|---|---|---|
| Entrada: cache hit | ¥0.02 | ¥0.04 |
| Entrada: cache miss | ¥1.00 | ¥2.00 |
| Saída | ¥4.00 | ¥8.00 |
O horário de pico é de segunda a sexta, das 09:00 às 12:00 e das 14:00 às 18:00, no horário de Pequim. Todos os demais períodos são fora do pico, incluindo os fins de semana. Use esses intervalos explícitos e não aplique por conta própria uma lógica de feriados ou dias úteis compensados.
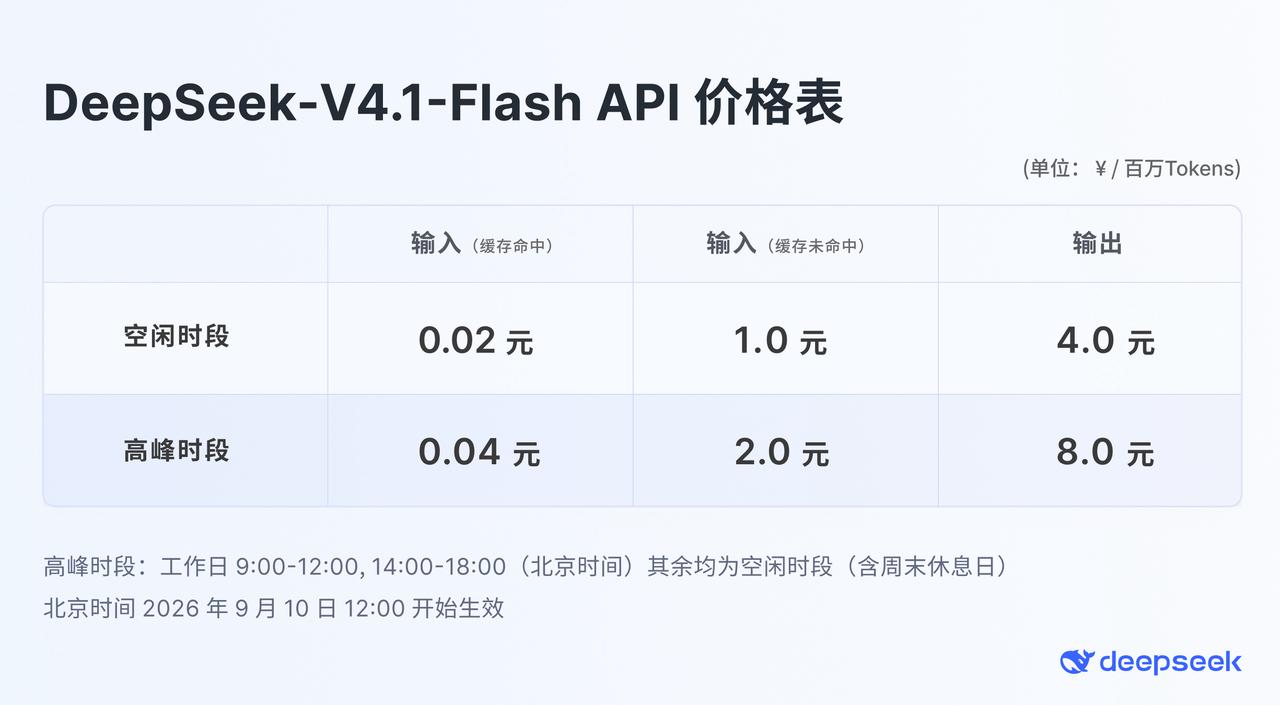
Fonte: anúncio oficial da DeepSeek, imagem sem alterações. Os preços podem mudar e provedores terceiros cobram separadamente.
Exemplo de cobrança agentiva reproduzível
Suponha que um lote de tarefas use 8 milhões de tokens de entrada com cache hit, 2 milhões de tokens de entrada com cache miss e 0,5 milhão de tokens de saída, tudo na mesma faixa de horário:
Custo total = milhões de entrada hit × preço hit
            + milhões de entrada miss × preço miss
            + milhões de saída × preço de saída

Fora do pico: 8 × 0.02 + 2 × 1 + 0.5 × 4 = 4.16 yuans
Pico: 8 × 0.04 + 2 × 2 + 0.5 × 8 = 8.32 yuans
Os dois preços de entrada realmente diferem por um fator de 50, mas isso não torna a tarefa inteira 50 vezes mais barata. Neste exemplo, a parte de cache hit fora do pico custa apenas 0,16 yuan, enquanto a entrada sem cache e a saída custam 2 yuans cada. Ao otimizar, observe o cache, as chamadas repetidas de ferramentas, saídas longas e retries.
Por que um KV Cache menor é mais importante em sessões longas?
O KV Cache armazena resultados intermediários do contexto. Para agentes que releem a mesma base de código, instruções do sistema e histórico, reutilizar um prefixo idêntico reduz parte do recálculo. O V4.1 Flash comprime o KV Cache global para 890 bytes / token, aproximadamente um quarto do V4 Flash. Descrição oficial da arquitetura
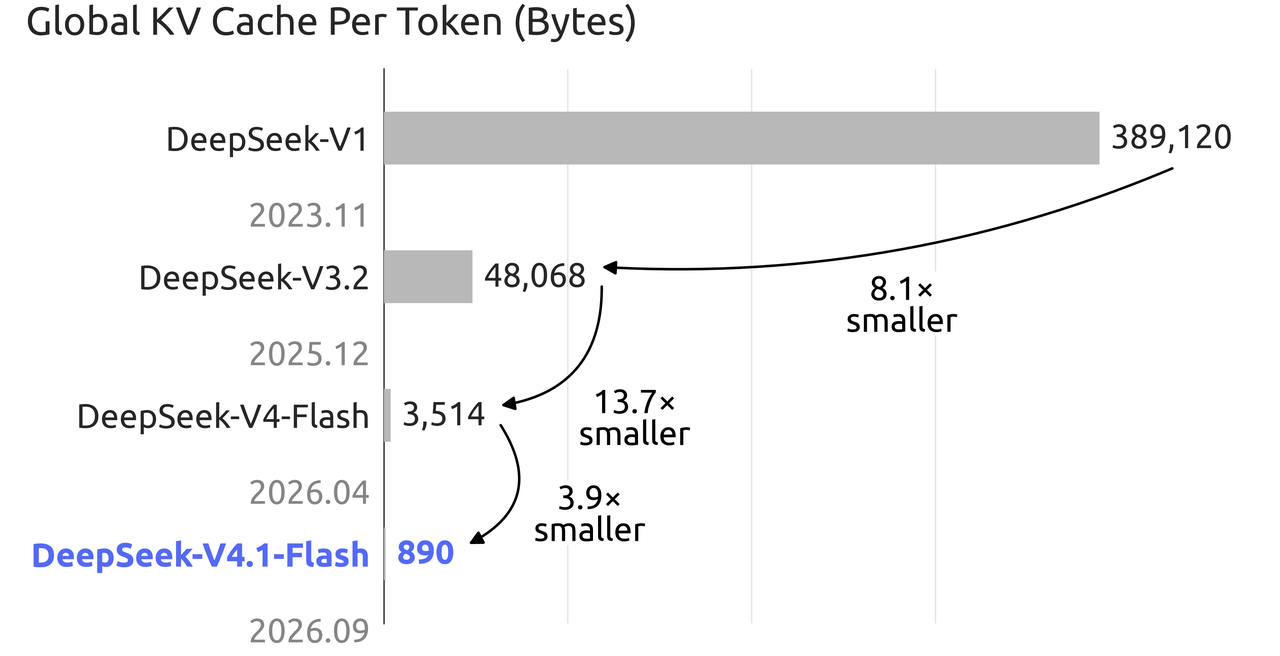
Fonte: anúncio oficial da DeepSeek, imagem sem alterações. A comparação é do KV Cache global por token, não da VRAM total do deployment.
É importante separar duas métricas de armazenamento: a DeepSeek informa que a demanda de HBM relacionada ao cache cai para cerca de 1/4 e a de SSD para cerca de 1/8. Isso descreve recursos de cache, não todos os pesos do modelo, toda a memória de execução ou o cluster inteiro.
Para quem integra, mantenha estáveis os prefixos reutilizáveis. Evite acrescentar a cada turno timestamps variáveis, identificadores aleatórios ou listas de ferramentas reordenadas. Depois, confirme os campos reais de uso para verificar os hits. Conteúdo “parecido” não basta para prever um cache hit.
Como chamar a API do DeepSeek V4.1 Flash?
Para uma integração nova, use o nome oficial deepseek-flash. O exemplo abaixo usa a API direta Chat Completions da DeepSeek para texto; defina antes DEEPSEEK_API_KEY no terminal. O exemplo não foi validado como chamada paga neste site.
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {
        "role": "user",
        "content": "Liste as etapas de implementação, os casos extremos e os critérios de aceite para uma ferramenta que renomeie arquivos Markdown em lote."
      }
    ],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "high",
    "max_tokens": 2048,
    "stream": false
  }'
A resposta esperada é JSON e o texto fica em choices[0].message.content. Na validação, confira status HTTP, conteúdo e usage, não apenas se a requisição foi enviada. Guia oficial do primeiro chamado
Visão nativa significa que o modelo entende imagens, não que as gera. Para processar capturas de tela, inclua blocos de imagem na mensagem seguindo o guia oficial de compreensão de imagens. Uma requisição apenas de texto não substitui testes separados de imagem, ferramentas e streaming.
Se usar um gateway de terceiros, confira em conjunto Base URL, ID do modelo, autenticação e protocolos aceitos. Trocar apenas o endereço oficial não garante as mesmas capacidades nem o mesmo comportamento de cobrança.
Os modelos antigos ainda funcionam? Quando o V4 Pro muda de rota?
| Nome atualmente configurado | Tratamento oficial |
|---|---|
deepseek-flash |
Nome recomendado para novas integrações; chama o V4.1 Flash |
deepseek-v4-flash |
Modelo antigo descontinuado; nome temporariamente compatível e roteado para o V4.1 Flash |
deepseek-v4-flash-vision-exp |
Modelo antigo descontinuado; nome temporariamente compatível e roteado para o V4.1 Flash |
deepseek-v4-pro |
Depois de 14 de setembro de 2026 às 12:00, horário de Pequim, e até o futuro lançamento do V4.1 Pro, todas as chamadas serão roteadas para o V4.1 Flash e cobradas pelo novo preço do Flash |
As regras acima vêm das instruções oficiais da DeepSeek. Gateways terceiros podem usar aliases ou cronogramas diferentes. Manter um nome antigo não fixa o modelo antigo e não é uma estratégia de fallback para os pesos anteriores.
A migração pode seguir três etapas: exporte primeiro os nomes de modelo e amostras importantes de requisições; depois teste com o novo nome texto, imagem, ferramentas e uso de cache; por fim confira modelo padrão do cliente, templates de tarefas e registros de cobrança. Em tarefas que exigem reprodução rigorosa, registre data, provedor real e informações retornadas, não apenas um alias antigo.
O que mudou no DeepSeek Harness v0.1.5?
O modelo entende e raciocina; o Harness conecta arquivos, comandos e ferramentas para transformar a saída do modelo em tarefas executáveis. Com este lançamento, o DeepSeek Harness foi atualizado para v0.1.5, com adaptação aos modos padrão, Programmatic Tool Calling (PTC) e minimalista.
Segundo os materiais do lançamento, a nova versão permite enviar imagens e PDFs, navegar pela árvore de arquivos do workspace e visualizar artefatos; melhora a recuperação e a navegação em sessões longas; e reforça a comunicação entre agentes pai e filho, mensagens em fila e intervenção em tarefas. Os Agent Teams experimentais podem dividir o trabalho por uma lista compartilhada, mas vêm desativados por padrão e consomem tokens adicionais.
Em um sistema com Node.js, siga as instruções do repositório oficial:
npx @deepseek-ai/dsh web
Na interface web, informe a chave da API DeepSeek, escolha o workspace e envie uma tarefa. Esse comando obtém a versão do pacote disponível no momento da execução e não fixa automaticamente a v0.1.5. Para reproduzir um ambiente histórico, registre também a versão efetivamente usada.
Comece com uma tarefa pequena e verificável:
Leia a documentação do projeto no workspace atual e gere um guia de início em Markdown.
Descreva os comandos de inicialização, a configuração necessária e uma etapa mínima de verificação.
Crie apenas docs/getting-started-draft.md; não altere o código de negócio.
No final, verifique se os caminhos citados existem e liste as informações não confirmadas.
O resultado esperado é um arquivo Markdown realmente criado e abrível, não apenas um “concluído” no chat. Confira se o arquivo existe, se os caminhos estão corretos e se os comandos têm uma fonte antes de ampliar a tarefa. Para outras configurações de cliente, consulte os tutoriais.
É possível fazer deploy do modelo aberto em um computador comum?
Não. Não é possível concluir que hardware de nível 8B seja suficiente só porque a entrada ativa 8B parâmetros. O backbone do V4.1 Flash continua tendo 552B; o deployment também depende da precisão dos pesos, runtime, cache, concorrência e armazenamento.
O modelo e os pesos usam a licença MIT; as entradas são o repositório oficial do modelo e o relatório técnico. O anúncio menciona parcerias de deployment em larga escala para equipes com cerca de 2000 GPUs e recursos de cluster de armazenamento; isso é uma condição de parceria, não uma configuração mínima publicada.
Para equipes cujo objetivo é criar aplicações, executar agentes ou validar resultados de negócio, normalmente é mais útil medir primeiro qualidade e custo pela API e só depois avaliar self-hosting.
Perguntas frequentes
O DeepSeek V4.1 Flash tem 550B ou 552B?
O anúncio oficial e a model card usam 552B para o tamanho do backbone. 550B é uma aproximação encontrada em alguns textos; use 552B em tabelas técnicas e avaliações de deployment.
Qual é o ID da API do V4.1 Flash?
A DeepSeek recomenda deepseek-flash. Não crie deepseek-v4.1-flash a partir do nome de apresentação; mesmo que uma plataforma terceira use esse alias, ele não é o nome oficial da API direta.
0,02 yuan compra um milhão de tokens quaisquer?
Não. 0,02 yuan por milhão de tokens vale apenas para entrada com cache hit fora do pico. Entrada sem cache, saída e horário de pico têm preços diferentes.
O V4.1 Flash suporta compreensão visual e geração de imagens?
Ele aceita texto e imagens na entrada e gera texto, podendo compreender capturas e analisar gráficos. A model card oficial não o define como um modelo de geração de imagens.
O V4 Pro já foi totalmente descontinuado?
Na data de publicação deste artigo, 10 de setembro de 2026, a DeepSeek havia anunciado a mudança depois de 14 de setembro às 12:00; portanto, antes dessa data não se deve dizer que a troca já ocorreu por completo. Os dois modelos Flash antigos já estavam descontinuados, mas os nomes mantinham compatibilidade temporária.
Este site cobra exatamente os preços fora/pico da DeepSeek?
Não se deve deduzir isso diretamente. A tabela descreve a API direta da DeepSeek; no site, ID, disponibilidade e cobrança devem ser confirmados na página de preços em tempo real e na fatura real. Depois de confirmar o modelo, faça um pequeno teste pela página de compra.
Conclusão: primeiro o custo total da tarefa, depois a janela de migração
O DeepSeek V4.1 Flash combina visão nativa, computação assimétrica e um cache de contexto mais compacto. Para agentes com entradas longas e várias chamadas de ferramentas, vale testá-lo em tarefas reais. Para aplicações que já usam a API, a prioridade é confirmar a mudança de rota dos aliases antigos e a transição do Pro em 14 de setembro.
A sequência prática é: confirmar o ID do modelo → validar com suas tarefas → conferir cache, saída e cobrança → atualizar a configuração. Assim, um lançamento de modelo se transforma em uma melhoria mensurável e realmente utilizável.
Fontes
- Anúncio oficial do DeepSeek V4.1 Flash: data, arquitetura 552B, início dos preços e migração.
- Model card oficial do DeepSeek V4.1 Flash: estrutura CED, benchmarks, condições de teste, KV Cache e licença MIT.
- Modelos e preços oficiais da DeepSeek: preços RMB fora/pico, contexto e limite de saída.
- Guia oficial do primeiro chamado da DeepSeek: ID atual, exemplo de requisição e nomes compatíveis.
- Guia oficial de compreensão de imagens da DeepSeek: capacidade e formato de imagem.
- Repositório oficial do DeepSeek Harness: método de inicialização e status de developer preview.
- Materiais complementares do lançamento: artigo do WeChat 1, artigo do WeChat 2. O trecho sobre o Harness v0.1.5 resume as informações apresentadas nesses materiais.
Fontes conferidas em 10 de setembro de 2026. Este artigo interpreta o lançamento e explica a integração; não é uma avaliação independente de desempenho.