DeepSeek V4.1 Flash mã nguồn mở: kiến trúc 552B, giá API và hướng dẫn chuyển đổi
DeepSeek V4.1 Flash được phát hành ngày 10/09/2026 và mở trọng số; tên gọi chính thức khi dùng API là deepseek-flash. Mô hình hỗ trợ gốc đầu vào văn bản và hình ảnh, dùng kiến trúc bất đối xứng mới: phần backbone có 552B tham số, mỗi Token kích hoạt khoảng 8B tham số khi xử lý đầu vào và khoảng 16B khi sinh đầu ra. Thông báo chính thức
Điều đáng chú ý với nhà phát triển không chỉ là điểm benchmark tăng. Ba thay đổi ảnh hưởng trực tiếp đến việc tích hợp là năng lực Agent tốt hơn, giá cache cho hội thoại dài thấp hơn và mô hình thực tế đứng sau các tên cũ đã thay đổi. Đặc biệt, DeepSeek đã công bố lịch chuyển tuyến của deepseek-v4-pro sau 12:00 ngày 14/09/2026 theo giờ Bắc Kinh.
Hình minh họa trong bài giữ nguyên ảnh phát hành chính thức của DeepSeek. Điểm benchmark là kết quả do nhà cung cấp công bố, chưa được trang này kiểm thử độc lập.
DeepSeek V4.1 Flash là gì? Thông số chính
| Hạng mục | Thông tin đã công bố |
|---|---|
| Ngày phát hành | 10/09/2026 |
| Tên model API chính thức | deepseek-flash |
| Loại mô hình | MoE đa phương thức gốc, nhận văn bản và hình ảnh, sinh văn bản |
| Quy mô backbone | 552B, khoảng 552 tỷ tham số |
| Tham số kích hoạt đầu vào / đầu ra | 8B / 16B (prefill / decode) |
| Kiến trúc | Causal Encoder-Decoder, gọi tắt là CED |
| Cửa sổ ngữ cảnh | 1M Tokens |
| Đầu ra API tối đa | 384K Tokens |
| Global KV Cache | 890 bytes / Token, khoảng một phần tư V4 Flash |
| Giấy phép trọng số và repository | MIT |
Thông số và kiến trúc nên được đối chiếu với model card chính thức của DeepSeek; context, giới hạn output và tính năng API xem tại trang giá API chính thức. Một số bài viết tóm tắt làm tròn thành 550B, còn bài này dùng con số chính thức 552B.
Nếu dự định tích hợp qua trang này, hãy xem giá model theo thời gian thực. Thông báo chính thức và việc gateway bên thứ ba đồng bộ là hai việc khác nhau: hãy cấu hình theo model ID thực tế trong danh mục, còn giá và khả dụng của trang phải căn cứ danh mục hiện tại, kết quả gọi và hóa đơn.
552B, 8B và 16B có ý nghĩa gì?
MoE không gọi toàn bộ tham số cho mỗi Token. 552B là quy mô tham số của backbone, còn 8B và 16B là quy mô tham số được kích hoạt cho mỗi Token ở các giai đoạn tính toán tương ứng. Không nên xem chúng là ba “kích thước mô hình” có thể thay thế cho nhau.
Backbone CED của V4.1 Flash có 40 lớp, gồm 20 lớp causal encoder và 20 lớp decoder. Model card cho biết global KV Cache của decoder được chiếu từ hidden state cuối của encoder, thay vì được tạo riêng ở từng lớp decoder. Nhờ đó, xử lý đầu vào và sinh đầu ra có thể dùng quy mô tính toán khác nhau.
Với phân tích codebase, đọc tài liệu dài và gọi công cụ nhiều vòng, thiết kế này giảm gánh nặng xử lý đầu vào. Tuy nhiên, không thể chỉ dựa vào số tham số kích hoạt để đánh giá chất lượng đầu vào/đầu ra, và cũng không có nghĩa triển khai chỉ cần tải trọng số cấp 8B.
Điểm Agent tăng ở đâu? So sánh với V4 Pro
Bảng dưới trích từ bảng so sánh trong model card chính thức. Cột thay đổi là chênh lệch điểm, không phải phần trăm tương đối.
| Bài đánh giá | V4 Pro | V4.1 Flash | Thay đổi |
|---|---|---|---|
| DeepSWE v1.1 | 62.7 | 74.2 | +11.5 |
| Terminal-Bench 3.0 | 11.8 | 30.0 | +18.2 |
| AutomationBench | 43.2 | 54.8 | +11.6 |
| CyberGym | 83.3 | 88.1 | +4.8 |
| GPQA Diamond | 92.4 | 90.9 | −1.5 |
Bốn dòng đầu cho thấy V4.1 Flash vượt V4 Pro thế hệ trước ở nhiều benchmark về code, terminal và tự động hóa; nhưng GPQA Diamond vẫn thấp hơn V4 Pro. Kết luận chính xác hơn là năng lực Agent cải thiện rõ rệt, chứ không phải mọi năng lực đều dẫn đầu. Bảng đánh giá và điều kiện thử chính thức
Môi trường chạy cũng quan trọng. So sánh Instruct trong model card dùng cường độ suy luận cao nhất, temperature=1.0, top_p=0.95; điểm 74.2 của DeepSWE v1.1 tương ứng môi trường mini-SWE, còn cùng model trên DSH Minimal là 72.6. Phiên bản model, bộ nhiệm vụ, framework Agent và ngân sách suy luận cùng ảnh hưởng kết quả.
Khi chọn model, hãy lấy ba mẫu từ công việc thực tế: một lỗi code có test sẵn, một tác vụ terminal cần nhiều lệnh và một tài liệu có ảnh chụp màn hình hoặc biểu đồ. So sánh tỷ lệ hoàn thành, tổng thời gian và hóa đơn sẽ sát lợi ích thực tế hơn việc chỉ nhìn một điểm benchmark.
Giá API: input 1 nhân dân tệ, output 4 nhân dân tệ / triệu Token ngoài giờ cao điểm
Mức giá có hiệu lực từ 12:00 ngày 10/09/2026 theo giờ Bắc Kinh. Bảng dưới là giá API trực tiếp chính thức của DeepSeek bằng RMB, tính theo triệu Tokens, không phải giá gateway của trang này. Trang giá chính thức
| Hạng mục | Ngoài giờ cao điểm | Giờ cao điểm |
|---|---|---|
| Input: cache hit | ¥0.02 | ¥0.04 |
| Input: cache miss | ¥1.00 | ¥2.00 |
| Output | ¥4.00 | ¥8.00 |
Giờ cao điểm là 09:00—12:00 và 14:00—18:00 từ thứ Hai đến thứ Sáu theo giờ Bắc Kinh; các thời gian khác, bao gồm cuối tuần, là ngoài giờ cao điểm. Hãy dùng đúng khung giờ này, không tự áp dụng lịch ngày làm việc sau điều chỉnh ngày lễ.
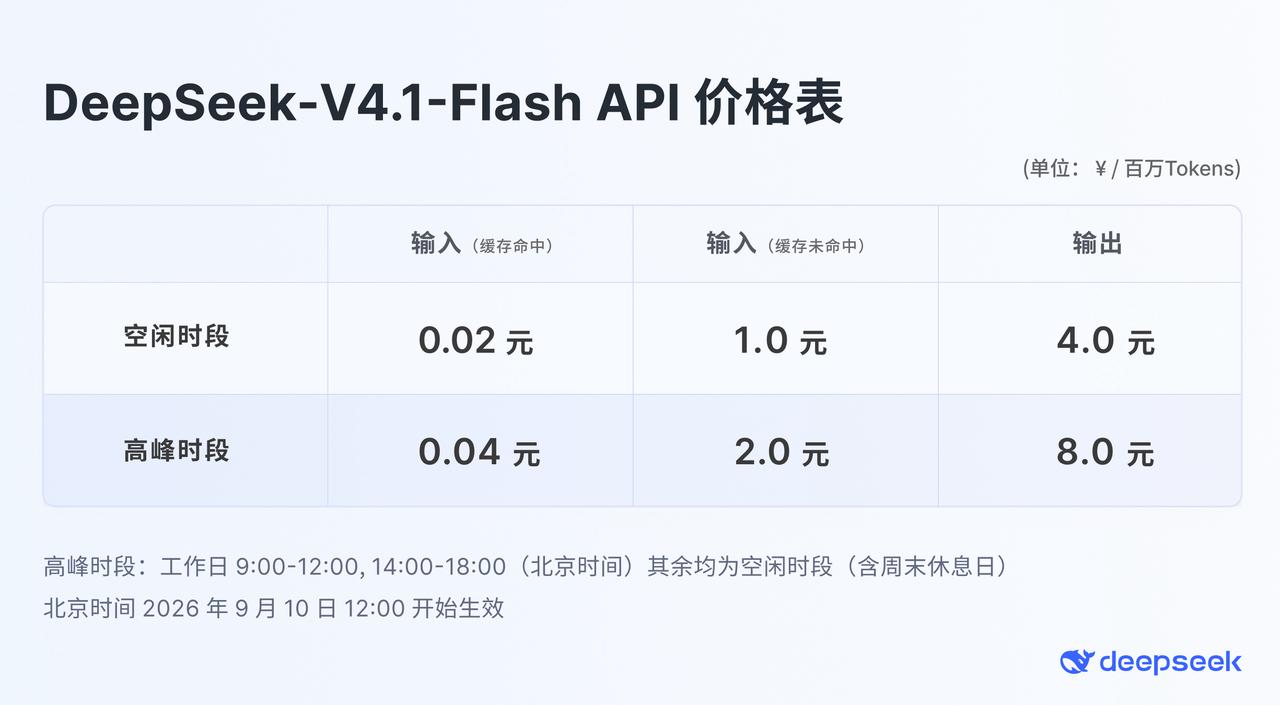
Nguồn: bài phát hành chính thức của DeepSeek, ảnh giữ nguyên. Giá có thể thay đổi; nhà cung cấp bên thứ ba tính phí riêng.
Ví dụ hóa đơn Agent có thể tự tính
Giả sử một lô tác vụ dùng 8 triệu input Tokens cache hit, 2 triệu input Tokens cache miss và 0,5 triệu output Tokens, tất cả tính trong cùng một khung giờ:
Tổng phí = số triệu input hit × đơn giá hit
         + số triệu input miss × đơn giá miss
         + số triệu output × đơn giá output

Ngoài giờ cao điểm: 8 × 0.02 + 2 × 1 + 0.5 × 4 = 4.16 nhân dân tệ
Giờ cao điểm:       8 × 0.04 + 2 × 2 + 0.5 × 8 = 8.32 nhân dân tệ
Hai đơn giá input chênh nhau 50 lần, nhưng không có nghĩa toàn bộ tác vụ rẻ hơn 50 lần. Trong ví dụ, phần input cache hit chỉ tốn 0,16 nhân dân tệ; input miss và output mỗi phần tốn 2 nhân dân tệ. Tối ưu cần xem cả việc gọi công cụ lặp lại, output quá dài và retry.
KV Cache nhỏ hơn: vì sao quan trọng với hội thoại dài?
KV Cache lưu kết quả tính toán trung gian của context. Với Agent nhiều lần đọc cùng codebase, system instructions và lịch sử hội thoại, tái sử dụng prefix giống nhau giúp giảm tính toán lặp. V4.1 Flash nén global KV Cache xuống 890 bytes / Token, khoảng một phần tư V4 Flash. Mô tả kiến trúc chính thức
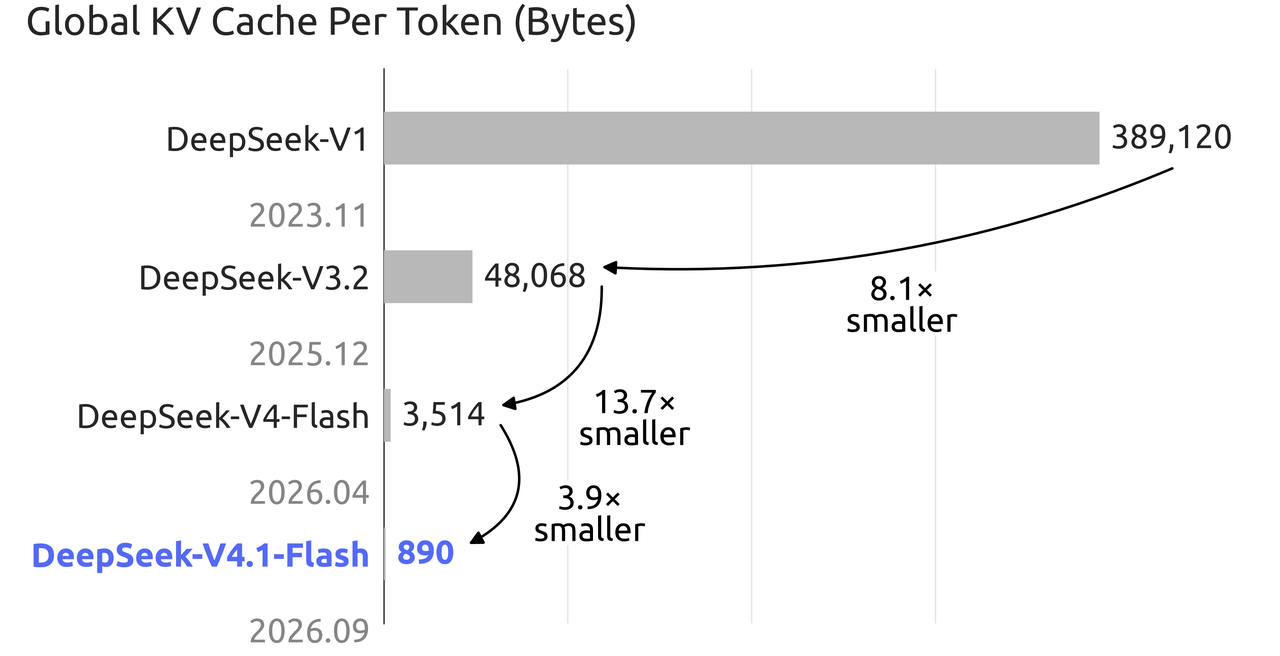
Nguồn: bài phát hành chính thức của DeepSeek, ảnh giữ nguyên. Biểu đồ so sánh global KV Cache trên mỗi Token, không phải tổng VRAM khi triển khai model.
Cần phân biệt hai cách đo lưu trữ: tài liệu chính thức cho biết nhu cầu HBM cho cache giảm còn khoảng 1/4, SSD còn khoảng 1/8. Đây là tài nguyên cache, không phải toàn bộ trọng số, RAM chạy hoặc cluster triển khai đều giảm theo cùng tỷ lệ.
Với bên tích hợp, hãy giữ prefix có thể tái sử dụng ổn định, tránh thêm timestamp thay đổi, ID ngẫu nhiên hoặc danh sách công cụ bị sắp xếp lại vào prefix ở mỗi vòng. Sau đó kiểm tra tỷ lệ hit bằng trường usage thực tế. Đừng chỉ dựa vào cảm giác “nội dung gần giống nhau” để suy đoán cache hit.
Gọi DeepSeek V4.1 Flash API như thế nào?
Tích hợp mới nên dùng tên chính thức deepseek-flash. Đây là ví dụ gọi Chat Completions API trực tiếp; trước tiên đặt DEEPSEEK_API_KEY trong terminal. Ví dụ chưa được xác minh bằng một lượt gọi trả phí trên trang này.
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {
        "role": "user",
        "content": "Hãy liệt kê các bước triển khai, trường hợp biên và phương pháp nghiệm thu cho công cụ đổi tên hàng loạt tệp Markdown."
      }
    ],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "high",
    "max_tokens": 2048,
    "stream": false
  }'
JSON trả về dự kiến có nội dung trả lời tại choices[0].message.content. Khi kiểm tra, hãy xem HTTP status, nội dung trả về và usage; chỉ gửi được request chưa đủ để xác nhận thành công. Hướng dẫn gọi lần đầu chính thức
Vision gốc nghĩa là model hiểu hình ảnh, không phải tạo ảnh. Khi xử lý screenshot, hãy thêm image content block theo hướng dẫn image understanding chính thức. Một request văn bản thành công không thay thế việc kiểm tra riêng image input, tool call và streaming.
Nếu dùng gateway bên thứ ba, cần đối chiếu Base URL, model ID, phương thức xác thực và hỗ trợ giao thức. Không thể chỉ đổi địa chỉ chính thức rồi mặc định mọi tính năng và cách tính phí giống nhau.
Model cũ còn dùng được không? V4 Pro chuyển đổi khi nào?
| Model name bạn đang cấu hình | Cách xử lý chính thức |
|---|---|
deepseek-flash |
Tên khuyến nghị cho tích hợp mới, gọi V4.1 Flash |
deepseek-v4-flash |
Model cũ đã ngừng; tên tạm thời tương thích và được route tới V4.1 Flash |
deepseek-v4-flash-vision-exp |
Model cũ đã ngừng; tên tạm thời tương thích và được route tới V4.1 Flash |
deepseek-v4-pro |
Sau 12:00 ngày 14/09/2026 theo giờ Bắc Kinh và trước khi V4.1 Pro ra mắt, toàn bộ route tới V4.1 Flash và tính theo giá Flash mới |
Đây là lịch xử lý API chính thức của DeepSeek; gateway bên thứ ba có thể dùng alias và lịch chuyển đổi khác. Giữ tên cũ không có nghĩa giữ model cũ, cũng không phải phương án quay về trọng số cũ.
Có thể chuyển đổi theo ba bước: xuất model name và các request mẫu hiện tại; dùng tên mới kiểm tra văn bản, hình ảnh, công cụ và cache usage; cuối cùng cập nhật model mặc định, template tác vụ và hóa đơn. Với tác vụ cần tái lập chính xác, hãy lưu ngày gọi, nhà cung cấp thực tế và response thay vì chỉ lưu alias cũ.
DeepSeek Harness v0.1.5 có gì mới?
Model phụ trách hiểu và suy luận; Harness kết nối file, lệnh và công cụ để biến output của model thành tác vụ có thể thực thi. Cùng đợt phát hành này, DeepSeek Harness lên v0.1.5, thích ứng với standard mode, Programmatic Tool Calling (PTC) và minimal mode.
Theo tài liệu phát hành, phiên bản mới hỗ trợ upload hình ảnh/PDF, cây file workspace và preview artifact; cải thiện khôi phục hội thoại dài và điều hướng; tăng cường giao tiếp hai chiều parent/child Agent, queued message và can thiệp tác vụ. Agent Teams thử nghiệm có thể chia việc bằng task list chung, nhưng mặc định tắt và khi bật phải tính thêm Token.
Máy đã cài Node.js có thể chạy theo repository chính thức:
npx @deepseek-ai/dsh web
Sau khi chạy, nhập DeepSeek API Key trong giao diện Web, chọn workspace rồi gửi tác vụ. Lệnh này lấy phiên bản package tại thời điểm thực thi, không cố định v0.1.5; nếu cần tái lập môi trường lịch sử, hãy ghi lại version thực tế.
Bắt đầu bằng một tác vụ nhỏ có thể nghiệm thu:
Read the current workspace project notes and create a Markdown getting-started guide.
Include startup commands, required configuration, and one minimal validation step.
Only add docs/getting-started-draft.md; do not change business code.
After completion, check whether the paths in the document exist and list anything that could not be confirmed.
Kết quả cần là một file Markdown mở được, không chỉ là câu “đã hoàn thành” trong chat. Hãy kiểm tra file thật sự được tạo, đường dẫn đúng và lệnh khởi động có nguồn, sau đó mới mở rộng tác vụ. Có thể tham khảo thêm tutorial tích hợp.
Có thể triển khai model mã nguồn mở trên máy tính thông thường không?
Không thể suy ra “chỉ kích hoạt 8B khi input” đồng nghĩa với “phần cứng cấp 8B là đủ”. Backbone V4.1 Flash vẫn có 552B; triển khai thực tế còn phụ thuộc độ chính xác trọng số, runtime, cache, concurrency và storage.
Model và trọng số dùng giấy phép MIT, xem tại repository model chính thức và báo cáo kỹ thuật. Thông cáo đề cập hợp tác triển khai quy mô lớn cho đội ngũ có khoảng 2.000 GPU và storage cluster; đây là điều kiện hợp tác, không phải cấu hình tối thiểu được công bố.
Nếu mục tiêu chính là xây ứng dụng, chạy Agent hoặc đo hiệu quả kinh doanh, thường nên dùng API để thu thập dữ liệu chất lượng và chi phí của chính mình trước, rồi mới đánh giá self-hosting.
Câu hỏi thường gặp
DeepSeek V4.1 Flash là 550B hay 552B?
Trang phát hành và model card chính thức dùng 552B, chỉ quy mô backbone. 550B là cách làm tròn trong một số bài viết; khi lập bảng thông số hoặc đánh giá triển khai, nên dùng 552B.
API model ID của V4.1 Flash là gì?
DeepSeek khuyến nghị chính thức deepseek-flash. Không tự ghép thành deepseek-v4.1-flash; một alias của nền tảng bên thứ ba không có nghĩa đó là tên API chính thức.
0,02 nhân dân tệ có mua được 1 triệu Token bất kỳ không?
Không. 0,02 nhân dân tệ / triệu Tokens chỉ dành cho input cache hit ngoài giờ cao điểm. Input cache miss, output và giờ cao điểm có đơn giá khác.
V4.1 Flash hỗ trợ hiểu ảnh và tạo ảnh không?
Model nhận văn bản và hình ảnh rồi sinh văn bản, phù hợp để hiểu screenshot và phân tích biểu đồ. Model card chính thức không định nghĩa nó là model tạo ảnh.
V4 Pro đã ngừng hoàn toàn chưa?
Tại ngày phát hành bài, 10/09/2026, DeepSeek mới công bố lịch chuyển sau 12:00 ngày 14/09; không nên viết trước rằng đã chuyển hoàn toàn. Hai model Flash cũ đã ngừng, còn tên cũ tạm thời tương thích.
Gọi qua trang này có tính đúng giá cao điểm/ngoài giờ của DeepSeek không?
Không nên suy ra như vậy. Bảng giá là cho API trực tiếp của DeepSeek; model ID, khả dụng và phí của trang này căn cứ giá model theo thời gian thực và hóa đơn thực tế. Sau khi xác nhận model, có thể bắt đầu kiểm tra nhỏ tại trang mua.
Kết luận: tính tổng chi phí tác vụ trước, rồi xem thời điểm chuyển đổi
DeepSeek V4.1 Flash kết hợp vision gốc, tính toán bất đối xứng và cache context gọn hơn. Với Agent có input dài và nhiều vòng gọi công cụ, đây là bản cập nhật nên được kiểm tra bằng tác vụ thực. Với ứng dụng API hiện có, việc cấp thiết là xác nhận routing của alias cũ và thời điểm chuyển Pro ngày 14/09.
Thứ tự thực tế là: xác nhận model ID → nghiệm thu bằng tác vụ của mình → đối chiếu cache và output billing → cập nhật cấu hình. Nhờ đó, một thông báo model mới có thể trở thành nâng cấp ứng dụng đo lường được.
Nguồn tham khảo
- Trang phát hành DeepSeek V4.1 Flash: ngày phát hành, kiến trúc 552B, thời điểm áp dụng giá và lịch chuyển.
- Model card chính thức DeepSeek V4.1 Flash: CED, bảng đánh giá, môi trường test, KV Cache và MIT.
- Model và giá chính thức của DeepSeek: đơn giá RMB theo cao điểm, context và output limit.
- Hướng dẫn gọi lần đầu chính thức: model ID, request mẫu và tên tương thích.
- Hướng dẫn image understanding chính thức: khả năng image input và định dạng.
- Repository DeepSeek Harness: cách khởi động và trạng thái developer preview.
- Tài liệu bổ sung: bài WeChat 1, bài WeChat 2. Phần Harness v0.1.5 được biên soạn từ nội dung phát hành đi kèm.
Ngày đối chiếu tài liệu: 10/09/2026. Đây là bài giải thích thông tin phát hành và hướng dẫn tích hợp, không phải bài đánh giá hiệu năng độc lập.