DeepSeek V4.1 Flash公開:552B構造、API料金、移行ガイド
DeepSeek V4.1 Flashは2026年9月10日に公開され、重みも公開されました。公式API名は deepseek-flash です。 テキストと画像を入力でき、出力はテキストです。新しい非対称構造を採用し、バックボーンは 552B、入力処理ではトークンあたり約 8B、出力生成では約 16B のパラメータを有効化します。詳細は公式リリースを参照してください。
今回の更新で開発者が見るべき点は、Agentタスク性能の改善、長い会話でのキャッシュコスト低下、そして旧モデル名のルーティング変更です。特に deepseek-v4-pro は、DeepSeekが 2026年9月14日12:00(北京時間) 以降、将来のV4.1 Pro公開までV4.1 Flashへルーティングすると告知しています。
この記事の画像はDeepSeek公式リリースの原図です。ベンチマーク値はメーカー公表値であり、当サイトによる独立再測定ではありません。
DeepSeek V4.1 Flashの主要仕様
| 項目 | 公開情報 |
|---|---|
| 公開日 | 2026年9月10日 |
| 公式APIモデル名 | deepseek-flash |
| モデル種別 | ネイティブマルチモーダルMoE。テキスト/画像入力、テキスト出力 |
| バックボーン規模 | 552Bパラメータ |
| 入力/出力の有効パラメータ | 8B / 16B |
| 中核構造 | Causal Encoder-Decoder(CED) |
| コンテキスト長 | 1M tokens |
| API最大出力 | 384K tokens |
| グローバルKV Cache | 890 bytes/token。前世代V4 Flashの約4分の1 |
| 重みとリポジトリのライセンス | MIT |
パラメータと構造は公式モデルカードを基準にしてください。コンテキスト、出力上限、API機能は公式料金・仕様ページで確認します。一部の記事では約550Bと丸められていますが、この記事では公式の 552B を採用します。
当サイト経由で利用する場合は、まずリアルタイム料金ページを確認してください。DeepSeek公式APIの公開と第三者ゲートウェイの同期は別物です。設定では現在のカタログに表示される実際のモデルID、応答、課金記録を基準にします。
552B、8B、16Bは何を意味するのか
MoEモデルは、すべてのトークンで全パラメータを使うわけではありません。552Bはバックボーン規模、8Bと16Bは各計算段階でトークンごとに有効になる規模です。3つを同じ意味の「モデルサイズ」として扱うべきではありません。
V4.1 FlashのCEDバックボーンは40層で、20層の因果エンコーダと20層のデコーダから成ります。モデルカードによると、デコーダのグローバルKV Cacheは各デコーダ層から個別に作られるのではなく、エンコーダ最終隠れ状態から射影されます。これにより入力処理と出力生成で異なる計算規模を使えます。
コードベース分析、長文資料の読解、多段ツール呼び出しのように「入力が多く、同じ文脈を何度も読む」タスクでは、この設計は入力処理の負担を下げます。ただし、有効パラメータ数だけで品質を判断できるわけではなく、自己ホスト時に8B分だけ読み込めばよいという意味でもありません。
Agentベンチマーク:V4 Proとの比較
以下は公式モデルカードの比較表を整理したものです。差分は絶対スコア差であり、相対パーセントではありません。
| 評価 | V4 Pro | V4.1 Flash | 差分 |
|---|---|---|---|
| DeepSWE v1.1 | 62.7 | 74.2 | +11.5 |
| Terminal-Bench 3.0 | 11.8 | 30.0 | +18.2 |
| AutomationBench | 43.2 | 54.8 | +11.6 |
| CyberGym | 83.3 | 88.1 | +4.8 |
| GPQA Diamond | 92.4 | 90.9 | −1.5 |
前半4項目は、コード、ターミナル、自動化タスクでV4.1 Flashが前世代Proを上回ることを示しています。一方でGPQA DiamondはV4 Proより低いため、正確には Agent能力は大きく伸びたが、すべての能力で全面的に上回るわけではない という評価になります。公式評価表と条件
実行条件も重要です。公式Instruct比較は高い推論強度、temperature=1.0、top_p=0.95 を使っています。DeepSWE v1.1の74.2はmini-SWE環境の値で、同一モデルでもDSH Minimalでは72.6です。モデル版、タスクセット、Agentフレームワーク、推論予算が結果を左右します。
選定時は、自社タスクから3種類を抜き出すと実用的です。既存テストがあるコード修正、複数コマンドが必要なターミナル作業、スクリーンショットや図表を含む資料タスクです。完了率、所要時間、請求額を比較する方が、単一ランキングより実運用に近くなります。
API料金:オフピーク入力1元、出力4元 / 100万Token
料金は 2026年9月10日12:00(北京時間) に発効しました。以下はDeepSeek公式直 API の人民元価格で、単位は 元 / 100万tokens です。当サイトのゲートウェイ価格ではありません。出典は公式料金ページです。
| 課金項目 | オフピーク | ピーク |
|---|---|---|
| 入力:キャッシュヒット | ¥0.02 | ¥0.04 |
| 入力:キャッシュミス | ¥1.00 | ¥2.00 |
| 出力 | ¥4.00 | ¥8.00 |
ピーク時間は 北京時間の月曜〜金曜 09:00—12:00、14:00—18:00 です。それ以外は週末を含めてオフピークです。祝日振替などを推測せず、この明示された時間帯で判断します。
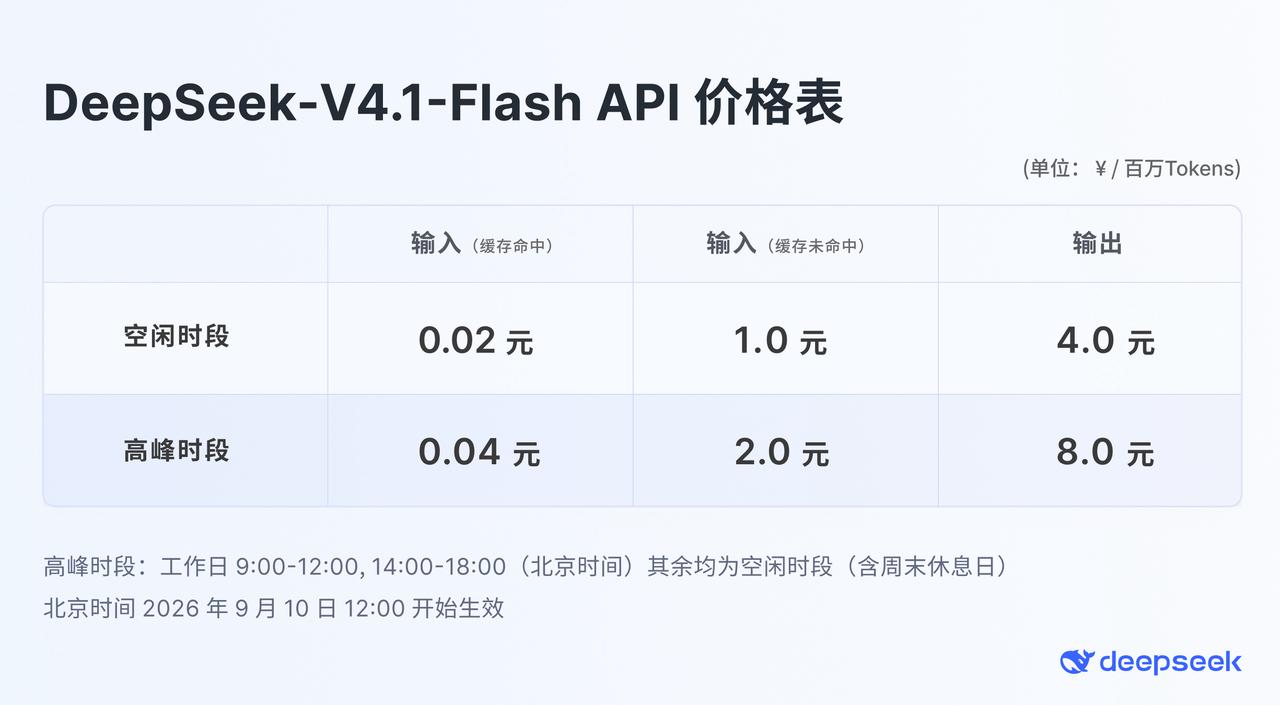
画像出典:DeepSeek公式リリース。原図は未加工です。価格は変更される可能性があり、第三者サービスは独自に課金します。
再計算できるAgent請求例
あるタスク群で、キャッシュヒット入力800万tokens、キャッシュミス入力200万tokens、出力50万tokensを使い、すべて同じ時間帯で課金されたとします。
総費用 = ヒット入力の百万数 × ヒット単価
       + ミス入力の百万数 × ミス単価
       + 出力の百万数 × 出力単価

オフピーク:8 × 0.02 + 2 × 1 + 0.5 × 4 = 4.16元
ピーク:    8 × 0.04 + 2 × 2 + 0.5 × 8 = 8.32元
入力単価は確かに50倍違いますが、タスク全体が50分の1になるわけではありません。この例ではオフピークのキャッシュヒット入力は0.16元だけですが、ミス入力と出力はそれぞれ2元です。キャッシュだけでなく、ツール呼び出しの繰り返し、出力量、再試行も見る必要があります。
KV Cache縮小が長い会話で重要な理由
KV Cacheは文脈の中間計算結果を保存します。同じコードベース、システム説明、過去対話を繰り返し読むAgentでは、同じプレフィックスの再利用が重複計算を減らします。DeepSeekはV4.1 FlashのグローバルKV Cacheを 890 bytes/token に圧縮し、V4 Flashの約4分の1にしたと説明しています。公式モデルカードの構造説明
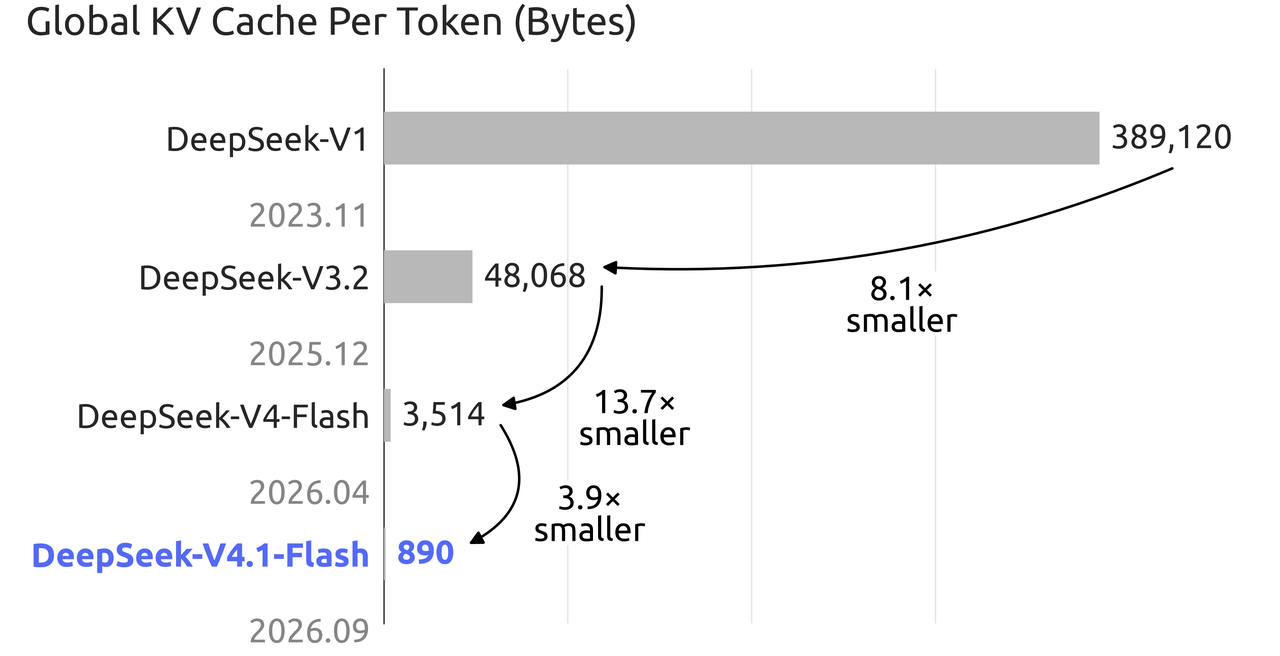
画像出典:DeepSeek公式リリース。比較しているのはトークンごとのグローバルKV Cacheであり、総デプロイメモリではありません。
保存領域の意味も分けて考える必要があります。公式はキャッシュ関連の HBM需要が約1/4、SSD需要が約1/8 になると説明しています。これはキャッシュ資源の話であり、モデル重み、全ランタイムメモリ、デプロイクラスタ全体が同じ比率で小さくなるという意味ではありません。
接続側では、再利用可能な資料プレフィックスを安定させることが先です。毎回変わる時刻、ランダムID、並び替えられたツール一覧をプレフィックスに入れないようにします。そのうえで実際の usage を見てヒットを確認します。「内容が似ている」だけではキャッシュヒットとは言えません。
DeepSeek V4.1 Flash APIの呼び出し方
新規接続では公式モデル名 deepseek-flash を使います。以下はDeepSeek直APIのChat Completions例です。実行前に端末で DEEPSEEK_API_KEY を設定してください。この例は当サイト経由の有料呼び出しとして検証したものではありません。
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {
        "role": "user",
        "content": "Markdownファイル一括リネームツールの実装手順、境界条件、受け入れ基準を列挙してください。"
      }
    ],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "high",
    "max_tokens": 2048,
    "stream": false
  }'
返却はJSONで、回答本文は choices[0].message.content にあります。検証ではHTTPステータス、返却内容、usage を同時に確認してください。リクエストが送信できたことだけでは不十分です。公式の初回呼び出しガイド
ネイティブ画像対応とは、画像を理解できるという意味であり、画像生成ではありません。スクリーンショットを扱う場合は、公式画像理解ガイドに従ってメッセージへ画像ブロックを追加します。テキストだけの成功は、画像入力、ツール呼び出し、ストリーミングの検証を代替しません。
第三者ゲートウェイを使う場合は、Base URL、モデルID、認証方式、対応プロトコルをまとめて確認してください。公式URLだけを差し替えても、機能や課金が同じとは限りません。
旧モデル名は使えるのか
| 現在のモデル名 | 公式の扱い |
|---|---|
deepseek-flash |
新規接続の推奨名。V4.1 Flashを呼び出す |
deepseek-v4-flash |
旧モデルは終了。名称は一時互換としてV4.1 Flashへルーティング |
deepseek-v4-flash-vision-exp |
旧モデルは終了。名称は一時互換としてV4.1 Flashへルーティング |
deepseek-v4-pro |
北京時間2026-09-14 12:00以降、将来のV4.1 Pro公開までV4.1 Flashへルーティングし、新Flash料金で課金 |
これはDeepSeek公式APIの案内です。第三者ゲートウェイでは別名や移行時期が異なる場合があります。旧名称を残しても旧モデルを固定できるわけではなく、旧重みに戻す手段にもなりません。
移行は3段階で進めると安全です。現在のモデル名と重要なリクエストサンプルをエクスポートし、新名称でテキスト、画像、ツール、キャッシュ利用を確認し、最後にクライアント既定モデル、タスクテンプレート、課金記録を更新します。厳密な再現性が必要なタスクでは、呼び出し日、実際のプロバイダ、応答メタデータも記録します。
DeepSeek Harness v0.1.5の更新点
モデルは理解と推論を担当し、Harnessはファイル、コマンド、ツールを接続して、モデル出力を実行可能な作業に変えます。今回の公開に合わせてDeepSeek Harnessはv0.1.5へ更新され、標準モード、プログラム的ツール呼び出し(PTC)モード、Minimalモードに適応しました。
リリース資料によると、新版は画像とPDFアップロード、ワークスペースのファイルツリー、成果物プレビュー、長い会話の復帰とナビゲーションを改善し、親子Agentの双方向通信、キュー済みメッセージ、タスク介入も強化しています。実験的なAgent Teamsは共有タスクリストで分業できますが、既定では無効で、有効化時は追加Token消費を見込む必要があります。
Node.jsが入っている環境では、公式リポジトリの説明に従って起動できます。
npx @deepseek-ai/dsh web
起動後、Web UIでDeepSeek API Keyを入力し、ワークスペースを選んでタスクを送ります。このコマンドは実行時点のパッケージを取得するため、v0.1.5を固定インストールするわけではありません。再現性が必要な場合は実際のバージョンを別途記録してください。
最初は検収しやすい小タスクから始めます。
現在のワークスペースのプロジェクト説明を読み、Markdownの入門ガイドを作成してください。
起動コマンド、必要な設定、最小検証手順を明記してください。
docs/getting-started-draft.mdだけを新規作成し、業務コードは変更しないでください。
完了後、文書内のパスが存在するか確認し、確認できなかった情報を列挙してください。
期待する成果は実際に開けるMarkdownファイルであり、チャット上の「完了しました」だけではありません。ファイル生成、パス、コマンドの根拠を確認してから範囲を広げます。クライアント設定は当サイトのチュートリアルも参照できます。
普通のPCで自己ホストできるのか
「入力で8Bだけ有効化する」ことから「8B級ハードウェアで動く」とは言えません。V4.1 Flashのバックボーンは依然として552Bであり、実際のデプロイは重み精度、ランタイム対応、キャッシュ、同時実行、ストレージ構成に左右されます。
モデル重みはMITライセンスです。入口は公式モデルリポジトリと技術レポートです。リリースは約2000枚GPUとストレージクラスタを持つチーム向けの大規模デプロイ協力に言及していますが、これは協力条件であり、公開された最低構成ではありません。
アプリ開発、Agent運用、業務効果検証が主目的なら、まずAPIで品質とコストのデータを取り、その後に自己ホストを評価する方が判断しやすくなります。
FAQ
DeepSeek V4.1 Flashは550Bですか、552Bですか?
公式リリースとモデルカードは552Bを使っています。550Bは一部の紹介記事での丸め表現です。仕様表やデプロイ評価では公式値を使ってください。
V4.1 FlashのAPIモデルIDは何ですか?
公式推奨は deepseek-flash です。表示名から deepseek-v4.1-flash と自分で作らないでください。第三者プラットフォームの別名は公式API名とは限りません。
0.02元で任意の100万Tokenを買えるのですか?
いいえ。0.02元 / 100万tokensは、オフピークのキャッシュヒット入力だけに適用されます。キャッシュミス入力、出力、ピーク時間は別料金です。
V4.1 Flashは画像理解と画像生成に対応しますか?
テキストと画像を入力し、テキストを生成します。スクリーンショット理解やグラフ分析には使えますが、モデルカードでは画像生成モデルとは定義されていません。
V4 Proはすでに完全終了していますか?
この記事の公開日である2026年9月10日時点では、公式が9月14日12:00以降の切替予定を発表した段階です。その時刻前に「すでに全面切替」と書くべきではありません。2つの旧Flashモデルは終了済みで、名称だけ一時互換です。
当サイトも公式のピーク/オフピーク料金で請求しますか?
そう推測してはいけません。上の表はDeepSeek公式直APIの価格です。当サイトのモデルID、可用性、課金はリアルタイム料金と実際の請求記録を基準にしてください。対象モデルを確認した後、購入ページから小額検証を始められます。
まとめ:移行前にタスク総コストを確認する
DeepSeek V4.1 Flashは、ネイティブ画像理解、非対称計算、より小さいコンテキストキャッシュを組み合わせています。長い入力と多段ツール呼び出しを使うAgentでは、実タスクで検証する価値があります。既存APIアプリでは、旧別名のルーティングと9月14日のV4 Pro切替時期を確認することが先です。
実務の順序は モデルIDを確認 → 自社タスクで検収 → キャッシュと出力の請求を確認 → 設定を更新 です。これでモデル発表を、測定できるアプリケーション更新に変えられます。
参考情報
- DeepSeek V4.1 Flash公式リリース:公開日、552B構造、料金発効時刻、移行案内。
- DeepSeek V4.1 Flash公式モデルカード:CED構造、評価表、テスト条件、KV Cache、MITライセンス。
- DeepSeek公式モデルと料金:人民元ピーク/オフピーク単価、コンテキスト、出力上限。
- DeepSeek公式初回呼び出しガイド:現在のモデルID、リクエスト例、互換名称。
- DeepSeek公式画像理解ガイド:画像入力能力と形式。
- DeepSeek Harness公式リポジトリ:起動方法と開発者プレビュー状態。
- 補足リリース資料:微信記事1、微信記事2。
資料確認日:2026年9月10日。本記事はリリース情報の解説と接続ガイドであり、独立性能評価ではありません。