DeepSeek V4.1 Flash เปิดน้ำหนักโมเดล: สถาปัตยกรรม 552B ราคา API และคู่มือย้ายระบบ
DeepSeek V4.1 Flash เปิดตัวเมื่อ 10 กันยายน 2026 และเปิดให้นำไปใช้กับน้ำหนักโมเดลได้ โดยชื่อที่ใช้เรียกผ่าน API อย่างเป็นทางการคือ deepseek-flash โมเดลรองรับอินพุตข้อความและรูปภาพแบบเนทีฟ และใช้โครงสร้างแบบไม่สมมาตรใหม่ โดย backbone มีพารามิเตอร์ 552B ขณะประมวลผลอินพุตจะเปิดใช้งานประมาณ 8B ต่อ Token และขณะสร้างเอาต์พุตจะเปิดใช้งานประมาณ 16B ต่อ Token ประกาศอย่างเป็นทางการ
สิ่งที่นักพัฒนาควรสนใจไม่ใช่แค่คะแนน benchmark ที่ดีขึ้น แต่มีสามเรื่องที่กระทบการเชื่อมต่อโดยตรง ได้แก่ ความสามารถด้าน Agent ที่ดีขึ้น ราคาค่า cache สำหรับบทสนทนายาวที่ลดลง และโมเดลจริงที่อยู่เบื้องหลังชื่อรุ่นเดิมมีการเปลี่ยนแปลง โดยเฉพาะ deepseek-v4-pro ซึ่งมีการประกาศแผนเปลี่ยนเส้นทางหลัง 14 กันยายน 2026 เวลา 12:00 ตามเวลาปักกิ่ง
ภาพประกอบในบทความนี้ใช้ภาพจากประกาศอย่างเป็นทางการของ DeepSeek โดยไม่แก้ไข ตัวเลข benchmark เป็นผลที่ผู้ให้บริการประกาศ ไม่ใช่การทดสอบซ้ำอย่างอิสระของเว็บไซต์นี้
DeepSeek V4.1 Flash คืออะไร? ดูสเปกหลักก่อน
| รายการ | ข้อมูลที่ประกาศ |
|---|---|
| วันที่เปิดตัว | 10 กันยายน 2026 |
| ชื่อโมเดล API อย่างเป็นทางการ | deepseek-flash |
| ประเภทโมเดล | MoE แบบมัลติโมดัลเนทีฟ รับข้อความและรูปภาพ สร้างข้อความ |
| ขนาด backbone | 552B หรือประมาณ 552 พันล้านพารามิเตอร์ |
| พารามิเตอร์ที่เปิดใช้งาน อินพุต / เอาต์พุต | 8B / 16B (prefill / decode) |
| โครงสร้างหลัก | Causal Encoder-Decoder หรือ CED |
| หน้าต่างบริบท | 1M Tokens |
| เอาต์พุต API สูงสุด | 384K Tokens |
| Global KV Cache | 890 bytes / Token หรือประมาณหนึ่งในสี่ของ V4 Flash |
| ใบอนุญาตน้ำหนักและ repository | MIT |
ให้ยึด model card อย่างเป็นทางการของ DeepSeek สำหรับพารามิเตอร์และโครงสร้าง และยึด หน้าสเปกราคา API อย่างเป็นทางการ สำหรับ context, output limit และฟังก์ชันอินเทอร์เฟซ บทความบางแห่งปัดขนาดเป็น 550B แต่บทความนี้ใช้ตัวเลขทางการคือ 552B
หากต้องการเชื่อมต่อผ่านเว็บไซต์นี้ ให้ดูราคาโมเดลแบบเรียลไทม์ก่อน ประกาศของผู้พัฒนาและการซิงค์ของ gateway ภายนอกเป็นคนละเรื่องกัน ให้ตั้งค่าตาม model ID ที่มีอยู่จริงในไดเรกทอรี ส่วนราคาและความพร้อมใช้งานของเว็บไซต์ให้ยึดไดเรกทอรีปัจจุบัน ผลการเรียกใช้งาน และใบแจ้งยอดจริง
552B, 8B และ 16B หมายถึงอะไร?
โมเดล MoE ไม่ได้เรียกใช้พารามิเตอร์ทั้งหมดสำหรับทุก Token 552B คือขนาดพารามิเตอร์ของ backbone ส่วน 8B และ 16B คือขนาดที่เปิดใช้งานต่อ Token ในขั้นตอนคำนวณที่เกี่ยวข้อง จึงไม่ควรนำไปมองเป็น “ขนาดโมเดล” สามแบบที่ใช้แทนกันได้
backbone แบบ CED ของ V4.1 Flash มี 40 เลเยอร์ แบ่งเป็น causal encoder 20 เลเยอร์และ decoder 20 เลเยอร์ ตาม model card ระบุว่า global KV Cache ของ decoder ได้มาจากการฉาย final hidden state ของ encoder ไม่ได้สร้างแยกจาก decoder แต่ละเลเยอร์ ทำให้การประมวลผลอินพุตและการสร้างเอาต์พุตใช้ขนาดการคำนวณต่างกันได้
สำหรับการวิเคราะห์ codebase การอ่านเอกสารยาว และการเรียกเครื่องมือหลายรอบ โครงสร้างนี้ช่วยลดภาระการประมวลผลอินพุต แต่ไม่ได้หมายความว่าคุณภาพของอินพุตและเอาต์พุตจะตัดสินได้จากพารามิเตอร์ที่เปิดใช้งานเท่านั้น และไม่ได้หมายความว่าการดาวน์โหลดหรือ deploy ต้องใช้เพียงน้ำหนักระดับ 8B
คะแนน Agent ดีขึ้นตรงไหน? เปรียบเทียบกับ V4 Pro
ตารางนี้ถอดจากตารางเปรียบเทียบใน model card อย่างเป็นทางการ คอลัมน์การเปลี่ยนแปลงคือส่วนต่างของคะแนน ไม่ใช่เปอร์เซ็นต์สัมพัทธ์
| การประเมิน | V4 Pro | V4.1 Flash | การเปลี่ยนแปลง |
|---|---|---|---|
| DeepSWE v1.1 | 62.7 | 74.2 | +11.5 |
| Terminal-Bench 3.0 | 11.8 | 30.0 | +18.2 |
| AutomationBench | 43.2 | 54.8 | +11.6 |
| CyberGym | 83.3 | 88.1 | +4.8 |
| GPQA Diamond | 92.4 | 90.9 | −1.5 |
สี่รายการแรกบอกว่า V4.1 Flash เหนือกว่า Pro รุ่นก่อนใน benchmark ด้านโค้ด เทอร์มินัล และงานอัตโนมัติหลายรายการ แต่ GPQA Diamond ยังต่ำกว่า V4 Pro ดังนั้นข้อสรุปที่แม่นยำกว่าคือ ความสามารถด้าน Agent ดีขึ้นอย่างชัดเจน ไม่ใช่ทุกความสามารถจะนำหน้าทั้งหมด ตารางและเงื่อนไขการทดสอบอย่างเป็นทางการ
สภาพแวดล้อมที่ใช้รันก็สำคัญเช่นกัน การเปรียบเทียบ Instruct ใน model card ใช้ระดับ reasoning สูงสุด temperature=1.0 และ top_p=0.95 ส่วนคะแนน 74.2 ของ DeepSWE v1.1 เป็นสภาพแวดล้อม mini-SWE ขณะที่โมเดลเดียวกันได้ 72.6 ใน DSH Minimal รุ่นโมเดล ชุดงาน Agent framework และงบ reasoning ล้วนมีผลต่อคะแนน
ตอนเลือกโมเดล ลองดึงตัวอย่างจากงานจริงสามแบบ ได้แก่ การแก้โค้ดที่มี test อยู่แล้ว งานเทอร์มินัลที่ต้องใช้หลายคำสั่ง และงานเอกสารที่มีภาพหน้าจอหรือกราฟ เปรียบเทียบอัตราทำงานสำเร็จ เวลารวม และค่าใช้จ่าย จะใกล้เคียงประโยชน์จริงกว่าการดูคะแนน leaderboard เพียงรายการเดียว
ราคา API: อินพุต 1 หยวน เอาต์พุต 4 หยวน / ล้าน Token ในช่วงนอกพีก
ราคานี้มีผลตั้งแต่ 10 กันยายน 2026 เวลา 12:00 ตามเวลาปักกิ่ง ตารางต่อไปนี้เป็นราคาตรงอย่างเป็นทางการของ DeepSeek ในสกุล RMB หน่วยเป็น หยวน / ล้าน Tokens ไม่ใช่ราคาของ gateway เว็บไซต์นี้ หน้าราคาอย่างเป็นทางการ
| รายการคิดเงิน | ช่วงนอกพีก | ช่วงพีก |
|---|---|---|
| อินพุต: cache hit | ¥0.02 | ¥0.04 |
| อินพุต: cache miss | ¥1.00 | ¥2.00 |
| เอาต์พุต | ¥4.00 | ¥8.00 |
ช่วงพีกคือ วันจันทร์ถึงศุกร์ 09:00—12:00 และ 14:00—18:00 ตามเวลาปักกิ่ง เวลาที่เหลือ รวมถึงวันหยุดสุดสัปดาห์ เป็นช่วงนอกพีก ควรยึดช่วงเวลานี้โดยตรง ไม่ควรนำตารางวันทำงานที่ปรับตามวันหยุดมาใช้เอง
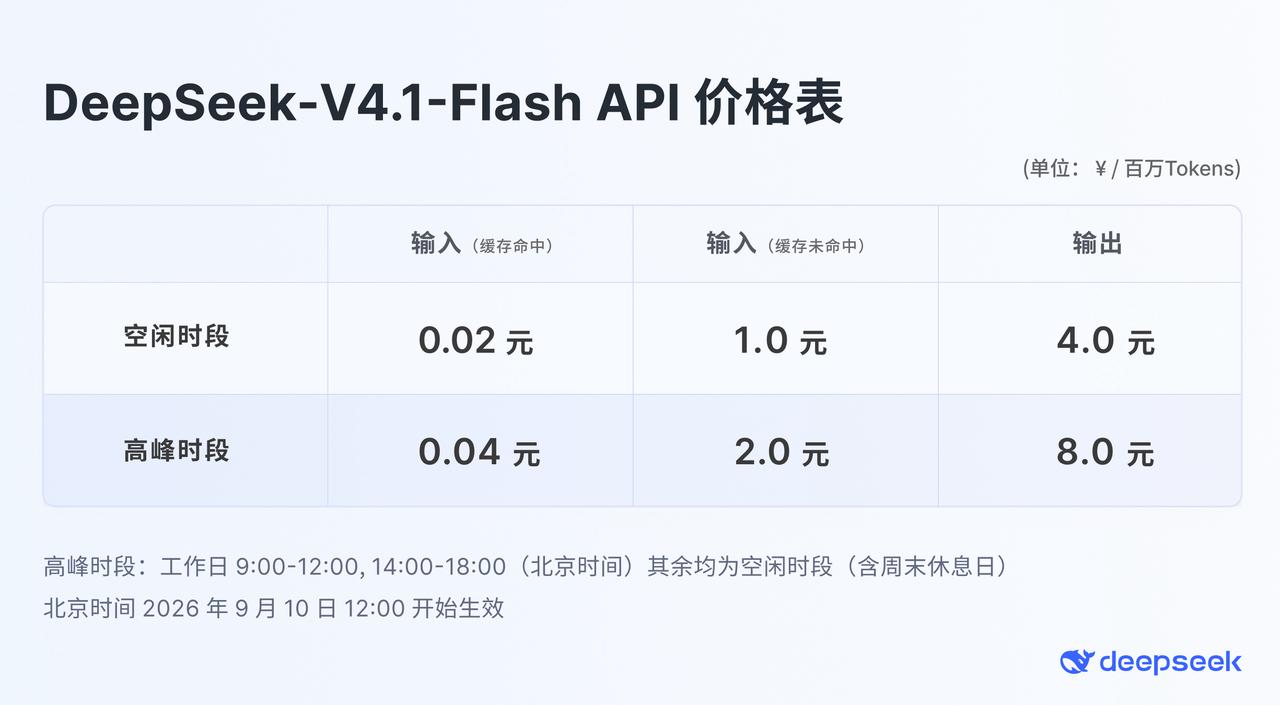
แหล่งที่มา: ประกาศอย่างเป็นทางการของ DeepSeek ภาพต้นฉบับไม่มีการแก้ไข ราคาอาจเปลี่ยนแปลงได้ ผู้ให้บริการภายนอกคิดเงินแยกต่างหาก
ตัวอย่างบิล Agent ที่คำนวณซ้ำได้
สมมติว่างานหนึ่งชุดใช้ cache-hit input 8 ล้าน Tokens, cache-miss input 2 ล้าน Tokens และ output 0.5 ล้าน Tokens โดยคิดเงินในช่วงเวลาเดียวกันทั้งหมด:
ค่าใช้จ่ายรวม = จำนวนล้านของ input hit × ราคาต่อหน่วย hit
              + จำนวนล้านของ input miss × ราคาต่อหน่วย miss
              + จำนวนล้านของ output × ราคาต่อหน่วย output

ช่วงนอกพีก: 8 × 0.02 + 2 × 1 + 0.5 × 4 = 4.16 หยวน
ช่วงพีก:     8 × 0.04 + 2 × 2 + 0.5 × 8 = 8.32 หยวน
ราคาของอินพุตสองแบบต่างกัน 50 เท่าจริง แต่ ไม่ได้หมายความว่างานทั้งหมดจะถูกลง 50 เท่า ในตัวอย่าง ส่วน cache-hit input ใช้เพียง 0.16 หยวน ขณะที่ miss input และ output ใช้ส่วนละ 2 หยวน การ optimize จึงต้องดูทั้ง cache การเรียกเครื่องมือซ้ำ เอาต์พุตที่ยาวเกินไป และการ retry
KV Cache เล็กลง ทำไมสำคัญต่อเซสชันยาว?
KV Cache เก็บผลคำนวณกลางของบริบท สำหรับ Agent ที่อ่าน codebase เดิม system instructions และประวัติการสนทนาซ้ำ การใช้ prefix เดิมช่วยลดการคำนวณซ้ำ V4.1 Flash ลด global KV Cache เหลือ 890 bytes / Token หรือประมาณหนึ่งในสี่ของ V4 Flash คำอธิบายสถาปัตยกรรมอย่างเป็นทางการ
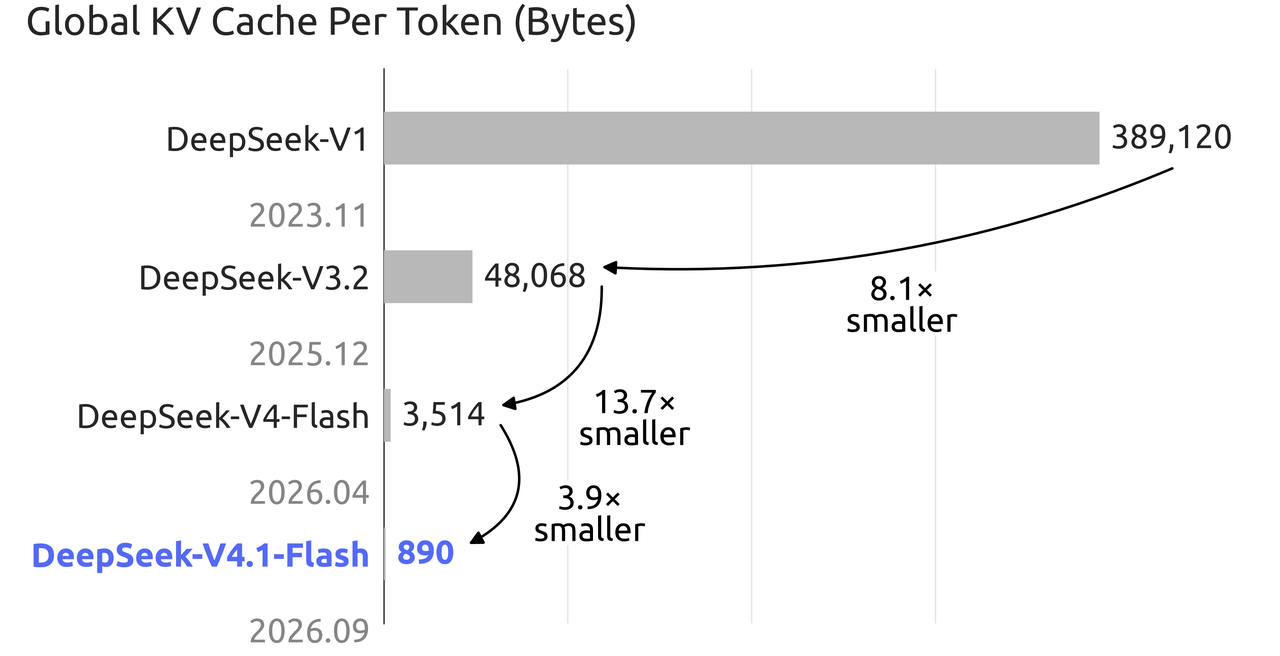
แหล่งที่มา: ประกาศอย่างเป็นทางการของ DeepSeek ภาพต้นฉบับไม่มีการแก้ไข กราฟเปรียบเทียบ global KV Cache ต่อ Token ไม่ใช่ VRAM รวมสำหรับ deploy โมเดล
ต้องแยกตัวเลขการจัดเก็บสองแบบให้ชัดเจน เอกสารทางการระบุว่าความต้องการ HBM สำหรับ cache ลดลงเหลือประมาณ 1/4 และ SSD ประมาณ 1/8 ตัวเลขนี้หมายถึงทรัพยากร cache ไม่ใช่น้ำหนักโมเดล หน่วยความจำทั้งหมด หรือคลัสเตอร์ deploy ที่ลดตามสัดส่วนเดียวกัน
สำหรับผู้เชื่อมต่อระบบ ควรรักษา prefix ที่นำกลับมาใช้ซ้ำให้คงที่ หลีกเลี่ยงการใส่ timestamp ที่เปลี่ยนไป รหัสสุ่ม หรือรายการเครื่องมือที่เรียงใหม่ใน prefix ทุกครั้ง จากนั้นตรวจสอบ hit จากฟิลด์ usage จริง อย่าคาดว่าเป็น cache hit เพียงเพราะ “เนื้อหาใกล้เคียงกัน”
เรียก DeepSeek V4.1 Flash API อย่างไร?
การเชื่อมต่อใหม่ควรใช้ชื่ออย่างเป็นทางการ deepseek-flash ตัวอย่างต่อไปนี้เป็นการเรียก Chat Completions API โดยตรง ก่อนรันให้ตั้งค่า DEEPSEEK_API_KEY ใน terminal ตัวอย่างนี้ยังไม่ได้ผ่านการเรียกเก็บเงินจริงจากเว็บไซต์นี้
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {
        "role": "user",
        "content": "ช่วยแจกแจงขั้นตอนการทำงาน กรณีขอบ และวิธีตรวจรับสำหรับเครื่องมือเปลี่ยนชื่อไฟล์ Markdown แบบชุด"
      }
    ],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "high",
    "max_tokens": 2048,
    "stream": false
  }'
JSON ที่คาดว่าจะได้รับมีข้อความตอบกลับอยู่ที่ choices[0].message.content เมื่อตรวจสอบควรดู HTTP status เนื้อหาที่ตอบกลับ และ usage อย่าดูเพียงว่าคำขอถูกส่งออกไปแล้ว คู่มือการเรียกครั้งแรกอย่างเป็นทางการ
Vision แบบเนทีฟหมายถึงโมเดลเข้าใจภาพ ไม่ใช่สร้างภาพ เมื่อต้องประมวลผลภาพหน้าจอ ให้ใส่ image content block ตามคู่มือ image understanding อย่างเป็นทางการ คำขอข้อความที่สำเร็จไม่สามารถแทนการตรวจสอบ image input, tool call และ streaming แยกกันได้
หากเรียกผ่าน gateway ภายนอก ให้ตรวจสอบ Base URL, model ID, วิธีรับรองตัวตน และการรองรับ protocol ร่วมกัน การเปลี่ยนเพียงที่อยู่ API ทางการไม่ได้รับประกันว่าความสามารถและการคิดเงินจะเหมือนเดิม
โมเดลเดิมยังใช้ได้หรือไม่? V4 Pro จะเปลี่ยนเมื่อไร?
| ชื่อโมเดลที่ตั้งค่าอยู่ | การจัดการอย่างเป็นทางการ |
|---|---|
deepseek-flash |
ชื่อแนะนำสำหรับการเชื่อมต่อใหม่ เรียก V4.1 Flash |
deepseek-v4-flash |
โมเดลเก่าถูกยุติแล้ว ชื่อยังเข้ากันได้ชั่วคราวและ route ไป V4.1 Flash |
deepseek-v4-flash-vision-exp |
โมเดลเก่าถูกยุติแล้ว ชื่อยังเข้ากันได้ชั่วคราวและ route ไป V4.1 Flash |
deepseek-v4-pro |
หลัง 14/09/2026 เวลา 12:00 ตามเวลาปักกิ่ง และก่อน V4.1 Pro รุ่นถัดไปเปิดตัว จะ route ทั้งหมดไป V4.1 Flash และคิดตามราคา Flash ใหม่ |
นี่คือ แผนการจัดการ API อย่างเป็นทางการของ DeepSeek gateway ภายนอกอาจใช้ alias หรือกำหนดการย้ายต่างกัน การเก็บชื่อเดิมไม่ได้หมายความว่าจะตรึงโมเดลเดิมไว้ และไม่ใช่วิธีย้อนกลับไปใช้น้ำหนักเก่า
การย้ายระบบทำได้สามขั้นตอน: export model name และ request ตัวอย่างสำคัญในปัจจุบัน จากนั้นใช้ชื่อใหม่ตรวจข้อความ รูปภาพ เครื่องมือ และ cache usage สุดท้ายอัปเดต model เริ่มต้น template งาน และใบแจ้งยอด หากงานต้องทำซ้ำได้อย่างเคร่งครัด ให้บันทึกวันที่เรียก ผู้ให้บริการจริง และผลตอบกลับ ไม่ใช่แค่ alias เดิม
DeepSeek Harness v0.1.5 มีอะไรใหม่?
โมเดลรับผิดชอบการเข้าใจและ reasoning ส่วน Harness เชื่อมไฟล์ คำสั่ง และเครื่องมือเข้าด้วยกันเพื่อเปลี่ยน output ของโมเดลให้เป็นงานที่รันได้ พร้อมกับการเปิดตัวโมเดล DeepSeek Harness อัปเดตเป็น v0.1.5 และปรับให้เข้ากับ standard mode, Programmatic Tool Calling (PTC) และ minimal mode
ตามเอกสารเปิดตัว รุ่นใหม่รองรับการอัปโหลดรูปภาพและ PDF, file tree ของ workspace และการ preview artifact ปรับปรุงการกู้คืนเซสชันยาวและการนำทาง รวมถึงเพิ่มการสื่อสารสองทางของ parent/child Agent, queued message และการแทรกแซงงาน Agent Teams แบบทดลองแบ่งงานผ่าน task list ร่วมได้ แต่ปิดไว้เป็นค่าเริ่มต้น และเมื่อเปิดใช้ต้องนับ Token เพิ่ม
เครื่องที่ติดตั้ง Node.js แล้วสามารถเริ่มตามrepository ทางการ:
npx @deepseek-ai/dsh web
เมื่อเริ่มแล้ว กรอก DeepSeek API Key ในหน้า Web เลือก workspace แล้วส่งงาน คำสั่งนี้จะดึง package version ที่ใช้งานได้ตอนรัน ไม่ได้ล็อกไว้ที่ v0.1.5 หากต้องการทำซ้ำสภาพแวดล้อมเดิม ให้บันทึก version จริงเพิ่มเติม
เริ่มจากงานเล็กที่ตรวจรับได้:
Read the current workspace project notes and create a Markdown getting-started guide.
Include startup commands, required configuration, and one minimal validation step.
Only add docs/getting-started-draft.md; do not change business code.
After completion, check whether the paths in the document exist and list anything that could not be confirmed.
ผลลัพธ์ที่คาดหวังคือไฟล์ Markdown ที่เปิดได้จริง ไม่ใช่เพียงข้อความ “เสร็จแล้ว” ในแชต ตรวจว่าไฟล์ถูกสร้างจริง path ถูกต้อง และคำสั่งเริ่มต้นมีแหล่งอ้างอิง จากนั้นจึงค่อยขยายงาน ดูการตั้งค่าไคลเอนต์เพิ่มเติมได้จากบทเรียนการเชื่อมต่อ
เปิดน้ำหนักโมเดลแล้ว deploy บนคอมพิวเตอร์ทั่วไปได้หรือไม่?
ไม่ควรสรุปจาก “อินพุตเปิดใช้งานเพียง 8B” ว่า “ฮาร์ดแวร์ระดับ 8B ก็ deploy ได้” backbone ของ V4.1 Flash ยังมีขนาด 552B การ deploy จริงยังขึ้นอยู่กับ precision ของน้ำหนัก runtime cache concurrency และ storage
โมเดลและน้ำหนักใช้ใบอนุญาต MIT ดูได้จากrepository โมเดลอย่างเป็นทางการ และรายงานทางเทคนิค ประกาศเปิดตัวพูดถึงความร่วมมือด้านการ deploy ขนาดใหญ่สำหรับทีมที่มี GPU ราว 2,000 ใบและ storage cluster ซึ่งเป็นเงื่อนไขความร่วมมือ ไม่ใช่สเปกขั้นต่ำที่ประกาศ
หากเป้าหมายหลักคือสร้างแอป รัน Agent หรือวัดผลทางธุรกิจ ควรใช้ API เก็บข้อมูลคุณภาพและต้นทุนจากงานของตัวเองก่อน แล้วค่อยประเมิน self-hosting
คำถามที่พบบ่อย
DeepSeek V4.1 Flash มี 550B หรือ 552B?
หน้าเปิดตัวและ model card ทางการใช้ 552B และหมายถึงขนาด backbone 550B เป็นตัวเลขโดยประมาณจากบทความบางแห่ง เมื่อต้องทำตารางสเปกหรือประเมิน deploy ให้ใช้ 552B
API model ID ของ V4.1 Flash คืออะไร?
DeepSeek แนะนำอย่างเป็นทางการว่าใช้ deepseek-flash อย่าประกอบชื่อเป็น deepseek-v4.1-flash เอง แม้แพลตฟอร์มภายนอกจะใช้ alias นี้ ก็ไม่ได้หมายความว่าเป็นชื่อ API ทางการ
0.02 หยวนซื้อได้ 1 ล้าน Token ทุกประเภทหรือไม่?
ไม่ได้ 0.02 หยวน / ล้าน Tokens หมายถึง input ที่ cache hit ในช่วงนอกพีกเท่านั้น input ที่ cache miss, output และช่วงพีกมีราคาแตกต่างกัน
V4.1 Flash รองรับการเข้าใจภาพและสร้างภาพไหม?
โมเดลรับข้อความและรูปภาพแล้วสร้างข้อความ เหมาะกับการเข้าใจภาพหน้าจอและวิเคราะห์กราฟ model card ทางการไม่ได้ระบุว่าเป็นโมเดลสร้างภาพ
V4 Pro ถูกยุติทั้งหมดแล้วหรือยัง?
ณ วันที่เผยแพร่บทความ 10 กันยายน 2026 ทางการประกาศเพียงกำหนดการเปลี่ยนหลัง 14 กันยายน เวลา 12:00 จึงไม่ควรเขียนล่วงหน้าว่าเปลี่ยนทั้งหมดแล้ว โมเดล Flash เก่าสองรายการถูกยุติแล้ว ส่วนชื่อเดิมยังใช้ได้ชั่วคราว
การเรียกผ่านเว็บไซต์นี้คิดราคาตามช่วงพีก/นอกพีกของ DeepSeek หรือไม่?
สรุปแบบนั้นไม่ได้ ตารางนี้เป็นราคาของ DeepSeek API โดยตรง ส่วน model ID ความพร้อมใช้งาน และการคิดเงินของเว็บไซต์ให้ยึดราคาโมเดลแบบเรียลไทม์และใบแจ้งยอดจริง หลังยืนยันโมเดลแล้ว สามารถเริ่มทดสอบจำนวนน้อยได้จากหน้าซื้อ
สรุป: ดูต้นทุนรวมของงานก่อน แล้วค่อยดูช่วงเวลาย้ายโมเดล
DeepSeek V4.1 Flash รวม vision แบบเนทีฟ การคำนวณแบบไม่สมมาตร และ cache บริบทที่กระชับขึ้นไว้ด้วยกัน สำหรับ Agent ที่มีอินพุตยาวและเรียกเครื่องมือหลายรอบ นี่คือการอัปเดตที่ควรทดสอบด้วยงานจริง สำหรับแอป API เดิม เรื่องเร่งด่วนคือยืนยัน routing ของ alias เก่าและเวลาที่ Pro จะเปลี่ยนในวันที่ 14 กันยายน
ลำดับที่ใช้งานได้จริงคือ ยืนยัน model ID → ทดลองรับรองด้วยงานของตัวเอง → ตรวจ cache และ output billing → อัปเดตการตั้งค่า วิธีนี้ช่วยเปลี่ยน “ข่าวเปิดตัวโมเดล” ให้เป็นการอัปเกรดแอปที่วัดผลได้
แหล่งอ้างอิง
- หน้าเปิดตัว DeepSeek V4.1 Flash: วันที่เปิดตัว โครงสร้าง 552B เวลาที่ราคาเริ่มใช้ และกำหนดการย้าย
- Model card อย่างเป็นทางการ: โครงสร้าง CED ตารางประเมิน สภาพแวดล้อมทดสอบ KV Cache และ MIT
- โมเดลและราคาทางการของ DeepSeek: ราคา RMB ช่วงพีก/นอกพีก context และ output limit
- คู่มือเรียกครั้งแรกอย่างเป็นทางการ: model ID ปัจจุบัน ตัวอย่าง request และชื่อที่รองรับ
- คู่มือ image understanding อย่างเป็นทางการ: ความสามารถด้าน image input และรูปแบบ
- repository อย่างเป็นทางการของ DeepSeek Harness: วิธีเริ่มใช้งานและสถานะ developer preview
- เอกสารเพิ่มเติม: บทความ WeChat หนึ่ง, บทความ WeChat สอง ส่วน Harness v0.1.5 เรียบเรียงจากเนื้อหาประกอบการเปิดตัว
ตรวจสอบข้อมูลล่าสุด: 10 กันยายน 2026 บทความนี้เป็นการอธิบายข้อมูลเปิดตัวและคู่มือเชื่อมต่อ ไม่ใช่การทดสอบประสิทธิภาพแบบอิสระ