DeepSeek V4.1 Flash dengan berat terbuka: seni bina 552B, harga API dan panduan migrasi
DeepSeek V4.1 Flash dilancarkan pada 10 September 2026 dan berat modelnya dibuka; nama rasmi untuk panggilan API ialah deepseek-flash. Model ini menyokong input teks dan imej secara asli serta menggunakan struktur tidak simetri yang baharu: backbone mempunyai 552B parameter, kira-kira 8B parameter diaktifkan bagi setiap Token ketika memproses input dan kira-kira 16B ketika menjana output. Pengumuman rasmi
Yang penting kepada pembangun bukan sekadar peningkatan skor benchmark. Tiga perkara memberi kesan langsung kepada integrasi: keupayaan Agent yang lebih baik, harga cache untuk sesi panjang yang lebih rendah dan perubahan model sebenar di sebalik nama model lama. DeepSeek khususnya telah menerbitkan jadual penghalaan deepseek-v4-pro selepas 14 September 2026, 12:00 waktu Beijing.
Imej dalam artikel ini ialah imej rasmi DeepSeek dan dikekalkan tanpa perubahan. Skor benchmark ialah keputusan yang diterbitkan oleh pembekal, bukan ujian semula bebas oleh laman ini.
Apakah DeepSeek V4.1 Flash? Spesifikasi utama
| Item | Maklumat yang diterbitkan |
|---|---|
| Tarikh pelancaran | 10 September 2026 |
| Nama model API rasmi | deepseek-flash |
| Jenis model | MoE multimodal asli, menerima teks dan imej, menjana teks |
| Saiz backbone | 552B, kira-kira 552 bilion parameter |
| Parameter aktif input / output | 8B / 16B (prefill / decode) |
| Seni bina | Causal Encoder-Decoder, atau CED |
| Tetingkap konteks | 1M Tokens |
| Output API maksimum | 384K Tokens |
| Global KV Cache | 890 bytes / Token, kira-kira satu perempat V4 Flash |
| Lesen berat dan repositori | MIT |
Semak parameter dan seni bina dalam model card rasmi DeepSeek; had konteks, output dan ciri API pula dalam halaman harga API rasmi. Sesetengah ringkasan menulis kira-kira 550B, tetapi artikel ini menggunakan angka rasmi 552B.
Jika anda mahu menggunakan model melalui laman ini, lihat harga model masa nyata. Pengumuman rasmi dan penyegerakan gateway pihak ketiga ialah dua perkara berbeza: konfigurasikan model ID sebenar dalam direktori, manakala harga dan ketersediaan laman ini perlu disahkan melalui direktori semasa, hasil panggilan dan bil sebenar.
Apakah maksud 552B, 8B dan 16B?
Model MoE tidak menggunakan semua parameter untuk setiap Token. 552B ialah skala parameter backbone, manakala 8B dan 16B ialah skala yang diaktifkan bagi setiap Token pada peringkat pengiraan masing-masing. Jangan anggap ketiga-tiganya sebagai tiga “saiz model” yang boleh saling menggantikan.
Backbone CED V4.1 Flash mempunyai 40 lapisan, terdiri daripada 20 lapisan causal encoder dan 20 lapisan decoder. Model card rasmi menerangkan bahawa global KV Cache decoder diproyeksikan daripada hidden state akhir encoder, bukan dijana secara berasingan oleh setiap lapisan decoder. Ini membolehkan pemprosesan input dan penjanaan output menggunakan skala pengiraan yang berbeza.
Untuk analisis codebase, pembacaan bahan panjang dan panggilan alat berbilang pusingan, reka bentuk ini mengurangkan beban pemprosesan input. Namun, kualiti input dan output tidak boleh dinilai hanya melalui parameter aktif, dan deployment tidak bermakna hanya perlu memuatkan berat tahap 8B.
Di manakah skor Agent meningkat? Perbandingan dengan V4 Pro
Jadual berikut diambil daripada jadual perbandingan dalam model card rasmi. Lajur perubahan ialah perbezaan skor, bukan peratus relatif.
| Penilaian | V4 Pro | V4.1 Flash | Perubahan |
|---|---|---|---|
| DeepSWE v1.1 | 62.7 | 74.2 | +11.5 |
| Terminal-Bench 3.0 | 11.8 | 30.0 | +18.2 |
| AutomationBench | 43.2 | 54.8 | +11.6 |
| CyberGym | 83.3 | 88.1 | +4.8 |
| GPQA Diamond | 92.4 | 90.9 | −1.5 |
Empat baris pertama menunjukkan V4.1 Flash mengatasi Pro generasi sebelumnya dalam beberapa benchmark kod, terminal dan automasi. Namun GPQA Diamond masih lebih rendah daripada V4 Pro. Kesimpulan yang lebih tepat ialah keupayaan Agent meningkat dengan ketara, bukan semua keupayaan mengatasi model lama. Jadual penilaian dan syarat ujian rasmi
Persekitaran runtime juga penting. Perbandingan Instruct dalam model card menggunakan intensiti penaakulan tertinggi, temperature=1.0 dan top_p=0.95; skor 74.2 DeepSWE v1.1 merujuk kepada persekitaran mini-SWE, manakala model yang sama mendapat 72.6 dalam DSH Minimal. Versi model, set tugas, rangka kerja Agent dan bajet penaakulan semuanya mempengaruhi keputusan.
Untuk pemilihan model, ambil tiga sampel daripada kerja sebenar: pembaikan kod yang mempunyai ujian, tugas terminal yang memerlukan beberapa arahan dan bahan dengan tangkapan skrin atau carta. Bandingkan kadar siap, jumlah masa dan bil; ini lebih hampir kepada manfaat sebenar berbanding satu skor leaderboard.
Harga API: input 1 yuan, output 4 yuan / juta Token di luar waktu puncak
Harga ini berkuat kuasa pada 10 September 2026, 12:00 waktu Beijing. Jadual berikut ialah harga langsung rasmi DeepSeek dalam RMB, dengan unit yuan / juta Tokens, bukan harga gateway laman ini. Halaman harga rasmi
| Item bil | Luar waktu puncak | Waktu puncak |
|---|---|---|
| Input: cache hit | ¥0.02 | ¥0.04 |
| Input: cache miss | ¥1.00 | ¥2.00 |
| Output | ¥4.00 | ¥8.00 |
Waktu puncak ialah Isnin hingga Jumaat, 09:00—12:00 dan 14:00—18:00 waktu Beijing; waktu lain termasuk hujung minggu ialah luar waktu puncak. Gunakan tempoh yang jelas ini, bukan tafsiran sendiri terhadap jadual hari bekerja selepas cuti.
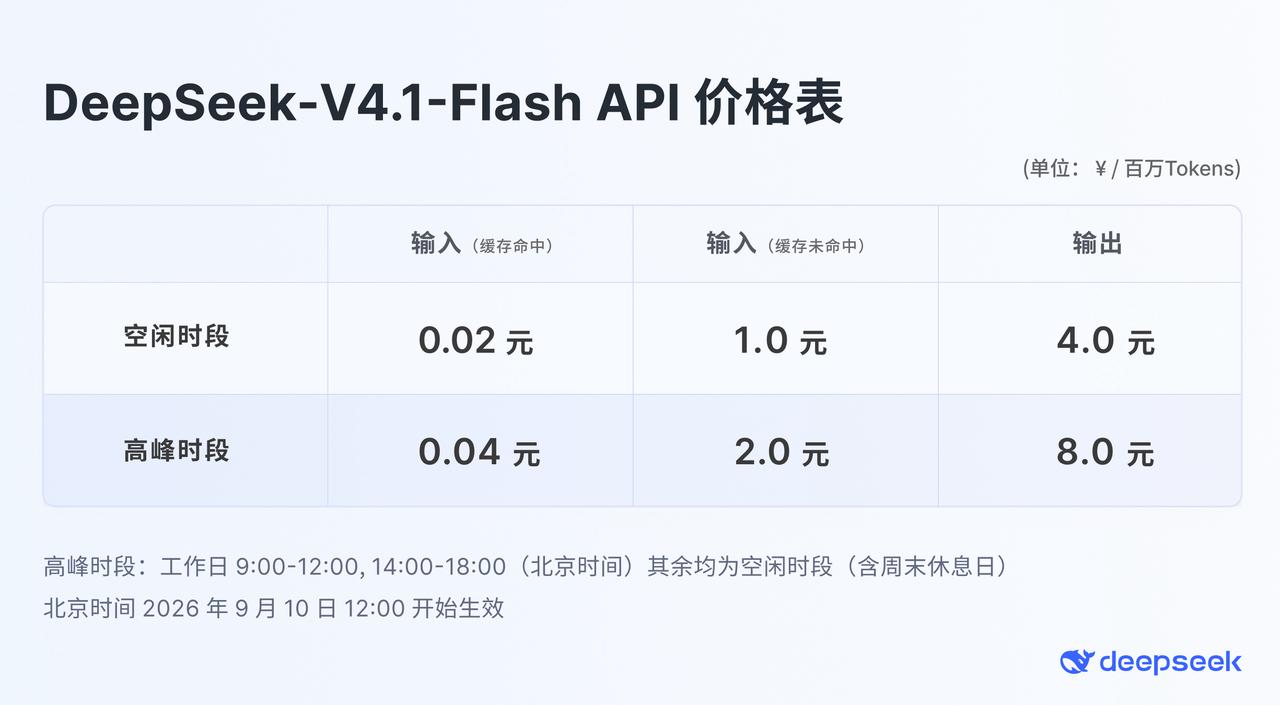
Sumber: pengumuman rasmi DeepSeek, imej asal tanpa perubahan. Harga boleh berubah; penyedia pihak ketiga mengenakan caj secara berasingan.
Contoh bil Agent yang boleh dikira semula
Anggap satu kumpulan tugas menggunakan 8 juta input Tokens cache hit, 2 juta input Tokens cache miss dan 0.5 juta output Tokens, semuanya dalam jalur waktu yang sama:
Jumlah kos = juta input hit × harga hit
           + juta input miss × harga miss
           + juta output × harga output

Luar waktu puncak: 8 × 0.02 + 2 × 1 + 0.5 × 4 = 4.16 yuan
Waktu puncak:      8 × 0.04 + 2 × 2 + 0.5 × 8 = 8.32 yuan
Dua harga input memang berbeza 50 kali, tetapi ini tidak bermakna keseluruhan tugas menjadi 50 kali lebih murah. Dalam contoh ini, bahagian cache-hit input hanya berharga 0.16 yuan, manakala input miss dan output masing-masing berharga 2 yuan. Pengoptimuman perlu melihat cache, panggilan alat berulang, output berlebihan dan retry.
Mengapa KV Cache yang lebih kecil penting untuk sesi panjang?
KV Cache menyimpan hasil pengiraan perantaraan konteks. Bagi Agent yang berulang kali membaca codebase, arahan sistem dan sejarah perbualan yang sama, penggunaan semula prefix mengurangkan pengiraan berulang. V4.1 Flash memampatkan global KV Cache kepada 890 bytes / Token, kira-kira satu perempat V4 Flash. Penerangan seni bina rasmi
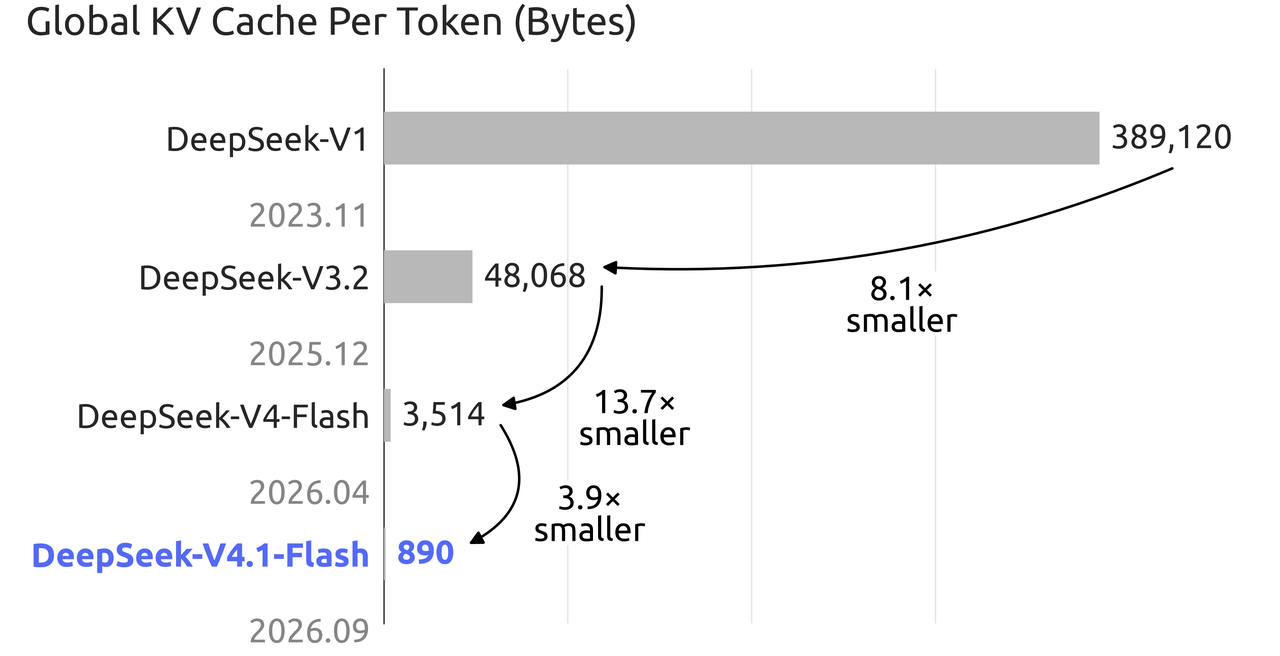
Sumber: pengumuman rasmi DeepSeek, imej asal tanpa perubahan. Carta membandingkan global KV Cache bagi setiap Token, bukan jumlah VRAM deployment model.
Bezakan dua ukuran storan: bahan rasmi menyatakan keperluan HBM untuk cache turun kepada kira-kira 1/4, manakala SSD kepada kira-kira 1/8. Ini merujuk kepada sumber cache, bukan berat model, seluruh memori runtime atau kluster deployment yang mengecil dalam kadar sama.
Bagi pihak integrasi, kekalkan prefix yang boleh digunakan semula supaya stabil; elakkan timestamp berubah, ID rawak atau senarai alat yang disusun semula dalam prefix setiap pusingan. Kemudian semak hit melalui medan usage sebenar. Jangan menganggap cache hit hanya kerana “kandungannya hampir sama”.
Bagaimanakah DeepSeek V4.1 Flash API dipanggil?
Untuk integrasi baharu, gunakan nama rasmi deepseek-flash. Contoh berikut menggunakan Chat Completions API langsung; tetapkan DEEPSEEK_API_KEY dalam terminal terlebih dahulu. Contoh ini belum disahkan melalui panggilan berbayar di laman ini.
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {
        "role": "user",
        "content": "Senaraikan langkah pelaksanaan, kes sempadan dan kaedah penerimaan untuk alat menamakan semula fail Markdown secara kelompok."
      }
    ],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "high",
    "max_tokens": 2048,
    "stream": false
  }'
JSON yang dijangka dikembalikan mempunyai teks jawapan pada choices[0].message.content. Semasa pengesahan, semak HTTP status, kandungan respons dan usage; jangan hanya melihat sama ada permintaan berjaya dihantar. Panduan panggilan pertama rasmi
Vision asli bermaksud model memahami imej, bukan menghasilkan imej. Untuk memproses tangkapan skrin, tambah image content block berdasarkan panduan pemahaman imej rasmi. Permintaan teks yang berjaya tidak menggantikan pengesahan berasingan untuk input imej, tool call dan streaming.
Jika menggunakan gateway pihak ketiga, semak Base URL, model ID, pengesahan dan sokongan protokol bersama-sama. Menukar alamat rasmi sahaja tidak menjamin ciri dan tingkah laku bil yang sama.
Bolehkah model lama terus digunakan? Bilakah V4 Pro bertukar?
| Nama model yang sedang dikonfigurasikan | Pengendalian rasmi |
|---|---|
deepseek-flash |
Nama yang disyorkan untuk integrasi baharu, memanggil V4.1 Flash |
deepseek-v4-flash |
Model lama telah ditamatkan; nama masih serasi sementara dan dihalakan ke V4.1 Flash |
deepseek-v4-flash-vision-exp |
Model lama telah ditamatkan; nama masih serasi sementara dan dihalakan ke V4.1 Flash |
deepseek-v4-pro |
Selepas 14/09/2026 12:00 waktu Beijing dan sebelum V4.1 Pro akan datang dilancarkan, semuanya dihalakan ke V4.1 Flash dan dicaj mengikut harga Flash baharu |
Ini ialah aturan API rasmi DeepSeek; gateway pihak ketiga mungkin menggunakan alias dan jadual migrasi yang berbeza. Mengekalkan nama lama tidak mengunci model lama, dan bukan strategi untuk kembali kepada berat lama.
Migrasi boleh dibuat dalam tiga langkah: eksport model name semasa dan sampel request penting; uji teks, imej, alat dan penggunaan cache dengan nama baharu; kemudian kemas kini model lalai, templat tugas dan rekod bil. Untuk tugas yang perlu dihasilkan semula dengan tepat, simpan tarikh panggilan, pembekal sebenar dan respons, bukan sekadar alias lama.
Apakah yang berubah dalam DeepSeek Harness v0.1.5?
Model mengendalikan pemahaman dan penaakulan, manakala Harness menghubungkan fail, arahan dan alat supaya output model menjadi tugas yang boleh dilaksanakan. Bersama pelancaran ini, DeepSeek Harness dikemas kini kepada v0.1.5 dan disesuaikan dengan standard mode, Programmatic Tool Calling (PTC) dan minimal mode.
Menurut bahan pelancaran, versi baharu menyokong muat naik imej dan PDF, fail tree workspace dan pratonton artifak; memperbaiki pemulihan sesi panjang dan navigasi; serta menambah baik komunikasi dua hala parent/child Agent, queued messages dan campur tangan tugas. Agent Teams eksperimen boleh membahagikan kerja melalui task list bersama, tetapi dimatikan secara lalai dan menggunakan Token tambahan apabila diaktifkan.
Pada sistem yang sudah memasang Node.js, ikut repositori rasmi:
npx @deepseek-ai/dsh web
Selepas bermula, masukkan DeepSeek API Key dalam antara muka Web, pilih workspace dan hantar tugas. Arahan ini mendapatkan versi pakej yang tersedia ketika dijalankan dan tidak mengunci v0.1.5; jika perlu mengulang persekitaran sejarah, simpan versi sebenar secara berasingan.
Mulakan dengan tugasan kecil yang boleh diterima:
Read the current workspace project notes and create a Markdown getting-started guide.
Include startup commands, required configuration, and one minimal validation step.
Only add docs/getting-started-draft.md; do not change business code.
After completion, check whether the paths in the document exist and list anything that could not be confirmed.
Hasil yang dijangka ialah fail Markdown sebenar yang boleh dibuka, bukan hanya mesej “selesai” dalam chat. Semak fail benar-benar wujud, path betul dan arahan permulaan mempunyai sumber sebelum meluaskan tugas. Lihat tutorial integrasi untuk konfigurasi klien lanjut.
Bolehkah model sumber terbuka ini digunakan pada komputer biasa?
Jangan simpulkan bahawa “hanya 8B diaktifkan untuk input” bermakna “perkakasan kelas 8B sudah mencukupi”. Backbone V4.1 Flash masih 552B; deployment sebenar bergantung pada ketepatan berat, runtime, cache, concurrency dan storan.
Model dan berat menggunakan lesen MIT. Rujuk repositori model rasmi dan laporan teknikal. Pengumuman menyebut kerjasama deployment berskala besar untuk pasukan dengan sekitar 2,000 GPU dan kluster storan; itu ialah syarat kerjasama, bukan konfigurasi deployment minimum yang diumumkan.
Jika matlamat utama ialah membina aplikasi, menjalankan Agent atau mengesahkan kesan perniagaan, kumpulkan data kualiti dan kos sendiri melalui API dahulu sebelum menilai self-hosting.
Soalan lazim
DeepSeek V4.1 Flash ialah 550B atau 552B?
Halaman rasmi dan model card menggunakan 552B untuk saiz backbone. 550B ialah anggaran dalam sesetengah ringkasan; gunakan angka rasmi untuk spesifikasi dan penilaian deployment.
Apakah API model ID untuk V4.1 Flash?
DeepSeek secara rasmi mengesyorkan deepseek-flash. Jangan cipta deepseek-v4.1-flash sendiri; alias di platform pihak ketiga tidak menjadikannya nama API rasmi.
Adakah 0.02 yuan boleh membeli 1 juta Token sebarang jenis?
Tidak. 0.02 yuan / juta Tokens hanya untuk input cache hit di luar waktu puncak. Input cache miss, output dan waktu puncak mempunyai harga berbeza.
Adakah V4.1 Flash menyokong pemahaman vision dan penjanaan imej?
Ia menerima teks dan imej secara asli lalu menjana teks, sesuai untuk memahami tangkapan skrin dan menganalisis carta. Model card rasmi tidak mentakrifkannya sebagai model penjana imej.
Adakah V4 Pro sudah dihentikan sepenuhnya?
Pada tarikh terbit artikel, 10 September 2026, DeepSeek baru mengumumkan jadual pertukaran selepas 14 September 12:00; jangan menulis lebih awal bahawa semuanya sudah bertukar. Dua model Flash lama telah dihentikan, manakala nama lama masih serasi buat sementara.
Adakah panggilan melalui laman ini menggunakan harga puncak/luar puncak rasmi?
Jangan membuat kesimpulan itu. Jadual ini merujuk API langsung DeepSeek; model ID, ketersediaan dan caj laman ini bergantung pada harga model masa nyata dan bil sebenar. Selepas memilih model, mulakan ujian kecil melalui halaman pembelian.
Kesimpulan: kira jumlah kos tugas dahulu, kemudian semak tetingkap migrasi
DeepSeek V4.1 Flash menggabungkan vision asli, pengiraan tidak simetri dan cache konteks yang lebih padat. Untuk Agent dengan input panjang dan panggilan alat berbilang pusingan, kemas kini ini wajar diuji pada tugas sebenar. Bagi aplikasi API sedia ada, perkara paling mendesak ialah mengesahkan penghalaan alias lama dan masa pertukaran Pro pada 14 September.
Urutan praktikal ialah sahkan model ID → uji dengan tugas sendiri → semak cache dan bil output → kemas kini konfigurasi. Dengan cara ini, “pelancaran model” dapat diterjemahkan kepada naik taraf aplikasi yang boleh diukur.
Sumber rujukan
- Halaman pelancaran DeepSeek V4.1 Flash: tarikh, struktur 552B, masa harga berkuat kuasa dan jadual migrasi.
- Model card rasmi DeepSeek V4.1 Flash: CED, jadual penilaian, persekitaran ujian, KV Cache dan MIT.
- Model dan harga rasmi DeepSeek: harga RMB puncak/luar puncak, konteks dan had output.
- Panduan panggilan pertama rasmi DeepSeek: model ID semasa, contoh request dan nama serasi.
- Panduan pemahaman imej rasmi DeepSeek: keupayaan input imej dan format.
- Repositori rasmi DeepSeek Harness: kaedah permulaan dan status pratonton pembangun.
- Bahan tambahan: artikel WeChat 1, artikel WeChat 2. Bahagian Harness v0.1.5 dirumus daripada bahan pelancaran yang disertakan.
Tarikh semakan bahan: 10 September 2026. Ini ialah ulasan maklumat pelancaran dan panduan integrasi, bukan penilaian prestasi bebas.