DeepSeek V4.1 Flash open source : architecture 552B, prix API et guide de migration
DeepSeek V4.1 Flash a été publié le 10 septembre 2026 avec des poids ouverts ; son nom d’appel API officiel est deepseek-flash. Le modèle accepte nativement le texte et les images, avec une nouvelle architecture asymétrique : 552B paramètres dans le tronc, environ 8B paramètres actifs par token en entrée et 16B en génération. Annonce officielle
Pour les développeurs, l’enjeu ne se limite pas à de meilleurs scores. Trois points changent directement l’intégration : capacités agentiques plus fortes, coût de cache plus bas pour les longues sessions, et changement réel du modèle derrière d’anciens noms. C’est surtout le cas de deepseek-v4-pro, pour lequel DeepSeek a annoncé une bascule de routage après le 14 septembre à 12:00, heure de Pékin.
Les images ci-dessous reprennent les visuels originaux publiés par DeepSeek. Les benchmarks cités proviennent du fournisseur et n’ont pas été remesurés indépendamment par ce site.
Qu’est-ce que DeepSeek V4.1 Flash ? Spécifications clés
| Élément | Information publiée |
|---|---|
| Date de publication | 10 septembre 2026 |
| Nom officiel du modèle API | deepseek-flash |
| Type de modèle | MoE multimodal natif, texte et images en entrée, texte en sortie |
| Paramètres du tronc | 552B, environ 552 milliards |
| Paramètres actifs entrée / sortie | 8B / 16B (prefill / decode) |
| Architecture | Causal Encoder-Decoder, ou CED |
| Fenêtre de contexte | 1M tokens |
| Sortie maximale API | 384K tokens |
| KV Cache global | 890 bytes / token, environ un quart de V4 Flash |
| Licence des poids et du dépôt | MIT |
Les paramètres et l’architecture doivent être lus dans la carte modèle officielle DeepSeek. Le contexte, la limite de sortie et les fonctions API doivent être vérifiés sur la page officielle des prix et modèles. Certaines reprises parlent d’environ 550B paramètres ; cet article retient la valeur officielle 552B.
Si vous comptez l’utiliser via ce site, commencez par la page des prix en temps réel. Une annonce officielle et la synchronisation d’une passerelle tierce sont deux choses différentes : configurez toujours l’ID réellement affiché dans le catalogue, et prenez les prix et disponibilités de ce site dans le catalogue, les réponses API et la facture réelle.
Que signifient 552B, 8B et 16B ?
Un modèle MoE n’active pas tous ses paramètres pour chaque token généré. 552B désigne la taille du tronc ; 8B et 16B décrivent le volume actif par token aux étapes de calcul correspondantes. Ces trois chiffres ne sont donc pas trois “tailles de modèle” interchangeables.
Le tronc CED de V4.1 Flash compte 40 couches : 20 couches d’encodeur causal et 20 couches de décodeur. La carte modèle précise que le KV Cache global du décodeur est projeté depuis l’état caché final de l’encodeur, au lieu d’être produit indépendamment par chaque couche du décodeur. Cela permet d’utiliser des volumes de calcul différents pour traiter l’entrée et générer la sortie.
Pour l’analyse de dépôts, la lecture de longs documents et les appels d’outils multi-tours, où l’entrée est volumineuse et relue plusieurs fois, cette conception réduit surtout le coût du traitement d’entrée. Elle ne signifie pas que la qualité se juge uniquement au nombre de paramètres actifs, ni qu’un déploiement ne chargerait que 8B paramètres.
Où les benchmarks d’agents progressent-ils face à V4 Pro ?
Le tableau reprend les résultats de la carte modèle officielle. La colonne de variation indique une différence de score, pas un pourcentage relatif.
| Benchmark | V4 Pro | V4.1 Flash | Variation |
|---|---|---|---|
| DeepSWE v1.1 | 62.7 | 74.2 | +11.5 |
| Terminal-Bench 3.0 | 11.8 | 30.0 | +18.2 |
| AutomationBench | 43.2 | 54.8 | +11.6 |
| CyberGym | 83.3 | 88.1 | +4.8 |
| GPQA Diamond | 92.4 | 90.9 | −1.5 |
Les quatre premières lignes montrent que V4.1 Flash dépasse l’ancien Pro sur plusieurs tâches de code, terminal et automatisation ; GPQA Diamond reste toutefois inférieur à V4 Pro. La conclusion correcte est donc : les capacités agentiques progressent nettement, sans domination absolue sur tous les axes. Table officielle et conditions de test
L’environnement d’exécution compte tout autant. Les comparaisons Instruct de la carte modèle utilisent l’intensité de raisonnement maximale, temperature=1.0 et top_p=0.95. Le score DeepSWE v1.1 de 74.2 correspond à l’environnement mini-SWE ; le même modèle obtient 72.6 sous DSH Minimal. Version du modèle, jeu de tâches, framework agentique et budget de raisonnement influencent ensemble le résultat.
Pour choisir un modèle, prenez trois petits exemples de vos propres tâches : une correction de code avec tests existants, une tâche terminal multi-commandes et une tâche documentaire avec capture ou graphique. Comparez taux d’acceptation, temps total et facture : ce sera plus proche de votre retour réel qu’un seul score de classement.
Prix API : 1 yuan en entrée et 4 yuans en sortie par million de tokens en heures creuses
Ces prix s’appliquent depuis le 10 septembre 2026 à 12:00, heure de Pékin. Les montants ci-dessous sont les prix directs officiels DeepSeek en RMB, en yuans / million de tokens ; ce ne sont pas les tarifs de cette passerelle. Page officielle des prix
| Poste facturé | Heures creuses | Heures de pointe |
|---|---|---|
| Entrée : cache hit | ¥0.02 | ¥0.04 |
| Entrée : cache miss | ¥1.00 | ¥2.00 |
| Sortie | ¥4.00 | ¥8.00 |
Les heures de pointe sont du lundi au vendredi, 09:00—12:00 et 14:00—18:00, heure de Pékin. Tout le reste est en heures creuses, week-ends inclus. Utilisez cette plage explicite, sans appliquer vous-même une logique de jours fériés ou de rattrapage.
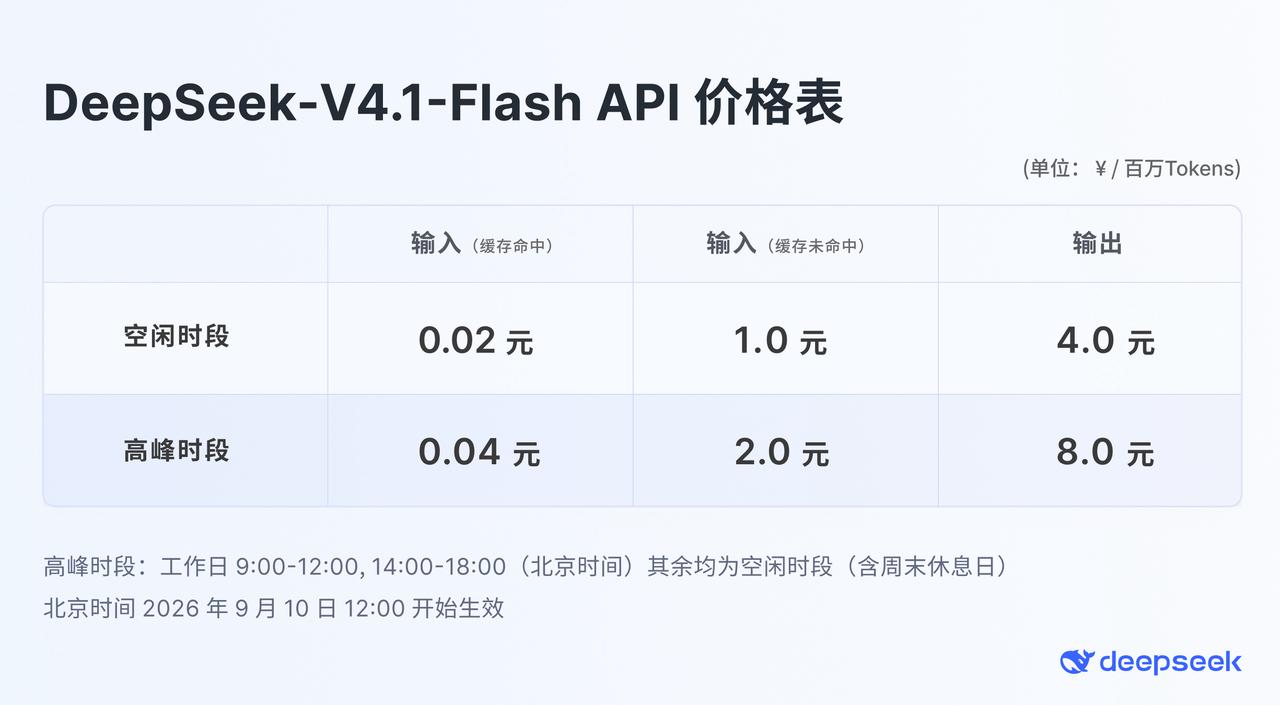
Source : annonce officielle DeepSeek, image non modifiée. Les prix peuvent changer ; les fournisseurs tiers facturent séparément.
Exemple de facture agentique recalculable
Supposons qu’un lot de tâches consomme 8 millions de tokens d’entrée avec cache hit, 2 millions de tokens d’entrée cache miss et 0,5 million de tokens de sortie, le tout dans la même tranche horaire :
Coût total = millions d’entrées hit × prix hit
           + millions d’entrées miss × prix miss
           + millions de sorties × prix sortie

Heures creuses : 8 × 0.02 + 2 × 1 + 0.5 × 4 = 4.16 yuans
Heures de pointe : 8 × 0.04 + 2 × 2 + 0.5 × 8 = 8.32 yuans
Les deux prix d’entrée diffèrent bien d’un facteur 50, mais cela ne rend pas toute la tâche 50 fois moins chère. Dans cet exemple, le cache hit en heures creuses ne coûte que 0.16 yuan, tandis que l’entrée non cachée et la sortie coûtent chacune 2 yuans. Optimisez donc le cache, mais surveillez aussi les appels d’outils répétés, la sortie trop longue et les retries.
Pourquoi un KV Cache plus petit compte surtout pour les longues sessions
Le KV Cache conserve des résultats intermédiaires du contexte. Pour un agent qui relit le même dépôt, les mêmes instructions système ou le même historique de conversation, réutiliser un préfixe identique évite une partie du recalcul. V4.1 Flash compresse le KV Cache global à 890 bytes / token, soit environ un quart de V4 Flash. Architecture officielle
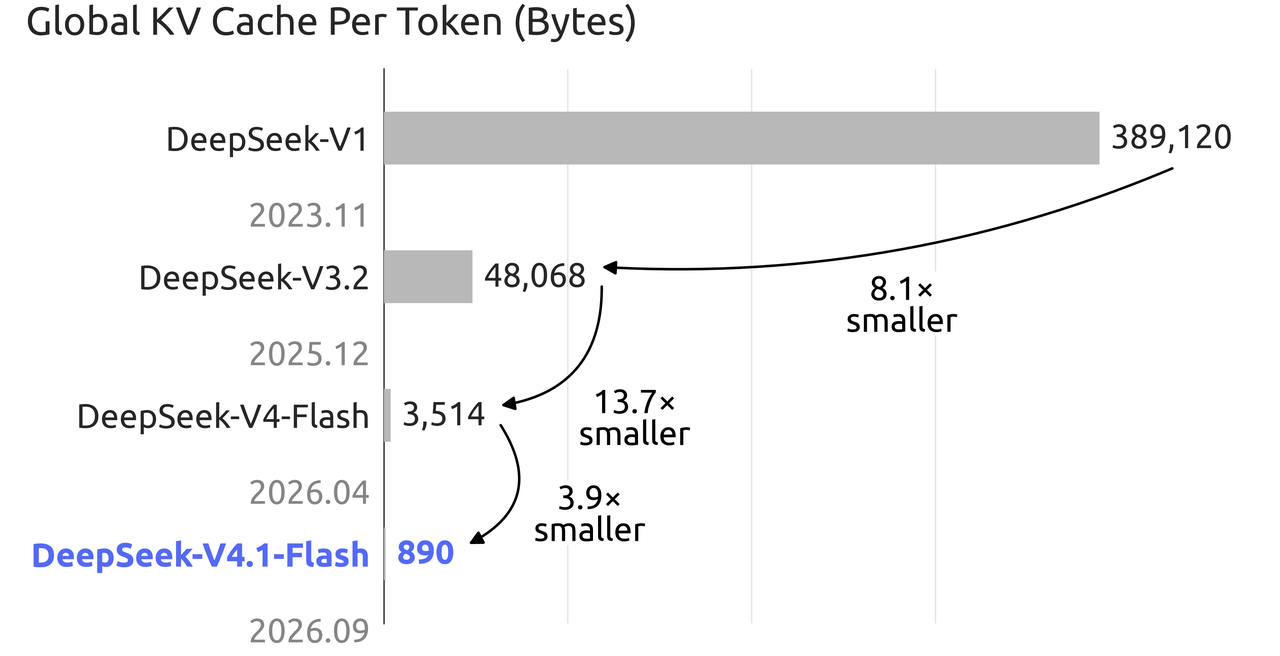
Source : annonce officielle DeepSeek, image non modifiée. La comparaison porte sur le KV Cache global par token, pas sur toute la VRAM nécessaire au déploiement.
Deux métriques de stockage doivent être séparées : DeepSeek indique que les besoins HBM liés au cache baissent à environ 1/4 et les besoins SSD à environ 1/8. Cela décrit les ressources de cache, pas le poids complet du modèle, toute la mémoire d’exécution ou l’ensemble du cluster.
Côté intégrateur, gardez d’abord les préfixes réutilisables stables : évitez d’insérer à chaque tour des timestamps variables, des IDs aléatoires ou des listes d’outils réordonnées. Vérifiez ensuite les champs d’usage réels pour confirmer les hits. Un contenu “presque identique” ne suffit pas à prédire un cache hit.
Comment appeler l’API DeepSeek V4.1 Flash ?
Pour une nouvelle intégration, utilisez le nom officiel deepseek-flash. L’exemple ci-dessous cible l’API Chat Completions directe de DeepSeek pour du texte ; définissez d’abord DEEPSEEK_API_KEY dans votre terminal. Cet exemple n’a pas été validé comme appel payant sur ce site.
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {
        "role": "user",
        "content": "Liste les étapes d’implémentation, les cas limites et les critères d’acceptation pour un outil de renommage en lot de fichiers Markdown."
      }
    ],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "high",
    "max_tokens": 2048,
    "stream": false
  }'
La réponse attendue est du JSON ; le texte se trouve dans choices[0].message.content. Lors de la vérification, contrôlez le statut HTTP, le contenu et usage, pas seulement l’envoi réussi de la requête. Guide officiel du premier appel
La vision native signifie que le modèle comprend des images, pas qu’il en génère. Pour traiter des captures, suivez le guide officiel de compréhension d’images et ajoutez des blocs image dans le message. Une requête texte réussie ne remplace pas les tests séparés d’entrée image, d’appels d’outils et de streaming.
Avec une passerelle tierce, vérifiez ensemble Base URL, ID du modèle, authentification et protocoles disponibles. Remplacer l’URL officielle ne garantit pas les mêmes capacités ni la même facturation.
Les anciens modèles fonctionnent-ils encore ? Quand V4 Pro bascule-t-il ?
| Modèle actuellement configuré | Traitement officiel |
|---|---|
deepseek-flash |
Nom recommandé pour les nouvelles intégrations, appelle V4.1 Flash |
deepseek-v4-flash |
Ancien modèle arrêté ; nom temporairement compatible et routé vers V4.1 Flash |
deepseek-v4-flash-vision-exp |
Ancien modèle arrêté ; nom temporairement compatible et routé vers V4.1 Flash |
deepseek-v4-pro |
Après le 14 septembre 2026 à 12:00, heure de Pékin, et jusqu’à la sortie future de V4.1 Pro, tout est routé vers V4.1 Flash au nouveau prix Flash |
Ces règles viennent des instructions officielles DeepSeek. Une passerelle tierce peut utiliser d’autres alias ou un autre calendrier. Conserver un ancien nom ne verrouille pas l’ancien modèle et ne constitue pas une stratégie de retour arrière vers les anciens poids.
La migration peut suivre trois étapes : exportez d’abord les noms de modèles et requêtes critiques actuels ; testez ensuite le nouveau nom avec texte, image, outils et usage du cache ; enfin, contrôlez modèle par défaut du client, templates de tâches et facturation. Pour les tâches qui exigent une reproductibilité stricte, notez la date d’appel, le fournisseur réel et les informations retournées, pas seulement un ancien alias.
Qu’apporte DeepSeek Harness v0.1.5 ?
Le modèle comprend et raisonne ; Harness connecte fichiers, commandes et outils afin de transformer les sorties du modèle en tâches exécutables. Avec cette sortie, DeepSeek Harness passe à v0.1.5 et le modèle est adapté au mode standard, au mode Programmatic Tool Calling (PTC) et au mode minimal.
D’après les documents de lancement, cette version prend en charge l’upload d’images et de PDF, l’arborescence de l’espace de travail et l’aperçu d’artefacts, améliore la reprise et la navigation dans les longues sessions, et renforce la communication parent-enfant entre agents, les messages en file d’attente et l’intervention sur les tâches. Les Agent Teams expérimentales peuvent répartir le travail via une liste partagée, mais elles sont désactivées par défaut et consomment aussi des tokens supplémentaires.
Sur un système avec Node.js, le lancement suit le dépôt officiel :
npx @deepseek-ai/dsh web
Dans l’interface web, renseignez la clé API DeepSeek, choisissez l’espace de travail, puis soumettez une tâche. Cette commande récupère le paquet disponible au moment de l’exécution ; elle ne fige pas forcément la version v0.1.5. Pour reproduire un environnement historique, enregistrez aussi la version réellement utilisée.
Commencez par une petite tâche vérifiable :
Lis la documentation du projet dans l’espace de travail actuel et génère un guide de démarrage en Markdown.
Indique les commandes de lancement, la configuration nécessaire et une étape de vérification minimale.
Ajoute uniquement docs/getting-started-draft.md, sans modifier le code métier.
À la fin, vérifie que les chemins cités existent et liste les informations non confirmées.
Le résultat attendu est un vrai fichier Markdown ouvrable, pas seulement un message “terminé” dans le chat. Vérifiez que le fichier existe, que les chemins sont corrects et que les commandes ont une source, puis élargissez progressivement les tâches. Pour davantage de configuration client, consultez nos tutoriels.
Peut-on déployer le modèle open source sur un ordinateur ordinaire ?
Non. Le fait que l’entrée n’active que 8B paramètres ne signifie pas qu’un matériel de niveau 8B suffit. Le tronc de V4.1 Flash reste de 552B paramètres ; le déploiement dépend aussi de la précision des poids, du runtime, du cache, de la concurrence et du stockage.
Le modèle et les poids sont sous licence MIT ; les entrées principales sont le dépôt modèle officiel et le rapport technique. L’annonce mentionne des coopérations de déploiement à grande échelle pour des équipes disposant d’environ 2000 GPU et d’un cluster de stockage ; c’est une condition de coopération, pas une configuration minimale publiée.
Pour les équipes qui veulent surtout construire une application, faire tourner des agents ou valider un cas métier, il est généralement plus rationnel de mesurer d’abord qualité et coût via l’API, puis d’étudier l’auto-hébergement.
Questions fréquentes
DeepSeek V4.1 Flash fait-il 550B ou 552B ?
Les pages officielles et la carte modèle indiquent 552B comme taille du tronc. 550B est une approximation dans certaines reprises ; utilisez 552B pour les tableaux de spécifications et les évaluations de déploiement.
Quel est l’ID API de V4.1 Flash ?
DeepSeek recommande deepseek-flash. N’inventez pas deepseek-v4.1-flash à partir du nom marketing ; même si une plateforme tierce expose cet alias, ce n’est pas le nom officiel de l’API directe.
0,02 yuan achète-t-il un million de tokens quelconques ?
Non. 0,02 yuan / million de tokens concerne uniquement l’entrée en cache hit pendant les heures creuses. L’entrée sans cache, la sortie et les heures de pointe ont d’autres tarifs.
V4.1 Flash prend-il en charge la vision et la génération d’images ?
Il accepte nativement le texte et les images en entrée et génère du texte, ce qui couvre la compréhension de captures, graphiques et documents visuels. La carte modèle officielle ne le présente pas comme un modèle de génération d’images.
V4 Pro est-il déjà entièrement arrêté ?
À la date de publication de cet article, le 10 septembre 2026, DeepSeek annonçait une bascule après le 14 septembre à 12:00 ; il ne faut donc pas écrire avant cette date qu’il a déjà entièrement basculé. Les deux anciens modèles Flash sont, eux, arrêtés et leurs noms restent temporairement compatibles.
Ce site facture-t-il selon les prix officiels heures creuses / pointe ?
Il ne faut pas le déduire directement. Le tableau de prix décrit l’API directe DeepSeek ; sur ce site, l’ID de modèle, la disponibilité et la facturation font foi via les prix en temps réel et la facture réelle. Après confirmation du modèle cible, commencez par un petit test depuis la page d’achat.
Conclusion : regardez d’abord le coût total de la tâche, puis la fenêtre de migration
DeepSeek V4.1 Flash combine vision native, calcul asymétrique et cache de contexte plus compact. Pour les agents à longues entrées et nombreux appels d’outils, c’est une mise à jour qui mérite des tests sur de vraies tâches. Pour les applications API existantes, le point le plus urgent est de confirmer les changements de routage des anciens alias et la bascule Pro du 14 septembre.
L’ordre pratique est : confirmer l’ID du modèle → valider sur vos propres tâches → contrôler cache, sortie et facture → mettre à jour la configuration. C’est ainsi qu’une annonce de modèle devient une amélioration réellement utilisable et mesurable.
Sources
- Annonce officielle DeepSeek V4.1 Flash : date de sortie, architecture 552B, date d’entrée en vigueur des prix et migration.
- Carte modèle officielle DeepSeek V4.1 Flash : CED, benchmarks, conditions de test, KV Cache et licence MIT.
- Modèles et prix officiels DeepSeek : prix RMB heures creuses/pointe, contexte et limite de sortie.
- Guide officiel du premier appel DeepSeek : ID modèle actuel, exemple de requête et noms compatibles.
- Guide officiel DeepSeek de compréhension d’images : capacité image et format.
- Dépôt officiel DeepSeek Harness : lancement et état developer preview.
- Documents complémentaires : article WeChat 1, article WeChat 2. Le passage sur Harness v0.1.5 synthétise les informations fournies dans ces documents de lancement.
Sources vérifiées le 10 septembre 2026. Cet article est une analyse de publication et un guide d’intégration, pas un benchmark indépendant.