DeepSeek V4.1 Flash de código abierto: arquitectura 552B, precio de API y guía de migración
DeepSeek V4.1 Flash se publicó el 10 de septiembre de 2026 con los pesos abiertos; su nombre oficial para la API es deepseek-flash. Admite entradas de texto e imagen de forma nativa y utiliza una nueva estructura asimétrica: 552B parámetros en el tronco, unos 8B parámetros activos por token al procesar la entrada y unos 16B al generar la salida. Anuncio oficial
Para los desarrolladores, lo importante no son solo las mejoras en benchmarks. Hay tres cambios que afectan directamente a la integración: más capacidad para tareas de agentes, menor precio del caché en sesiones largas y un cambio del modelo real detrás de algunos nombres antiguos. El caso más relevante es deepseek-v4-pro, cuya ruta estaba prevista para cambiar después del 14 de septiembre a las 12:00, hora de Pekín.
Las imágenes de este artículo son los originales publicados por DeepSeek. Las cifras de benchmarks proceden del proveedor y no han sido medidas de forma independiente por este sitio.
¿Qué es DeepSeek V4.1 Flash? Especificaciones clave
| Elemento | Información publicada |
|---|---|
| Fecha de publicación | 10 de septiembre de 2026 |
| Nombre oficial del modelo en la API | deepseek-flash |
| Tipo de modelo | MoE multimodal nativo: texto e imagen de entrada, texto de salida |
| Parámetros del tronco | 552B, unos 552.000 millones |
| Parámetros activos de entrada / salida | 8B / 16B (prefill / decode) |
| Arquitectura principal | Causal Encoder-Decoder, CED |
| Ventana de contexto | 1M tokens |
| Salida máxima de la API | 384K tokens |
| KV Cache global | 890 bytes / token, aproximadamente una cuarta parte de V4 Flash |
| Licencia de pesos y repositorio | MIT |
Los parámetros y la estructura deben consultarse en la tarjeta oficial del modelo DeepSeek. El contexto, el límite de salida y las funciones de la API deben verificarse en la página oficial de precios y especificaciones. Algunas publicaciones redondean la cifra a 550B; aquí usamos la cifra oficial de 552B.
Si piensas conectarlo desde este sitio, empieza por la página de precios en tiempo real. La publicación oficial y la sincronización de un gateway externo son cosas distintas: configura el ID que aparezca realmente en el catálogo y toma como referencia el catálogo, las respuestas y la factura real del sitio.
¿Qué significan 552B, 8B y 16B?
Un modelo MoE no activa todos sus parámetros para cada token generado. 552B es el tamaño del tronco del modelo; 8B y 16B son los parámetros activos por token en sus respectivas fases de cálculo. No son tres tamaños de modelo intercambiables.
El tronco CED de V4.1 Flash tiene 40 capas: 20 capas de codificador causal y 20 de decodificador. La tarjeta del modelo explica que el KV Cache global del decodificador se proyecta desde el estado oculto final del codificador, en lugar de generarse por separado en cada capa del decodificador. Así, el procesamiento de entrada y la generación de salida pueden usar escalas de cálculo distintas.
Para analizar repositorios, leer documentos largos y realizar llamadas de herramientas en varios turnos, donde se lee repetidamente mucho contexto de entrada, este diseño reduce sobre todo el coste de procesar la entrada. No significa que la calidad pueda juzgarse solo por los parámetros activos ni que para desplegarlo baste con cargar 8B de pesos.
¿Dónde mejoran los benchmarks de agentes frente a V4 Pro?
La tabla reproduce resultados de la tarjeta oficial del modelo. La columna de cambio es una diferencia de puntos, no un porcentaje relativo.
| Benchmark | V4 Pro | V4.1 Flash | Cambio |
|---|---|---|---|
| DeepSWE v1.1 | 62.7 | 74.2 | +11.5 |
| Terminal-Bench 3.0 | 11.8 | 30.0 | +18.2 |
| AutomationBench | 43.2 | 54.8 | +11.6 |
| CyberGym | 83.3 | 88.1 | +4.8 |
| GPQA Diamond | 92.4 | 90.9 | −1.5 |
Las cuatro primeras filas indican que V4.1 Flash supera al anterior Pro en varios benchmarks de código, terminal y automatización; GPQA Diamond sigue por debajo de V4 Pro. La conclusión correcta es que las capacidades de agente mejoran claramente, pero no todas las capacidades lideran en todos los benchmarks. Tabla oficial y condiciones de prueba
El entorno de ejecución también importa. La comparación Instruct de la tarjeta usa el máximo nivel de razonamiento, temperature=1.0 y top_p=0.95. El 74.2 de DeepSWE v1.1 corresponde al entorno mini-SWE; el mismo modelo obtiene 72.6 en DSH Minimal. La versión del modelo, el conjunto de tareas, el framework del agente y el presupuesto de razonamiento influyen conjuntamente.
Para elegir, toma tres muestras pequeñas de tus propias tareas: una corrección de código con pruebas existentes, una tarea de terminal con varios comandos y una tarea documental con una captura o un gráfico. Compara tasa de aceptación, tiempo total y factura; será más representativo que comparar un único puesto de un ranking.
Precio de la API: 1 yuan de entrada y 4 yuanes de salida por millón de tokens en horario valle
Estos precios entraron en vigor el 10 de septiembre de 2026 a las 12:00, hora de Pekín. Los importes son los precios oficiales directos de DeepSeek en RMB, expresados en yuanes / millón de tokens, y no son los precios de este gateway. Página oficial de precios
| Concepto | Horario valle | Horario pico |
|---|---|---|
| Entrada: cache hit | ¥0.02 | ¥0.04 |
| Entrada: cache miss | ¥1.00 | ¥2.00 |
| Salida | ¥4.00 | ¥8.00 |
El horario pico es de lunes a viernes, 09:00—12:00 y 14:00—18:00, hora de Pekín. El resto es horario valle, incluidos los fines de semana. Usa estos intervalos explícitos y no apliques por tu cuenta una lógica de festivos o días laborables compensados.
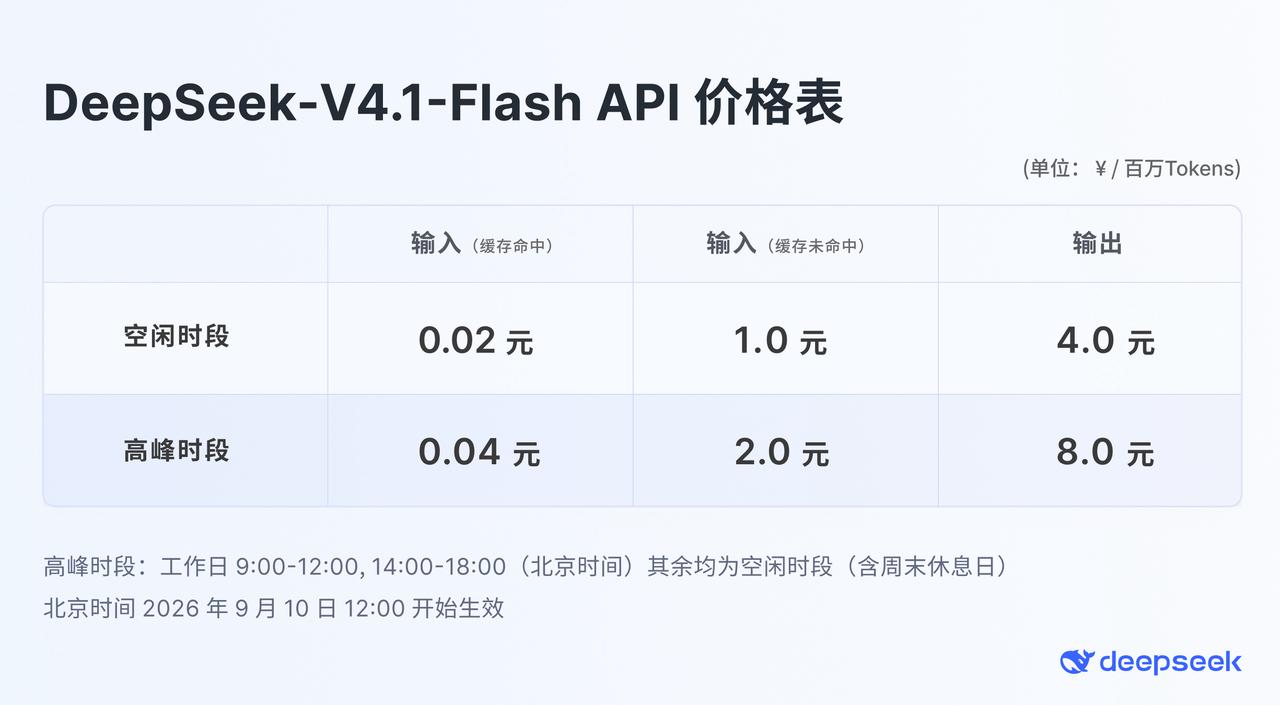
Fuente: anuncio oficial de DeepSeek, imagen sin modificar. Los precios pueden cambiar y los proveedores externos facturan por separado.
Ejemplo de factura de un agente que se puede recalcular
Supón que un lote de tareas usa 8 millones de tokens de entrada con cache hit, 2 millones de tokens de entrada con cache miss y 0,5 millones de tokens de salida, todo en el mismo horario:
Coste total = millones de entrada hit × precio hit
            + millones de entrada miss × precio miss
            + millones de salida × precio de salida

Horario valle: 8 × 0.02 + 2 × 1 + 0.5 × 4 = 4.16 yuanes
Horario pico: 8 × 0.04 + 2 × 2 + 0.5 × 8 = 8.32 yuanes
Los dos precios de entrada sí difieren 50 veces, pero eso no hace que toda la tarea sea 50 veces más barata. En el ejemplo, la parte de cache hit en valle cuesta solo 0,16 yuanes, mientras que la entrada sin caché y la salida cuestan 2 yuanes cada una. Optimiza el caché, pero vigila también las llamadas repetidas a herramientas, las salidas excesivas y los reintentos.
¿Por qué un KV Cache más pequeño importa más en sesiones largas?
El KV Cache guarda resultados intermedios del contexto. Para un agente que vuelve a leer el mismo repositorio, las instrucciones del sistema o el historial, reutilizar un prefijo idéntico reduce parte del cálculo repetido. V4.1 Flash comprime el KV Cache global a 890 bytes / token, aproximadamente una cuarta parte del de V4 Flash. Descripción oficial de la arquitectura
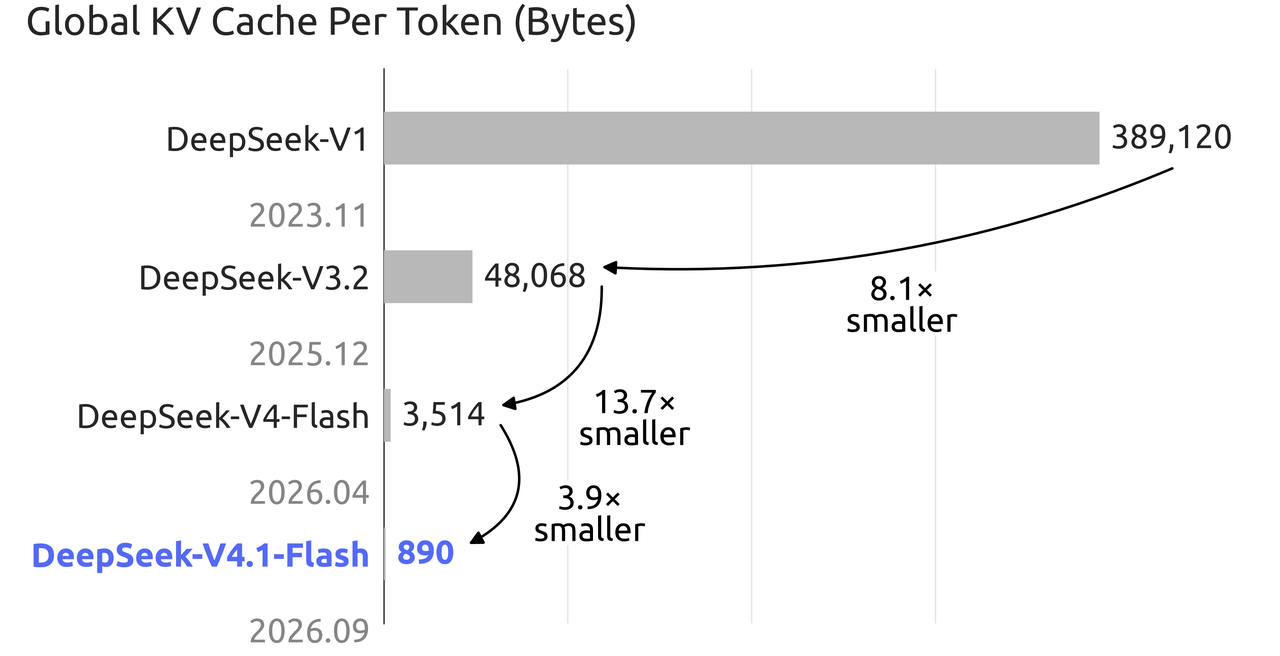
Fuente: anuncio oficial de DeepSeek, imagen sin modificar. La comparación es del KV Cache global por token, no de toda la VRAM del despliegue.
Hay que separar dos métricas de almacenamiento: DeepSeek indica que la demanda de HBM asociada al caché baja aproximadamente a 1/4 y la de SSD a 1/8. Esto describe recursos del caché, no los pesos completos, toda la memoria de ejecución ni el clúster entero.
Para una integración, mantén estables los prefijos reutilizables. Evita añadir en cada turno marcas de tiempo variables, identificadores aleatorios o listas de herramientas reordenadas. Después, comprueba los campos de uso reales para confirmar los hits. Que el contenido sea “parecido” no basta para prever un cache hit.
¿Cómo llamar a la API de DeepSeek V4.1 Flash?
Para una integración nueva usa el nombre oficial deepseek-flash. El siguiente es un ejemplo de texto para la API directa Chat Completions de DeepSeek; define antes DEEPSEEK_API_KEY en el terminal. El ejemplo no se ha validado como llamada de pago desde este sitio.
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {
        "role": "user",
        "content": "Enumera los pasos de implementación, los casos límite y los criterios de aceptación para una herramienta que renombre archivos Markdown por lotes."
      }
    ],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "high",
    "max_tokens": 2048,
    "stream": false
  }'
La respuesta esperada es JSON y el texto está en choices[0].message.content. Durante la verificación revisa el estado HTTP, el contenido y usage, no solo que la solicitud se haya enviado. Guía oficial de primera llamada
La visión nativa significa que el modelo entiende imágenes, no que las genere. Para procesar capturas, añade bloques de imagen en el mensaje siguiendo la guía oficial de comprensión de imágenes. Una solicitud de texto exitosa no sustituye las pruebas separadas de imagen, herramientas y streaming.
Si usas un gateway externo, revisa juntos Base URL, ID del modelo, autenticación y protocolos compatibles. Cambiar solamente la dirección oficial no garantiza las mismas capacidades ni el mismo comportamiento de facturación.
¿Siguen funcionando los modelos antiguos? ¿Cuándo cambia V4 Pro?
| ID configurado actualmente | Tratamiento oficial |
|---|---|
deepseek-flash |
Nombre recomendado para nuevas integraciones; llama a V4.1 Flash |
deepseek-v4-flash |
Modelo antiguo retirado; el nombre mantiene compatibilidad temporal y se enruta a V4.1 Flash |
deepseek-v4-flash-vision-exp |
Modelo antiguo retirado; el nombre mantiene compatibilidad temporal y se enruta a V4.1 Flash |
deepseek-v4-pro |
Después del 14 de septiembre de 2026 a las 12:00, hora de Pekín, y hasta el lanzamiento futuro de V4.1 Pro, todo se enruta a V4.1 Flash y se factura con el nuevo precio Flash |
Estas reglas proceden de las instrucciones oficiales de DeepSeek. Un gateway externo puede usar otros alias o un calendario diferente. Conservar el nombre antiguo no bloquea el modelo antiguo y no sirve como estrategia de vuelta a los pesos anteriores.
La migración puede hacerse en tres pasos: exporta primero los nombres de modelo y las solicitudes críticas actuales; después prueba con el nombre nuevo el texto, las imágenes, las herramientas y el uso del caché; por último revisa el modelo predeterminado del cliente, las plantillas de tareas y la facturación. Para tareas que deban ser reproducibles, registra la fecha, el proveedor real y la información devuelta, no solo un alias antiguo.
¿Qué cambia en DeepSeek Harness v0.1.5?
El modelo entiende y razona; Harness conecta archivos, comandos y herramientas para convertir la salida del modelo en tareas ejecutables. Con este lanzamiento, DeepSeek Harness pasa a v0.1.5 y el modelo se adapta a los modos estándar, Programmatic Tool Calling (PTC) y minimalista.
Según los materiales del lanzamiento, la nueva versión admite subir imágenes y PDF, árbol de archivos del espacio de trabajo y vista previa de artefactos; mejora la recuperación y navegación en sesiones largas; y refuerza la comunicación bidireccional entre agentes padre e hijo, los mensajes en cola y la intervención de tareas. Los Agent Teams experimentales pueden repartirse el trabajo mediante una lista compartida, pero están desactivados por defecto y consumen tokens adicionales.
En un sistema con Node.js, sigue las instrucciones del repositorio oficial:
npx @deepseek-ai/dsh web
En la interfaz web, introduce la clave API de DeepSeek, elige el espacio de trabajo y envía una tarea. El comando obtiene la versión del paquete disponible durante la ejecución y no fija automáticamente v0.1.5. Para reproducir un entorno histórico, registra también la versión realmente utilizada.
Empieza con una tarea pequeña y verificable:
Lee la documentación del proyecto en el espacio de trabajo actual y genera una guía de inicio en Markdown.
Especifica los comandos de arranque, la configuración necesaria y un paso mínimo de verificación.
Crea solo docs/getting-started-draft.md; no modifiques el código de negocio.
Al terminar, comprueba que existan las rutas mencionadas y enumera la información no confirmada.
El resultado esperado es un archivo Markdown que exista y pueda abrirse, no solo un “terminado” en el chat. Comprueba que el archivo se haya creado, que las rutas sean correctas y que los comandos tengan una fuente antes de ampliar la tarea. Para más configuración de clientes, consulta los tutoriales.
¿Se puede desplegar el modelo abierto en un ordenador normal?
No. No se puede deducir de que la entrada active solo 8B que baste con hardware de nivel 8B. El tronco de V4.1 Flash sigue teniendo 552B; el despliegue real depende también de la precisión de los pesos, el runtime, el caché, la concurrencia y el almacenamiento.
El modelo y sus pesos usan licencia MIT; las entradas son el repositorio oficial del modelo y el informe técnico. El anuncio menciona colaboraciones de despliegue a gran escala para equipos con unas 2000 GPU y recursos de clúster de almacenamiento; es una condición de colaboración, no una configuración mínima publicada.
Para equipos cuyo objetivo principal es crear una aplicación, ejecutar agentes o validar un caso de negocio, suele ser más útil medir primero la calidad y el coste mediante la API y evaluar después el autoalojamiento.
Preguntas frecuentes
¿DeepSeek V4.1 Flash tiene 550B o 552B?
La página oficial y la tarjeta del modelo usan 552B para el tamaño del tronco. 550B es una aproximación de algunas publicaciones; para tablas técnicas y evaluación de despliegue debe usarse la cifra oficial de 552B.
¿Cuál es el ID de API de V4.1 Flash?
DeepSeek recomienda deepseek-flash. No inventes deepseek-v4.1-flash a partir del nombre visible; aunque una plataforma externa use ese alias, no es el nombre de la API oficial directa.
¿Con 0,02 yuanes se compran un millón de tokens cualesquiera?
No. 0,02 yuanes por millón solo corresponde a la entrada con cache hit en horario valle. La entrada sin caché, la salida y el horario pico tienen precios distintos.
¿V4.1 Flash admite comprensión visual y generación de imágenes?
Admite texto e imágenes como entrada y genera texto, por lo que sirve para entender capturas y analizar gráficos. La tarjeta oficial no lo define como un modelo generador de imágenes.
¿V4 Pro ya se retiró por completo?
En la fecha de publicación de este artículo, el 10 de septiembre de 2026, DeepSeek había anunciado la transición después del 14 de septiembre a las 12:00; antes de esa fecha no debe escribirse que todo ya se había cambiado. Los dos modelos Flash antiguos sí estaban retirados y sus nombres solo conservaban compatibilidad temporal.
¿Este sitio cobra según los precios valle/pico de DeepSeek?
No debe suponerse. La tabla describe la API directa de DeepSeek; el ID, la disponibilidad y la facturación de este sitio se deben confirmar en los precios en tiempo real y en la factura real. Tras confirmar el modelo, comienza con una prueba pequeña desde la página de compra.
Conclusión: primero el coste total de la tarea, luego la ventana de migración
DeepSeek V4.1 Flash combina visión nativa, cálculo asimétrico y un caché de contexto más compacto. Para agentes con entradas largas y llamadas repetidas a herramientas, merece la pena validarlo con tareas reales. Para aplicaciones API existentes, lo más urgente es confirmar el cambio de ruta de los alias antiguos y la transición de Pro del 14 de septiembre.
El orden práctico es: confirmar el ID del modelo → validar con tus tareas → revisar el caché, la salida y la factura → actualizar la configuración. Así una publicación de modelo se convierte en una mejora utilizable y medible.
Fuentes
- Anuncio oficial de DeepSeek V4.1 Flash: fecha, arquitectura 552B, entrada en vigor del precio y migración.
- Tarjeta oficial del modelo DeepSeek V4.1 Flash: arquitectura CED, benchmarks, entorno de prueba, KV Cache y licencia MIT.
- Modelos y precios oficiales de DeepSeek: precios RMB valle/pico, contexto y límite de salida.
- Guía oficial de primera llamada de DeepSeek: ID actual, ejemplo de solicitud y nombres compatibles.
- Guía oficial de comprensión de imágenes de DeepSeek: capacidad y formato de entrada de imágenes.
- Repositorio oficial de DeepSeek Harness: método de inicio y estado de vista previa para desarrolladores.
- Material adicional del lanzamiento: artículo de WeChat 1, artículo de WeChat 2. El apartado sobre Harness v0.1.5 resume la información de esos materiales.
Fuentes comprobadas el 10 de septiembre de 2026. Este artículo interpreta la publicación y explica la integración; no es una evaluación independiente de rendimiento.